
 Анкетолог
 Typeform
 Тестограф
 Яндекс Формы
 Google Forms
 SurveyMonkey
 Oprosso
 Simpoll


Критерий Краскела–Уоллиса — это ранговый тест, который проверяет, различаются ли три независимые группы и больше.
 Алексей Логинов
Критерий Краскела–Уоллиса проверяет, различаются ли три группы и больше, и сравнивает их по рангам, то есть по местам в общем ряду. Это ранговая замена однофакторного дисперсионного анализа, и работает она там, где ANOVA спотыкается: на оценках по шкале, перекошенных данных и выбросах.
В программах его часто подписывают как H-тест, по букве статистики. Метод описали Уильям Краскел и Аллен Уоллис, их статья вышла в журнале Американской статистической ассоциации в 1952 году. Это тот же критерий Манна–Уитни, только для любого числа групп: на двух группах оба дают практически одинаковый p.
Если разница нашлась, её адрес ищут попарными сравнениями с поправкой на число пар.
Когда нужен Краскел–Уоллис
Метод сравнивает независимые группы: филиалы, тарифы, каналы обращения, возрастные категории. ANOVA делает то же через средние и рассчитывает на нормальное распределение внутри каждой группы. Рангам это не нужно, поэтому Краскел–Уоллис надёжнее в трёх случаях.
- Ответы по шкале. Оценка «4» лучше «3», но насколько, шкала не говорит, и среднее по таким числам спорно. Порядок при этом есть всегда.
- Длинный хвост или крайние значения. Одна единица среди девяток заметно тянет среднее вниз, а в общем ряду она всего лишь первая.
- Десяток ответов в группе. На таких числах нормальность не проверить: критерий Шапиро–Уилка почти ничего не видит.
Если одних и тех же людей спрашивают три раза и больше, например до изменений, сразу после и через месяц, нужен другой критерий, Фридмана: группы там связанные.
Как считается H
Пример: 45 клиентов оценили работу поддержки от 1 до 10. Шестнадцать писали в чат, четырнадцать звонили, пятнадцать обращались по почте.
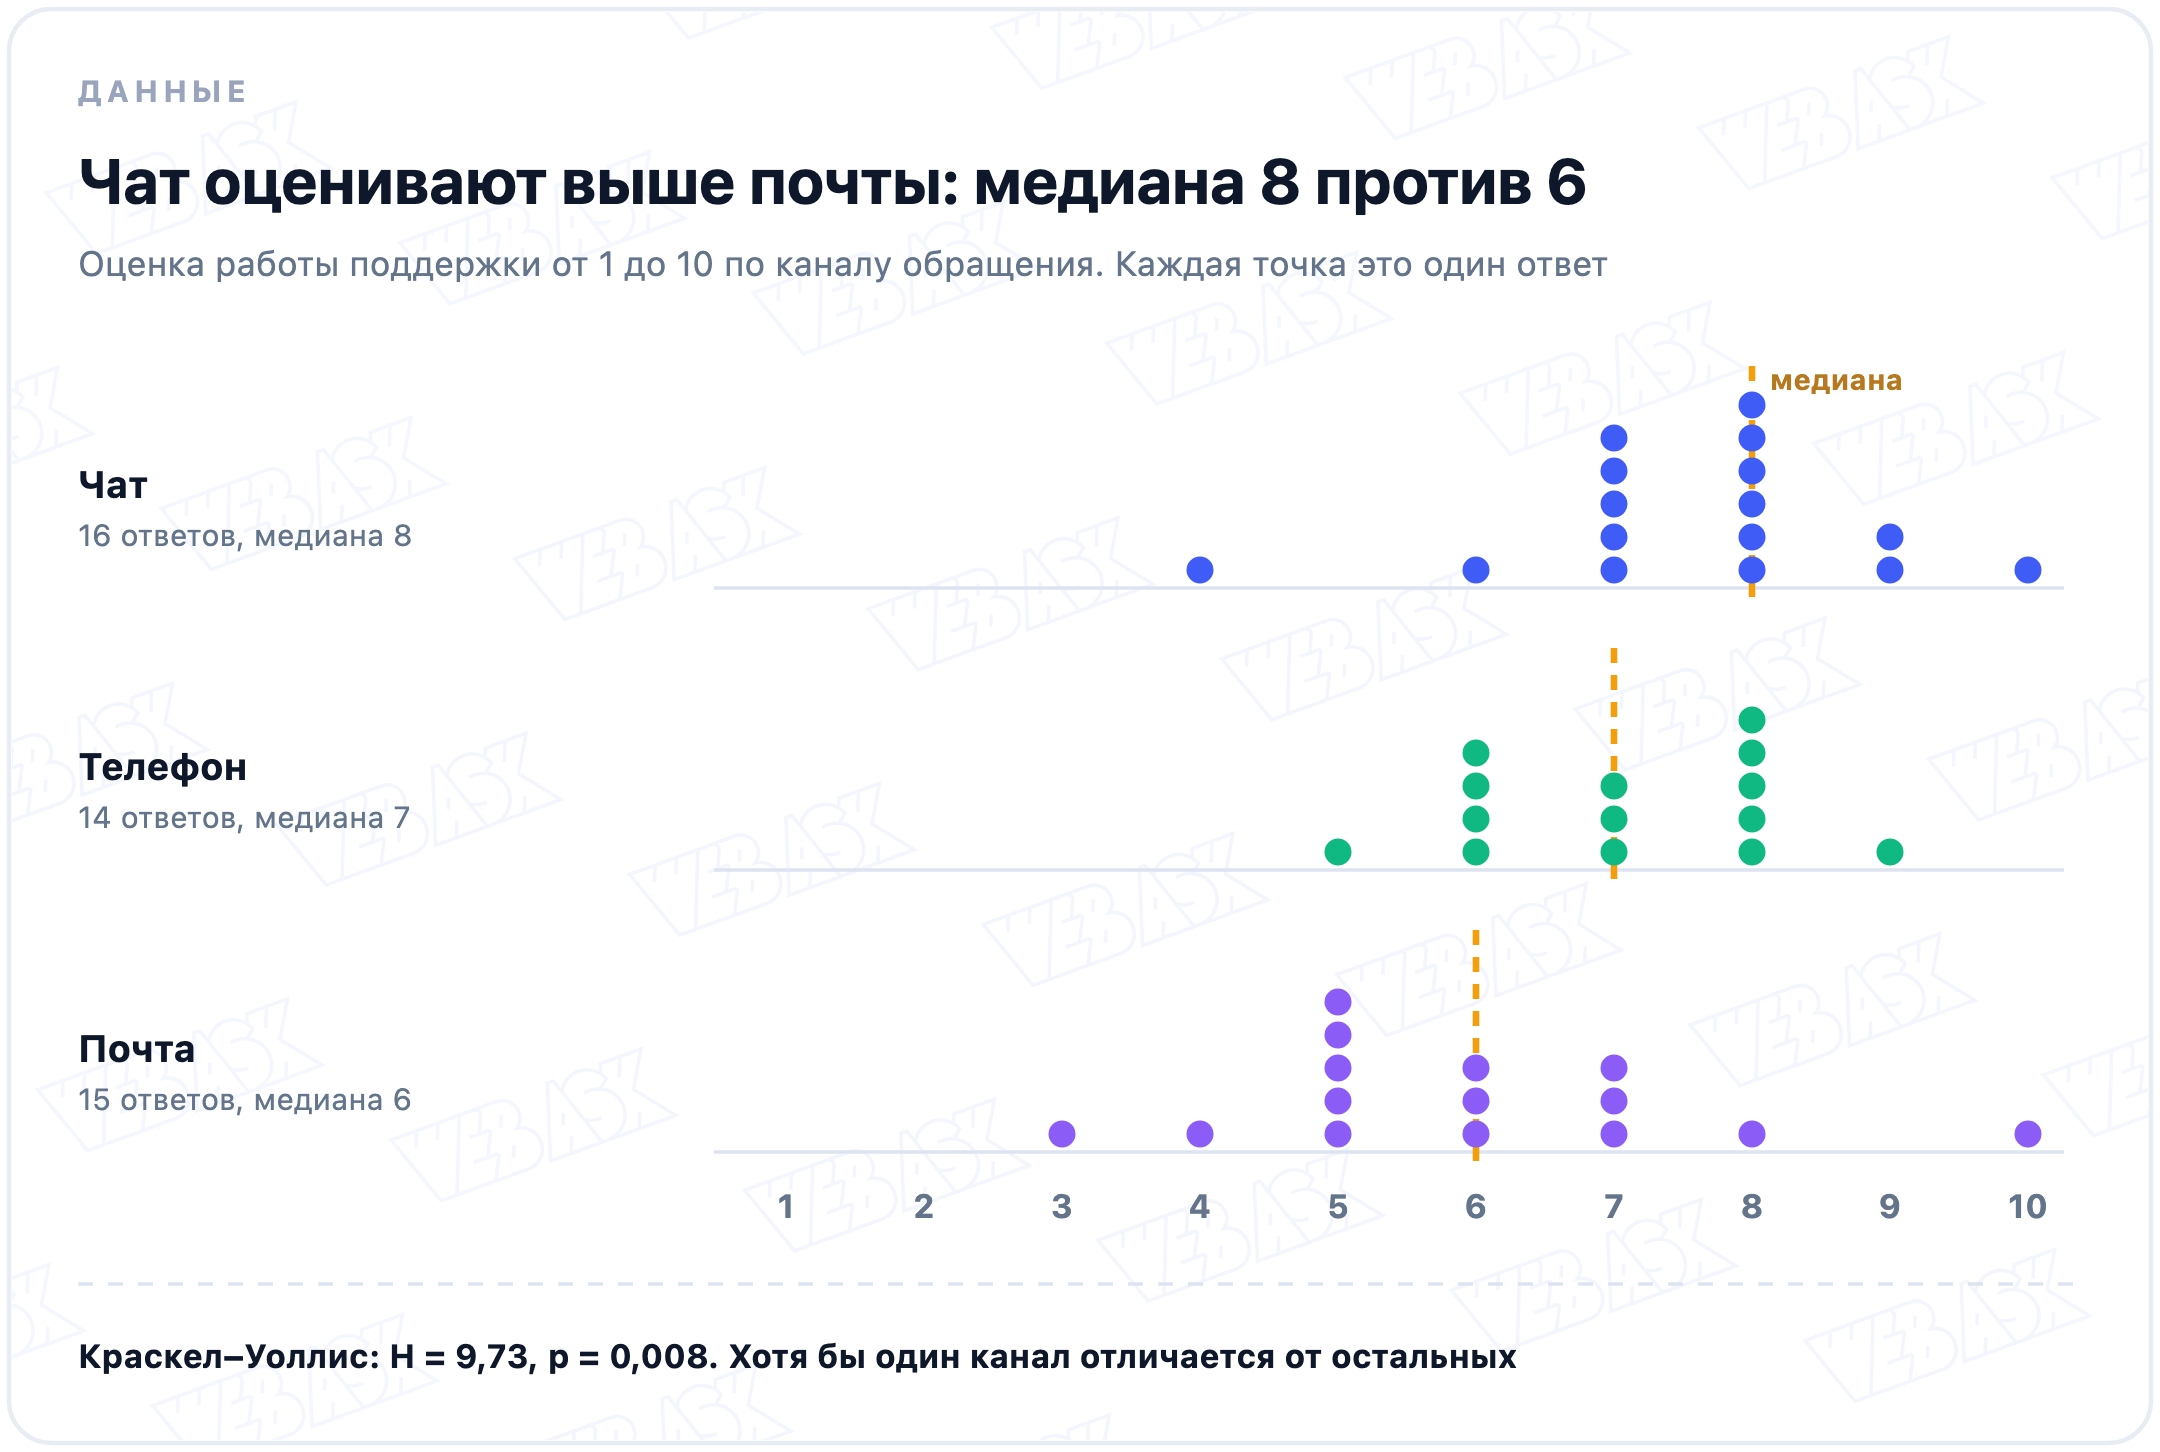
Медианы 8, 7 и 6, но группы сильно перекрываются: семёрки и восьмёрки ставили во всех трёх каналах. Похоже ли это на случайность, решает тест.
Сначала про группы забывают: все 45 оценок ставят в общий ряд по возрастанию, и у каждой появляется место, ранг. Одинаковые оценки делят места поровну: восьмёрок в ряду 12, они занимают места с 29-го по 40-е, и каждая получает ранг 34,5. Потом для каждой группы считают средний ранг.
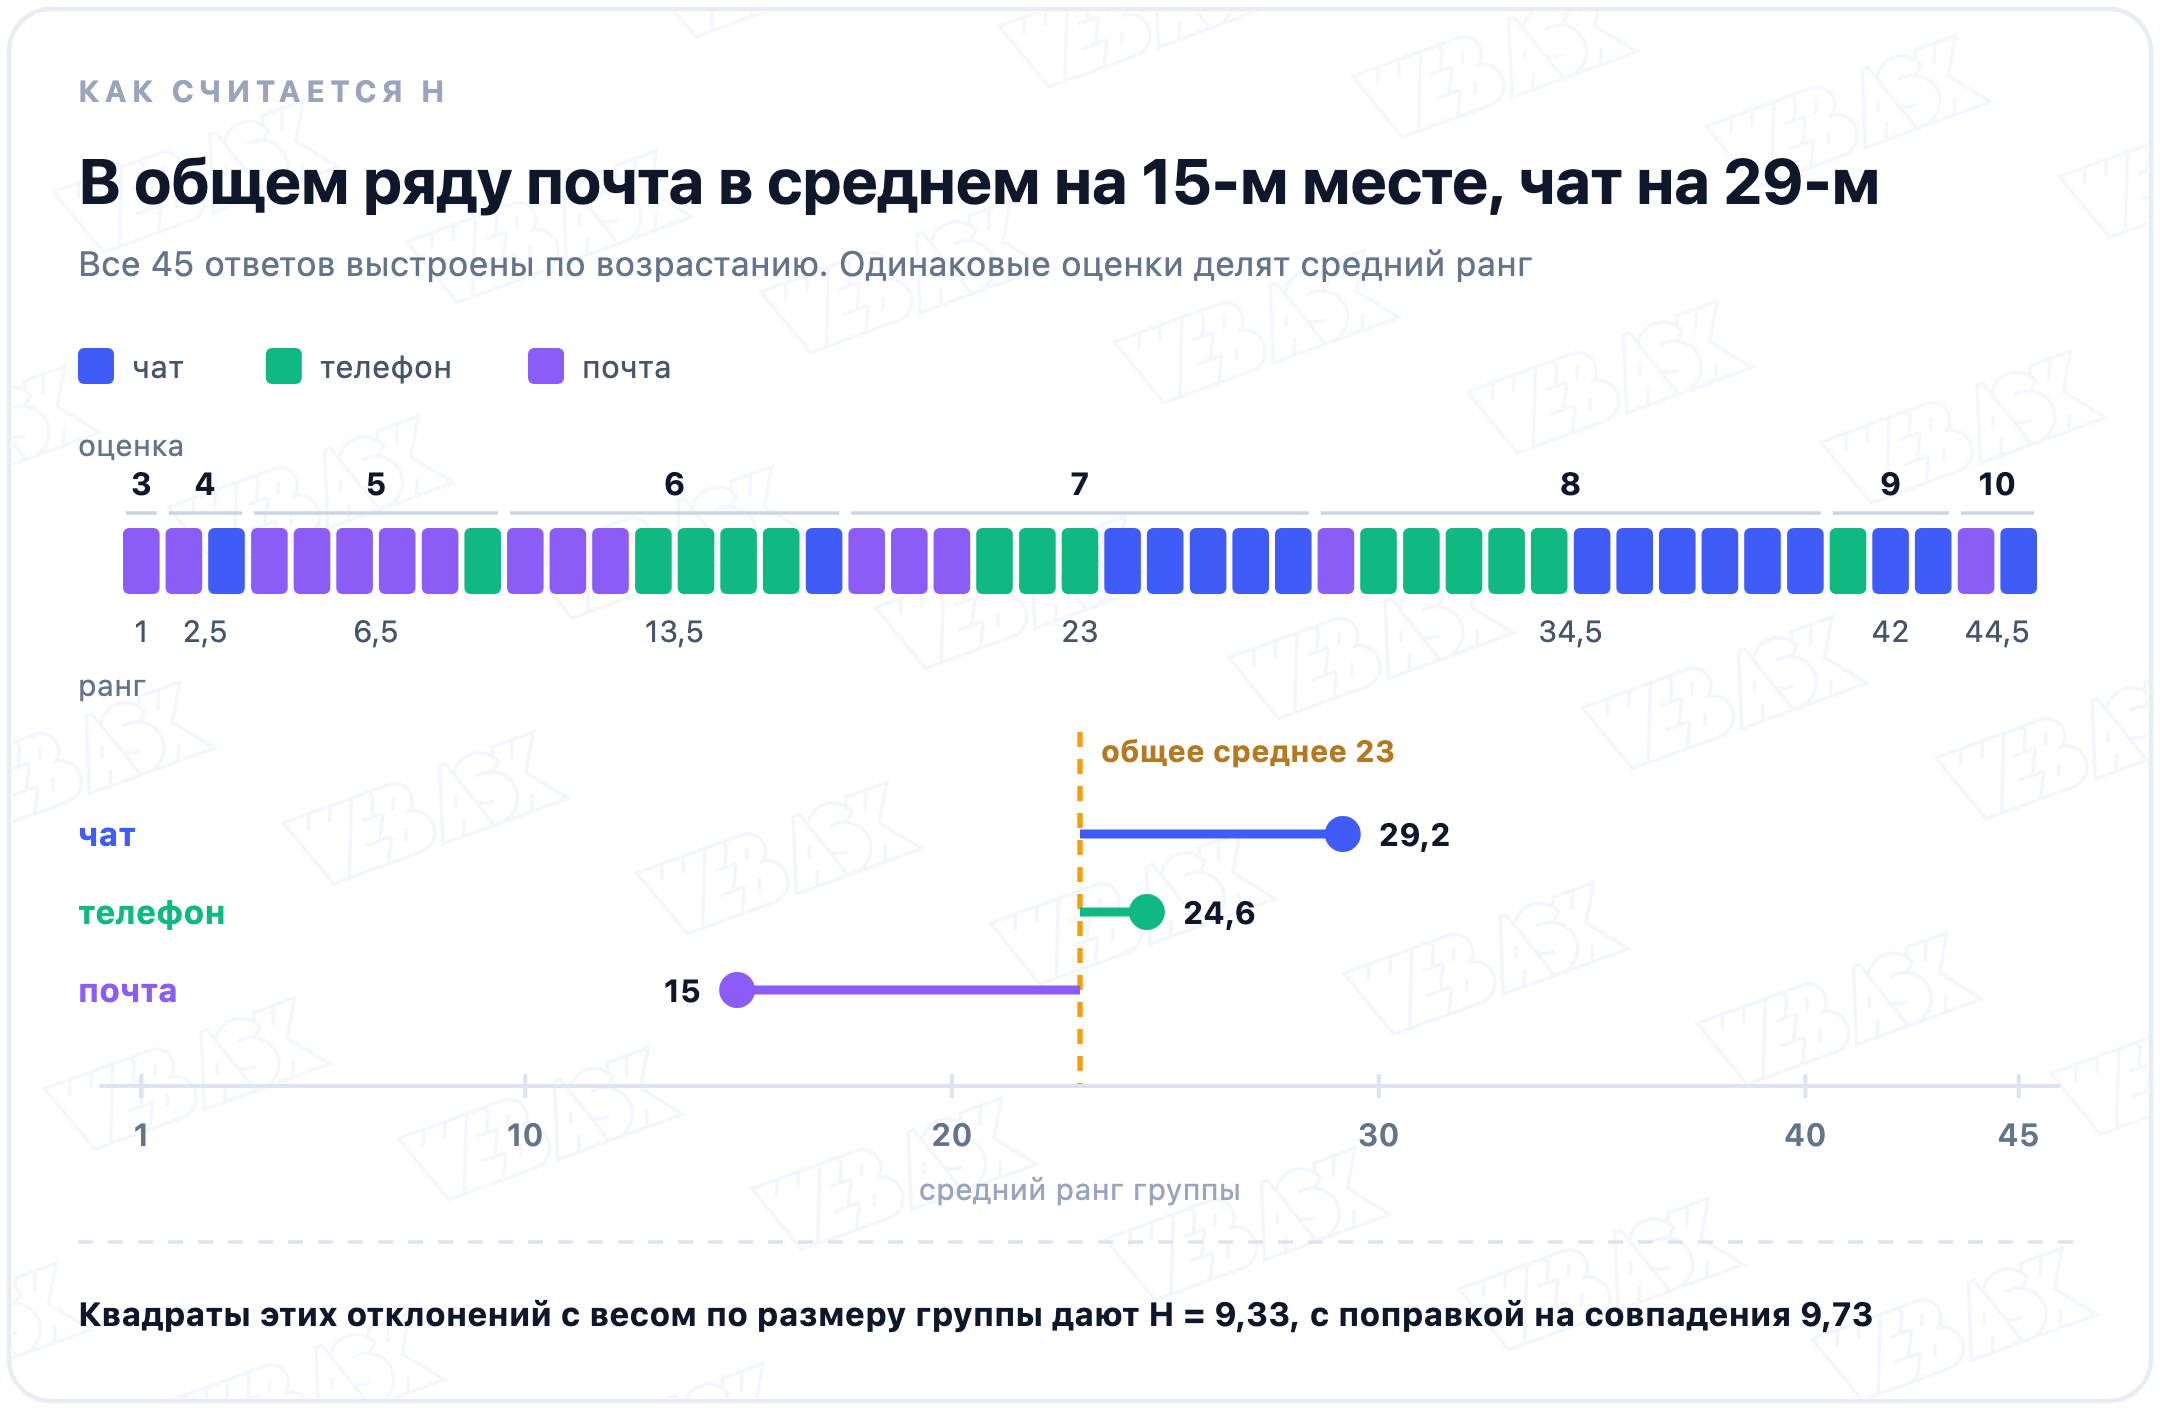
У чата средний ранг 29,2, у телефона 24,6, у почты 15. Если бы канал ни на что не влиял, все три держались бы около общего среднего (45 + 1) ÷ 2 = 23. H измеряет, насколько далеко они разошлись:
H = 12 ÷ (N × (N + 1)) × Σ (Ri² ÷ ni) − 3 × (N + 1), где N это все ответы, Ri сумма рангов группы, ni её размер.
Суммы рангов в примере 466,5, 344 и 224,5, отсюда H = 12 ÷ (45 × 46) × (466,5² ÷ 16 + 344² ÷ 14 + 224,5² ÷ 15) − 3 × 46 = 9,33. Одинаковых оценок много, поэтому H ещё делят на поправку на совпадения и получают 9,73. Статистические программы делают это сами.
Чтобы получить p, H сверяют с распределением хи-квадрат, у которого степеней свободы на одну меньше, чем групп. Для трёх групп порог на уровне 0,05 равен 5,99, у нас 9,73, и p = 0,008. Приближение работает, когда в каждой группе хотя бы пять ответов, для совсем маленьких групп есть таблицы точных значений.
Как читать результат
- p-value. p = 0,008 значит: если бы каналы не различались, такой разброс средних рангов выпадал бы реже чем в 1% случаев. Значимый H говорит, что хотя бы одна группа отличается от остальных, но не называет какая.
- Размер эффекта. Его считают как η²[H] = (H − k + 1) ÷ (N − k), где k число групп. В примере (9,73 − 3 + 1) ÷ (45 − 3) = 0,18. По условным границам Коэна 0,01 это мало, 0,06 средне, от 0,14 много, так что разница крупная. Про другие меры подробнее в карточке о размере эффекта.
- Медианы рядом с H. Команде понятнее «в чате медиана 8, на почте 6» и график с точками, чем H = 9,73.
На этих данных ANOVA тоже находит разницу, p = 0,009: крайних оценок почти нет, и оба критерия согласны. Расходятся они там, где есть перекос или выбросы.
Что делать, если разница нашлась
Какие именно каналы различаются, покажут попарные сравнения. Обычно берут тест Данна: он работает на тех же рангах. Каждый p умножают на число пар: это поправка Бонферрони, без неё случайные «находки» копятся.
| Пара | p | p × 3 |
|---|---|---|
| Чат и почта | 0,002 | 0,006 |
| Телефон и почта | 0,044 | 0,13 |
| Чат и телефон | 0,33 | 0,99 |
Уверенно различаются только чат и почта. Без поправки в отчёт попала бы ещё и разница телефона с почтой, а она вполне может оказаться случайной.
Почему не сравнить все пары сразу, минуя общий тест? Мы взяли группы из одного и того же распределения, то есть заведомо без разницы, и проверили каждую пару отдельным ранговым тестом.
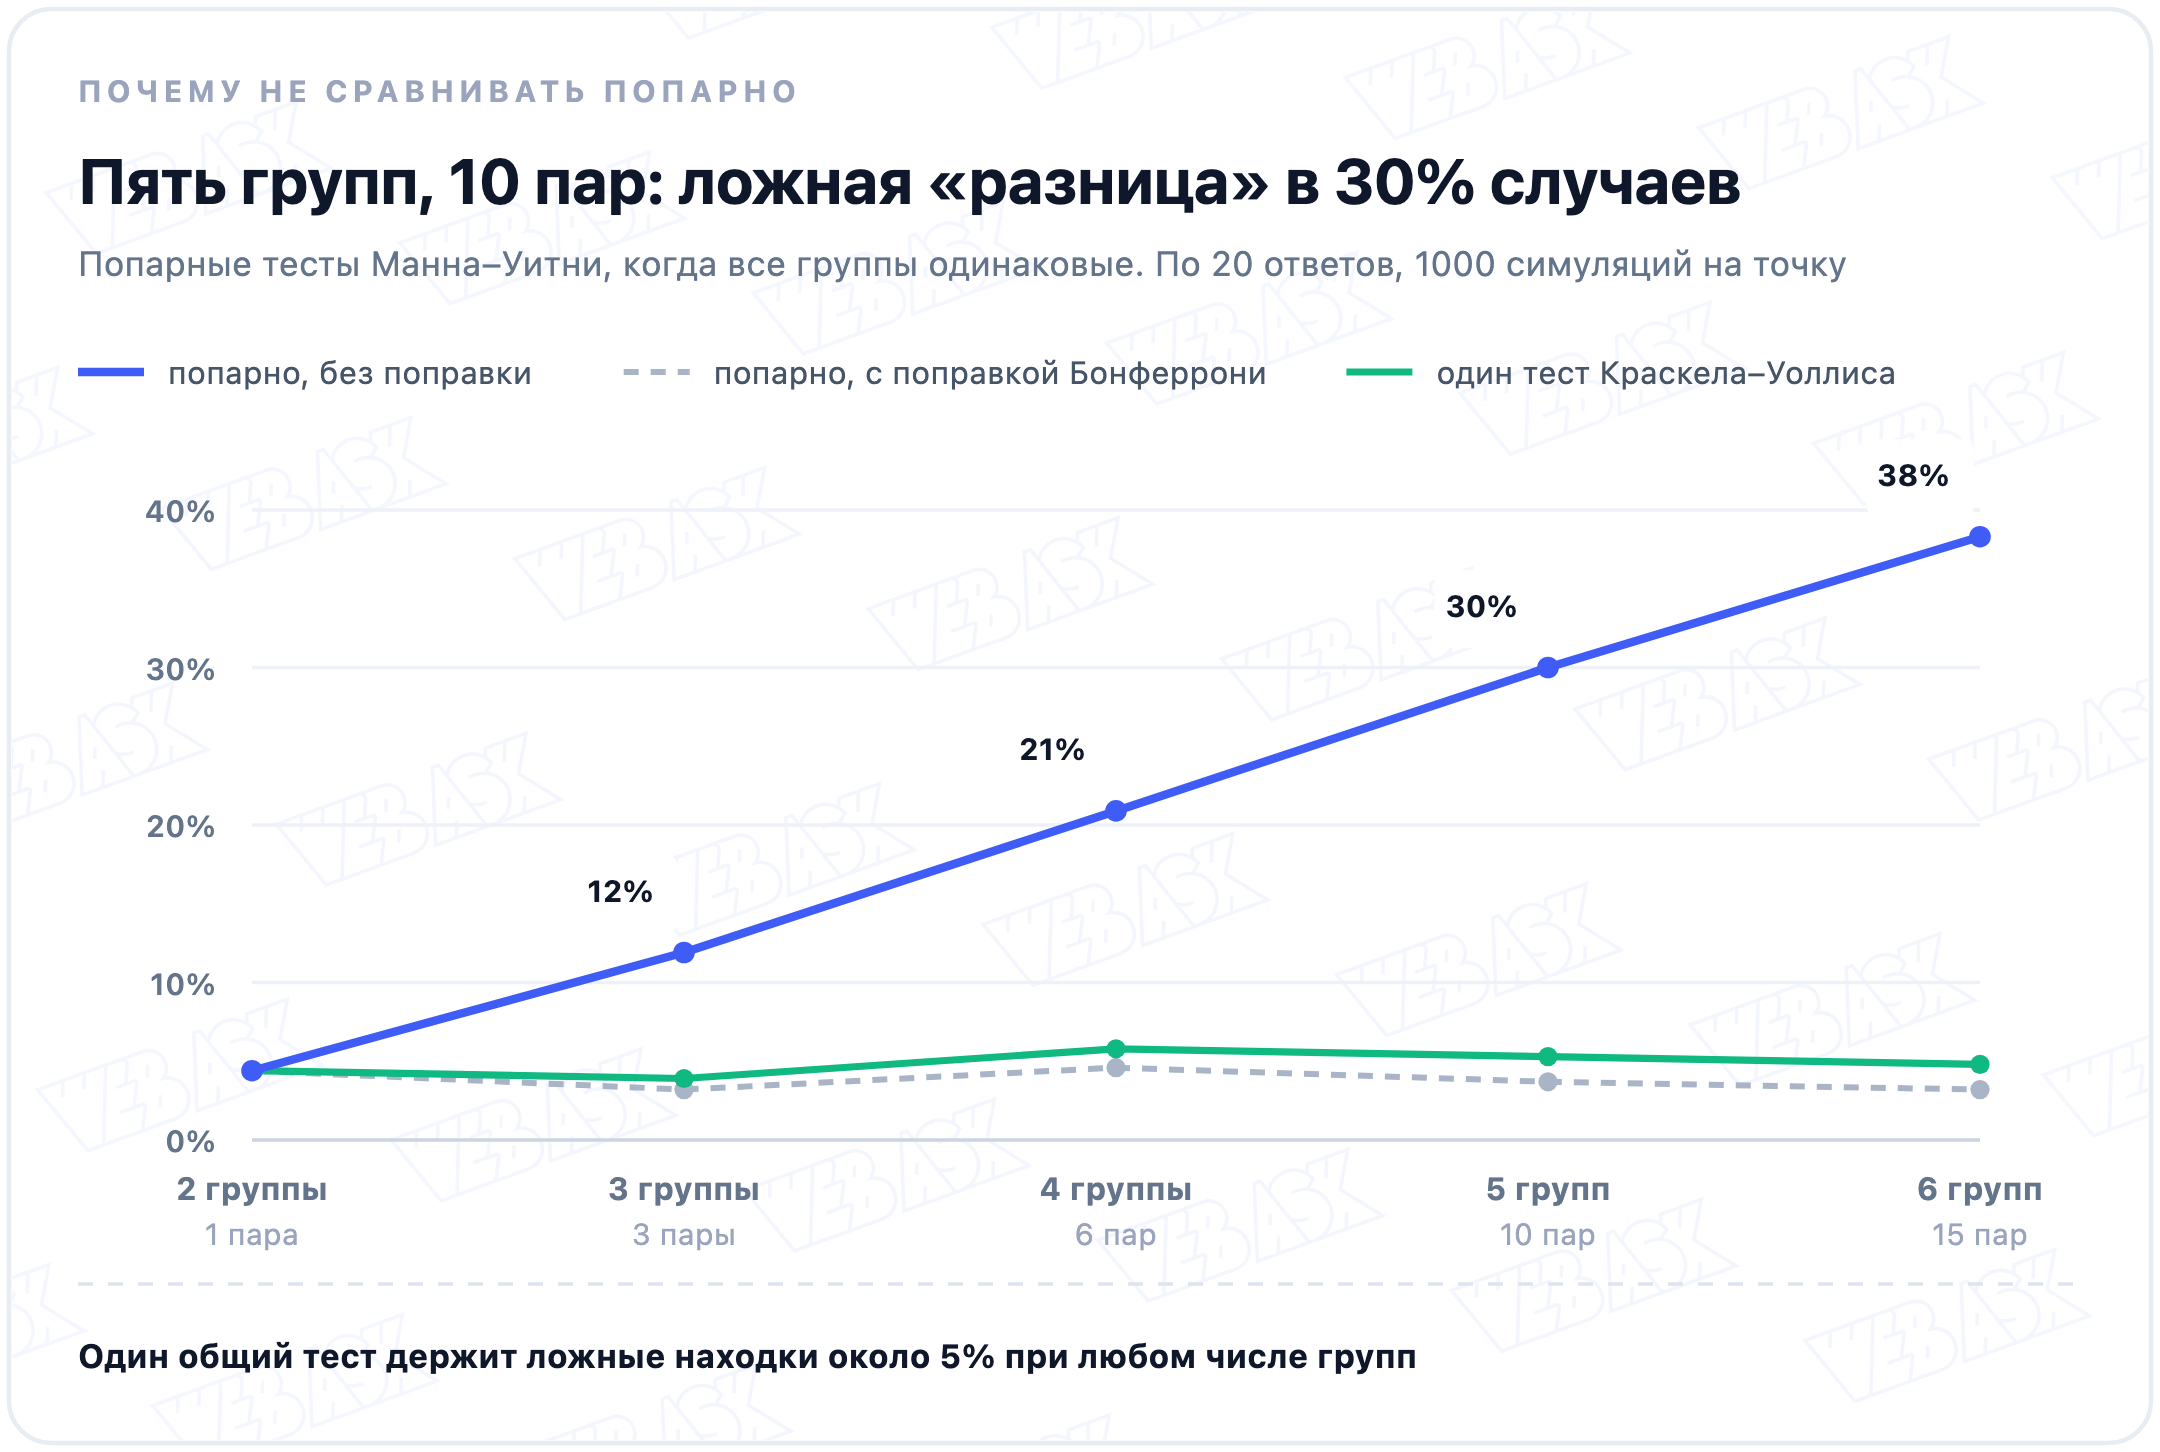
При трёх группах хотя бы одна «значимая» пара нашлась в 12% симуляций, при пяти в 30%, при шести в 38%. Один общий тест держался около 5% при любом числе групп, как и положено на уровне значимости 0,05. Поправка Бонферрони тоже возвращает попарные сравнения к этим 5%, но чем больше пар, тем она строже и тем легче пропустить настоящую разницу. Обычная схема: сначала общий тест, и только если он значим, пары с поправкой.
Чего H не показывает
- Какая группа выделяется. H один на все группы сразу, адрес разницы он не называет.
- Порядок групп. Стаж до года, от года до трёх, больше трёх лет: если ждут роста от группы к группе, Краскел–Уоллис этого не учтёт. Для такой проверки чувствительнее критерий тенденций Джонкира–Терпстры.
- Разницу медиан. H говорит, что ранги одних групп выше, чем у других. Медианами это можно назвать, только если распределения похожи по форме.
- Причины. Почему почтой довольны меньше, подскажут открытые ответы.
Частые ошибки
- Все пары сравнивают сразу, без общего теста и поправки. При пяти группах ложная разница всплывает почти в каждом третьем таком исследовании.
- Одних и тех же людей считают разными группами. Если каждый респондент оценил три варианта сам, группы связанные, и нужен критерий Фридмана.
- Три-четыре ответа в группе. Приближение хи-квадрат рассчитано на пять ответов и больше, да и мощности на таких числах почти нет.
- Отчёт из одной строки «H = 9,73, p = 0,008». Без размера эффекта и сравнения пар команда не поймёт, что с этим делать.
Как это сделано в WebAsk
В WebAsk H не считается, это делают в статистической программе. Опрос даёт для расчёта всё нужное: вопрос с оценкой и вопрос-разрез с тремя вариантами и больше, например «Как вы обращались в поддержку?». Фильтр по разрезу в отчёте покажет, как распределились оценки в каждой группе, а сырые ответы забирают выгрузкой в XLSX, CSV или SPSS.
- SPSS. Analyze → Nonparametric Tests → Independent Samples. Там же включаются сравнения пар, скорректированный p стоит в столбце Adj. Sig.
- R. Функция
kruskal.test, ей передают формулу вида «оценка ~ канал». - Python. Функция
scipy.stats.kruskal: ответы каждой группы идут отдельным списком, поправку на совпадения она вносит сама.
Автопоиск значимых различий между сегментами WebAsk сравнивает средние. Если сегментов три и больше, а шкала порядковая, найденную разницу стоит перепроверить Краскелом–Уоллисом.
Коротко
- Критерий Краскела–Уоллиса сравнивает по рангам три и больше независимых групп, нормальность ему не нужна.
- Годится для оценок по шкале, перекошенных данных и маленьких групп.
- H показывает, насколько средние ранги групп разошлись с общим средним. Его сравнивают с хи-квадрат с числом степеней свободы на одну меньше числа групп.
- Значимый H говорит, что какая-то группа отличается, но не какая. Это покажут сравнения пар с поправкой.
- Для повторных замеров на тех же людях есть критерий Фридмана.
- Рядом с H и p показывают медианы и размер эффекта.
Вопросы и ответы
Что такое критерий Краскела–Уоллиса?
Это непараметрический тест для трёх и больше независимых групп. Все значения он переводит в места общего ряда и проверяет, не оказываются ли одни группы систематически выше других. Его берут для оценок по шкале и данных с перекосом или выбросами, нормальности он не требует.
Когда применять критерий Краскела–Уоллиса вместо дисперсионного анализа?
Если ответы порядковые (оценки от 1 до 10, «редко, иногда, часто»), если в данных перекос или выбросы, если в группах по десятку ответов. На больших группах с числовыми данными без выбросов ANOVA работает не хуже и показывает разницу средних в рублях или минутах.
Как рассчитать H-критерий Краскела–Уоллиса?
Все значения из всех групп сортируют по возрастанию и нумеруют местами, при совпадениях каждому достаётся среднее место. Затем для каждой группы суммируют ранги и подставляют суммы в формулу H = 12 ÷ (N × (N + 1)) × Σ (R² ÷ n) − 3 × (N + 1). Если одинаковых значений много, H делят на поправку на совпадения, программы делают это сами.
Что делать, если критерий Краскела–Уоллиса показал значимую разницу?
Провести попарные сравнения, например тестом Данна, и поправить p на число пар методом Бонферрони или Холма. Значимый H говорит только, что какая-то группа отличается, а какая именно, показывают эти сравнения.
Что показывает H в критерии Краскела–Уоллиса?
H показывает, насколько средние ранги групп разошлись с общим средним рангом, с весом по размеру групп. Если разницы нет, H в среднем близок к числу групп минус один, у трёх групп это 2. Чем H больше, тем меньше p, для трёх групп порог значимости на уровне 0,05 равен 5,99.
Сколько нужно наблюдений для критерия Краскела–Уоллиса?
Обычное правило: приближение хи-квадрат работает от пяти наблюдений в группе, для меньших групп p берут из таблиц точных значений. Но минимум для расчёта и объём для вывода не одно и то же: умеренную разницу видно только на десятках ответов в каждой группе, а на трёх-пяти тест почти всегда промолчит.
Как посчитать критерий Краскела–Уоллиса?
Проще всего в статистической программе: в SPSS пункт Nonparametric Tests → Independent Samples, в R функция kruskal.test, в Python scipy.stats.kruskal. В Excel готовой функции нет, H придётся считать по формуле вручную. Данные опроса WebAsk отдаёт выгрузкой в XLSX или CSV.
Опубликовано 29 сентября 2026