
 Анкетолог
 Typeform
 Тестограф
 Яндекс Формы
 Google Forms
 SurveyMonkey
 Oprosso
 Simpoll


Критерий Манна–Уитни — это непараметрический тест для сравнения двух независимых групп, которому важен только порядок значений.
 Алексей Логинов
Критерий Манна–Уитни проверяет, различаются ли две независимые группы, и смотрит при этом только на порядок значений. Поэтому он подходит для оценок от 1 до 5, мест в рейтинге и данных с выбросами, а нормальное распределение ему не нужно.
Его ещё называют U-критерием и критерием Уилкоксона–Манна–Уитни. Фрэнк Уилкоксон предложил сравнивать суммы рангов в 1945 году, а Генри Манн и Дональд Уитни развили метод в статье 1947 года.
Для двух замеров на одних и тех же людях он не подходит: там нужен критерий знаковых рангов Уилкоксона.
Когда брать Манна–Уитни, а когда t-тест
Оба критерия сравнивают две независимые группы, но смотрят на разное. t-тест сравнивает средние и опирается на то, что расстояния между значениями имеют смысл. Манну–Уитни хватает порядка: кто выше, кто ниже.
- Оценки по шкале, места, ответы «плохо, нормально, хорошо». Расстояние между «3» и «4» на шкале Лайкерта не обязано равняться расстоянию между «4» и «5», поэтому среднее по таким ответам спорно. Здесь Манн–Уитни естественнее.
- Маленькие группы с перекосом или выбросами. Несколько крайних значений тянут среднее и раздувают разброс, и t-тест теряет чувствительность. На рангах выброс это просто последнее место.
- Большие группы с числовыми данными без выбросов. Тут t-тест работает, и его результат нагляднее: разница средних в рублях или минутах.
Для связанных выборок, когда одних и тех же людей спрашивают дважды, нужен другой ранговый метод, критерий знаковых рангов Уилкоксона. Для трёх групп и больше есть критерий Краскела–Уоллиса.
Как считается U
Берут каждую пару «один ответ из первой группы, один из второй» и смотрят, кто выше. U это число пар, где выше вторая группа, плюс половина ничьих.
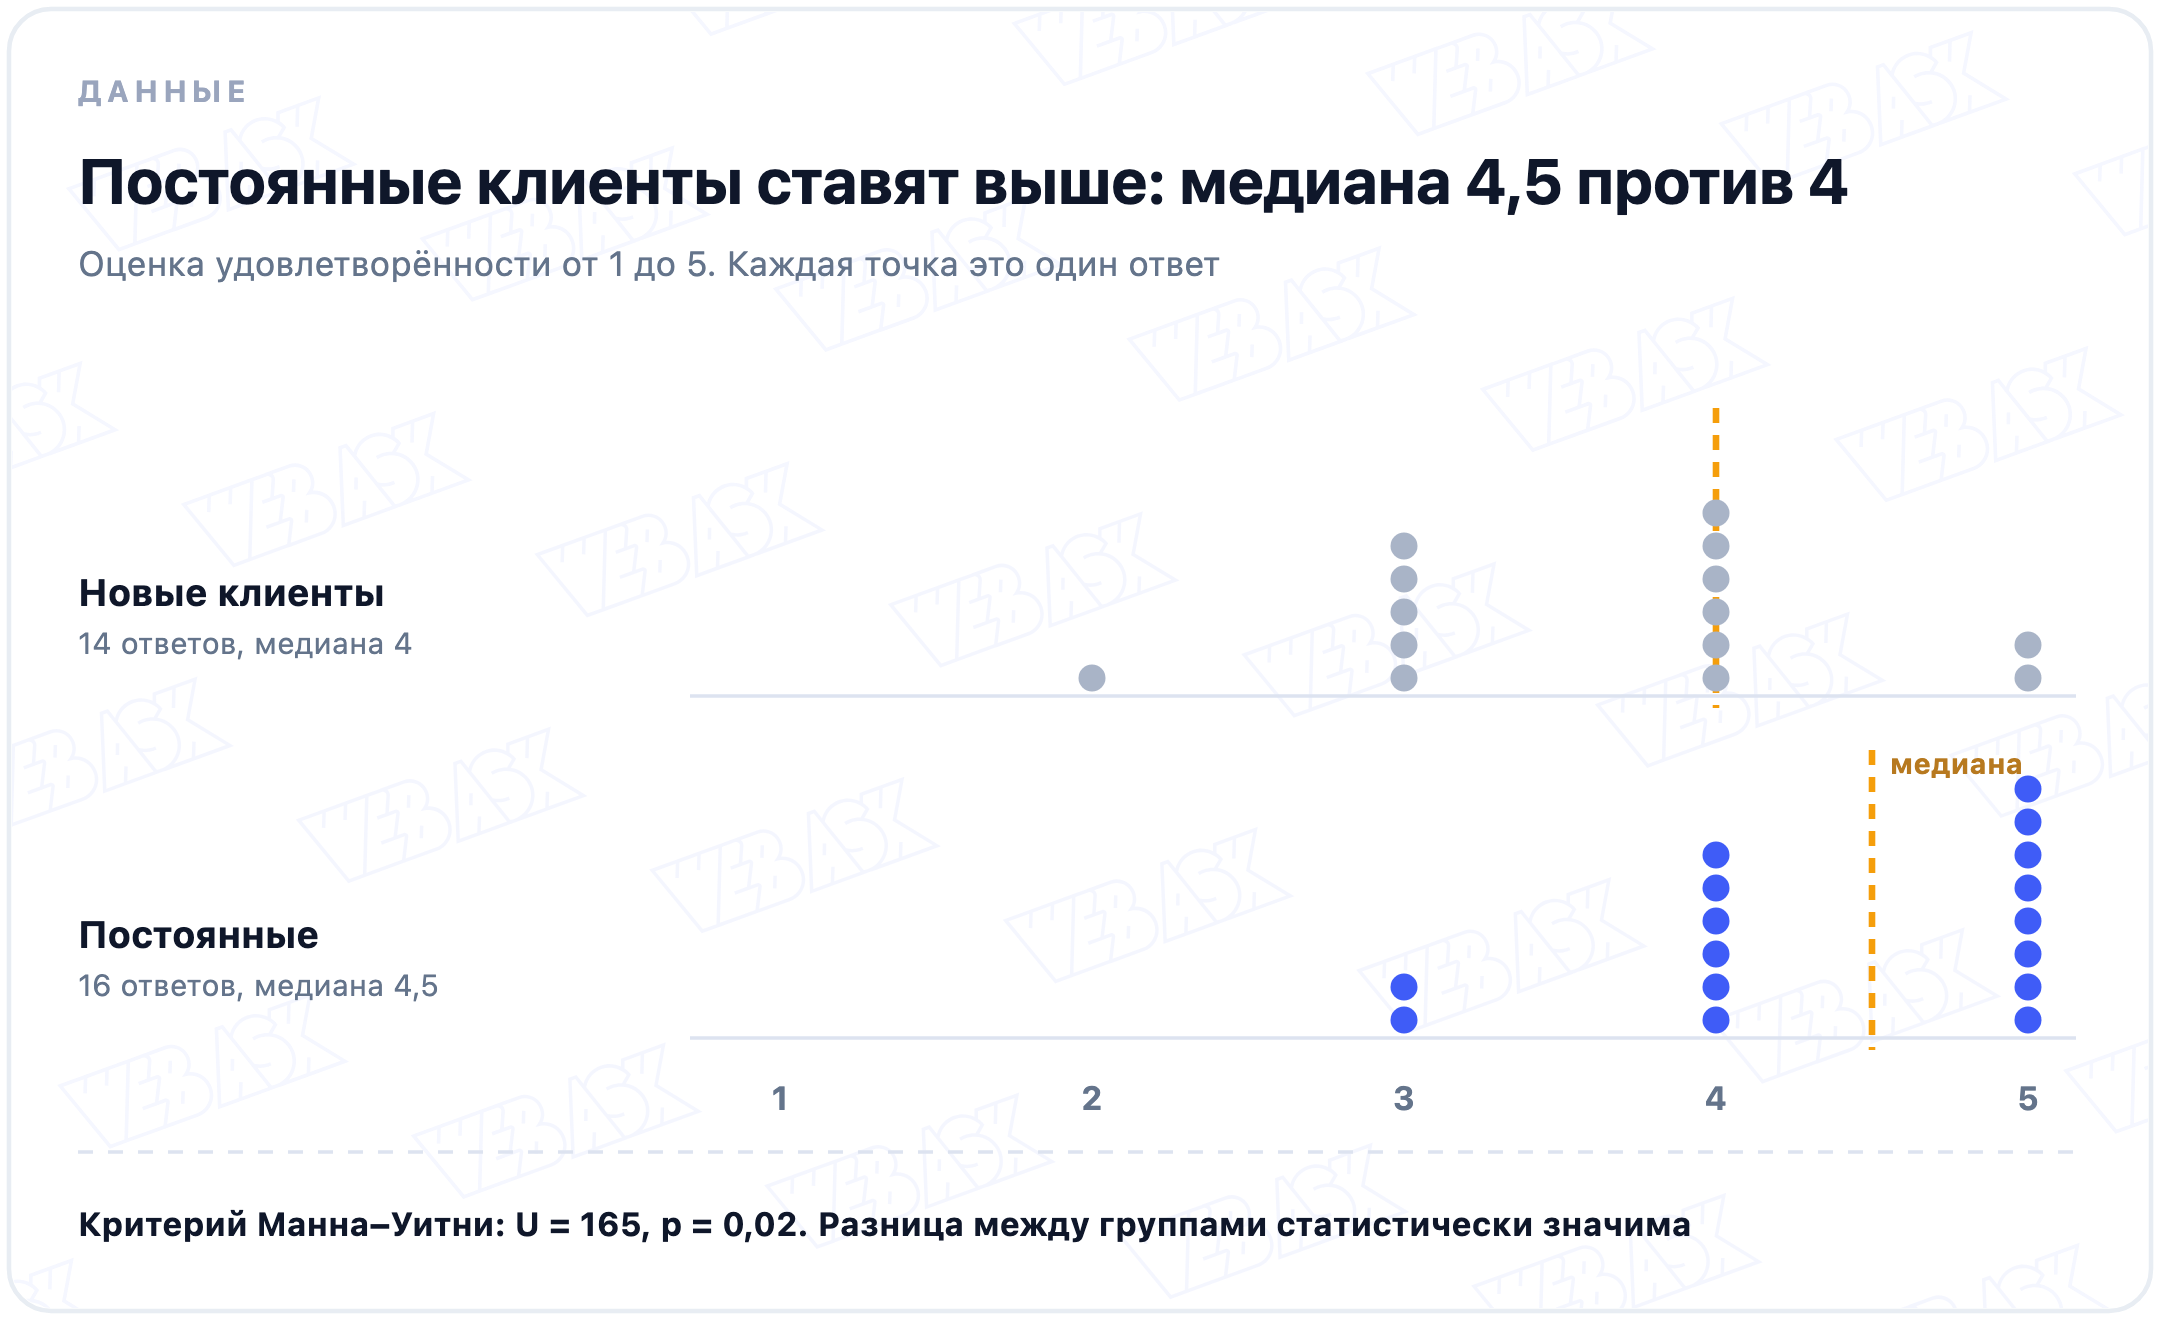
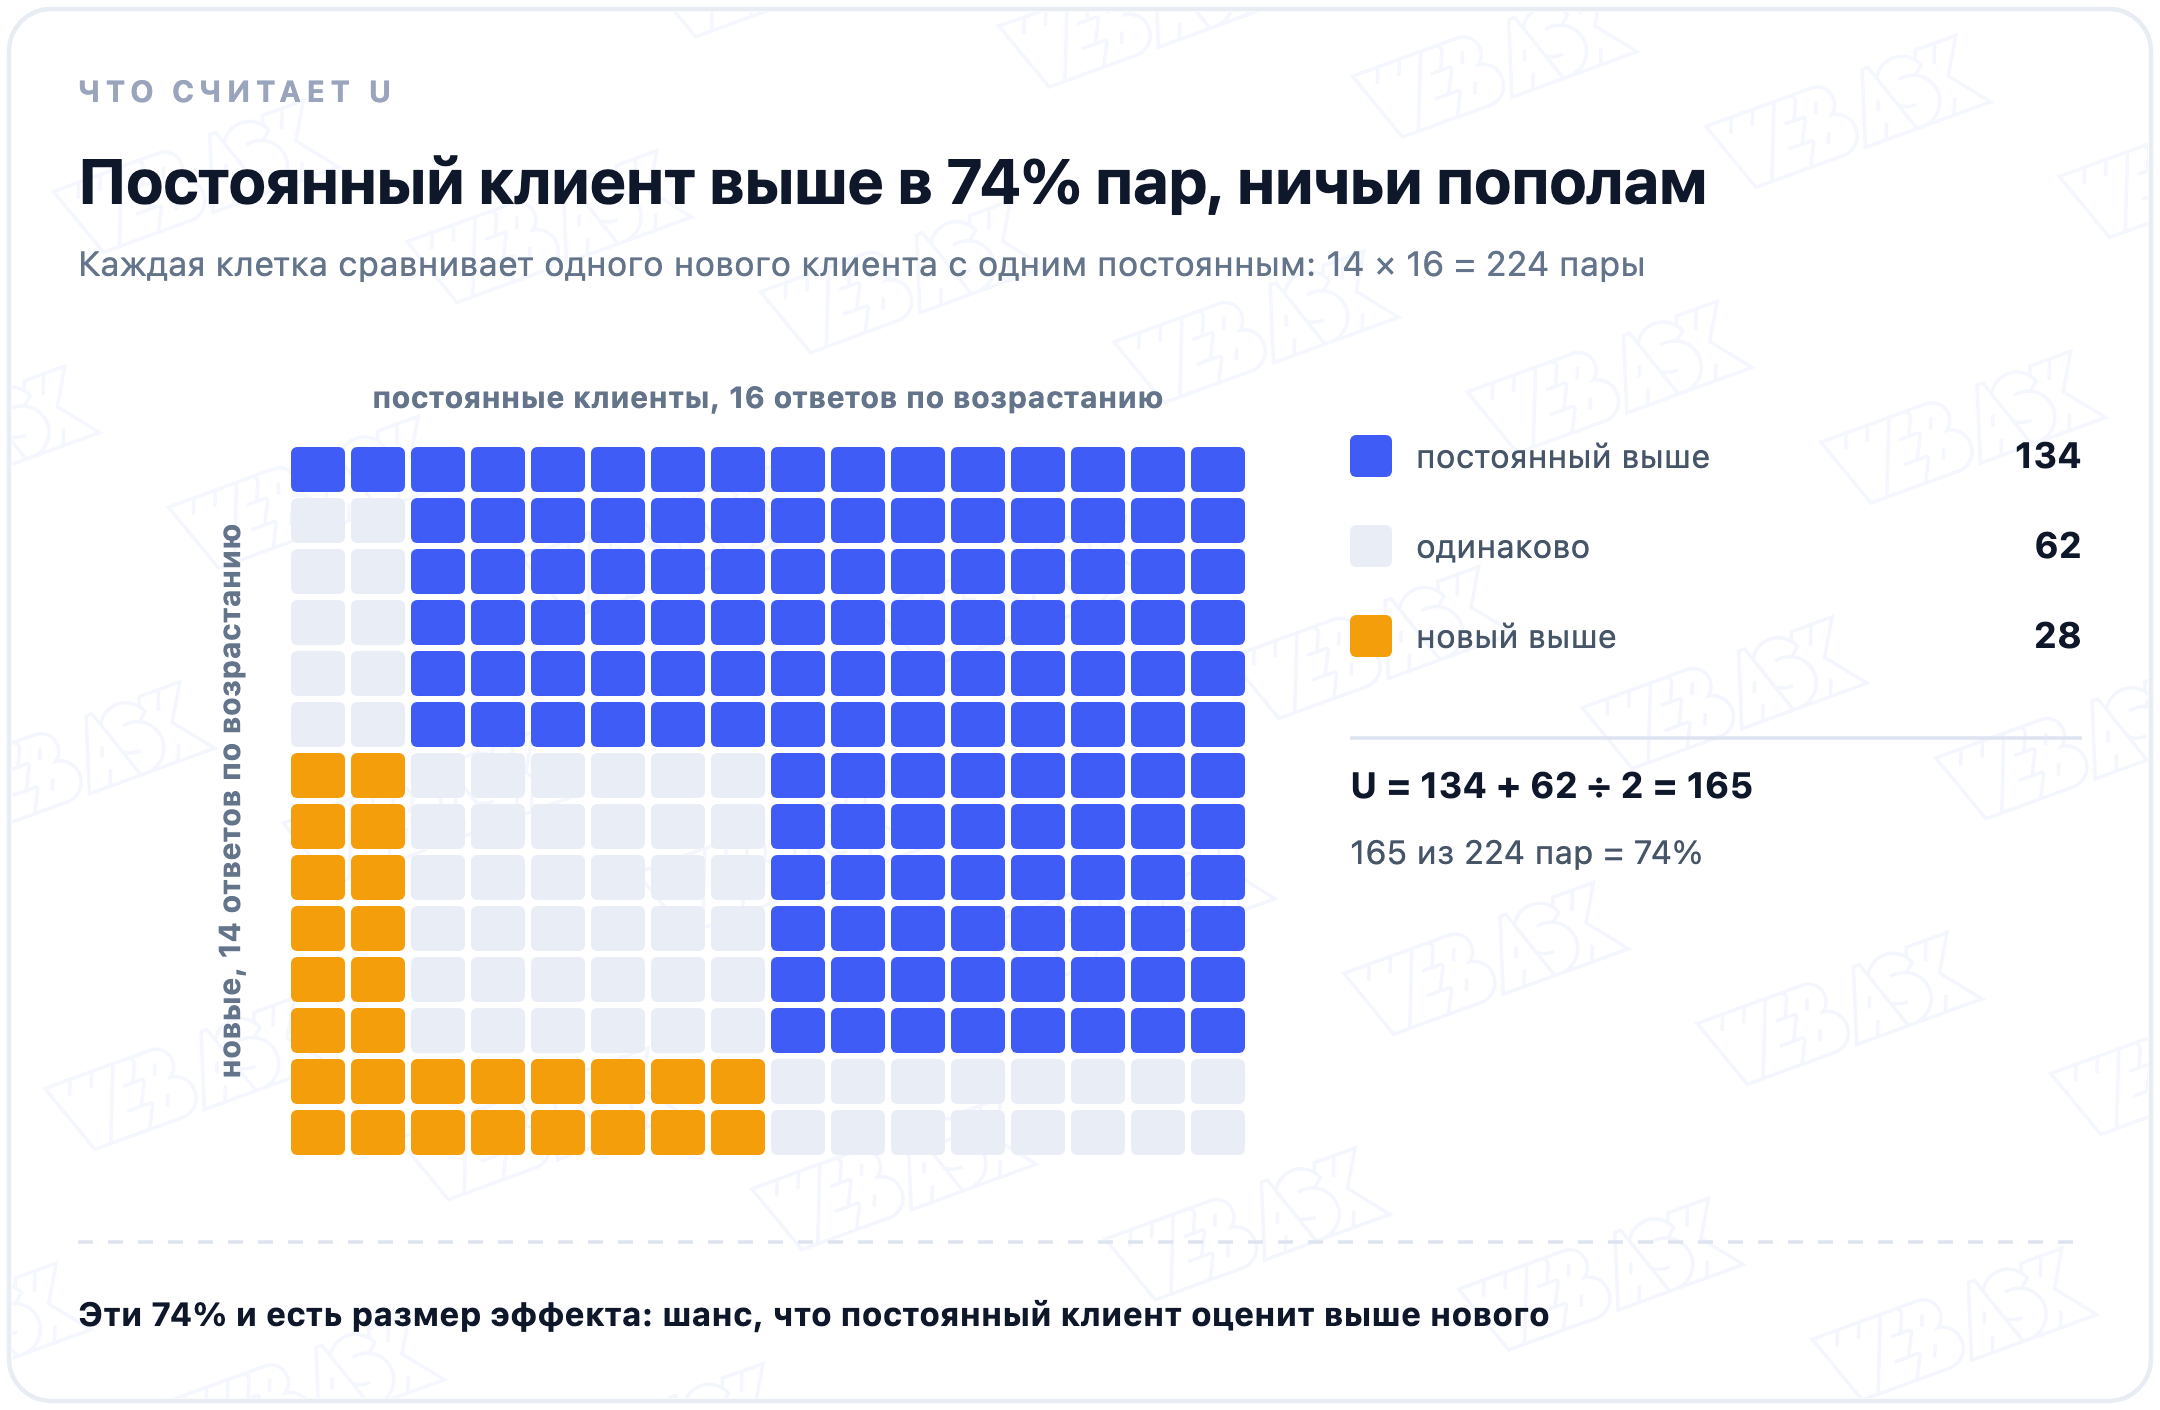
В примере 14 новых и 16 постоянных клиентов оценили сервис от 1 до 5. Пар получается 14 × 16 = 224. В 134 парах постоянный клиент поставил больше, в 62 оценки совпали, в 28 выше оказался новый. U = 134 + 62 ÷ 2 = 165.
Вручную пары не перебирают, U получают через ранги. Все ответы выстраивают в один ряд, одинаковым значениям дают средний ранг, складывают ранги одной группы и вычитают минимально возможную сумму:
U = R − n × (n + 1) ÷ 2, где R это сумма рангов группы, а n её размер.
Ответы «4» у обеих групп занимают в общем ряду места с 9-го по 20-е, поэтому каждый получает средний ранг 14,5. У постоянных клиентов сумма рангов выходит 301, отсюда U = 301 − 16 × 17 ÷ 2 = 165, то же число, что и при переборе пар.
Дальше U сравнивают с тем, каким он был бы без разницы между группами: половина пар, 112. Для маленьких групп есть таблицы критических значений, для больших U переводят в z через нормальное приближение с поправкой на одинаковые ответы. В примере p = 0,02: если бы группы не различались, такая или ещё большая разница выпадала бы примерно в 2% случаев.
Как читать результат
- p-value. Показывает, насколько правдоподобна такая разница, если на самом деле группы не различаются. Маленькое p это повод считать разницу реальной, но не мера её величины.
- Размер эффекта. Для Манна–Уитни его удобнее всего читать как долю пар: U ÷ (n₁ × n₂). В примере 165 ÷ 224 = 74%: случайно выбранный постоянный клиент в 74% случаев оценит сервис выше нового, если ничью считать за половину. 50% означало бы, что разницы нет. Другие меры описаны в карточке про размер эффекта.
- Сами распределения. «Медиана 4,5 против 4» и картинка с точками скажут команде больше, чем U = 165. Их показывают рядом с p.
Когда t-тест и Манн–Уитни расходятся
На ровных данных оба критерия обычно согласны: в примере с оценками t-тест Уэлча даёт почти то же p. Расходятся они, когда в данных есть выбросы.
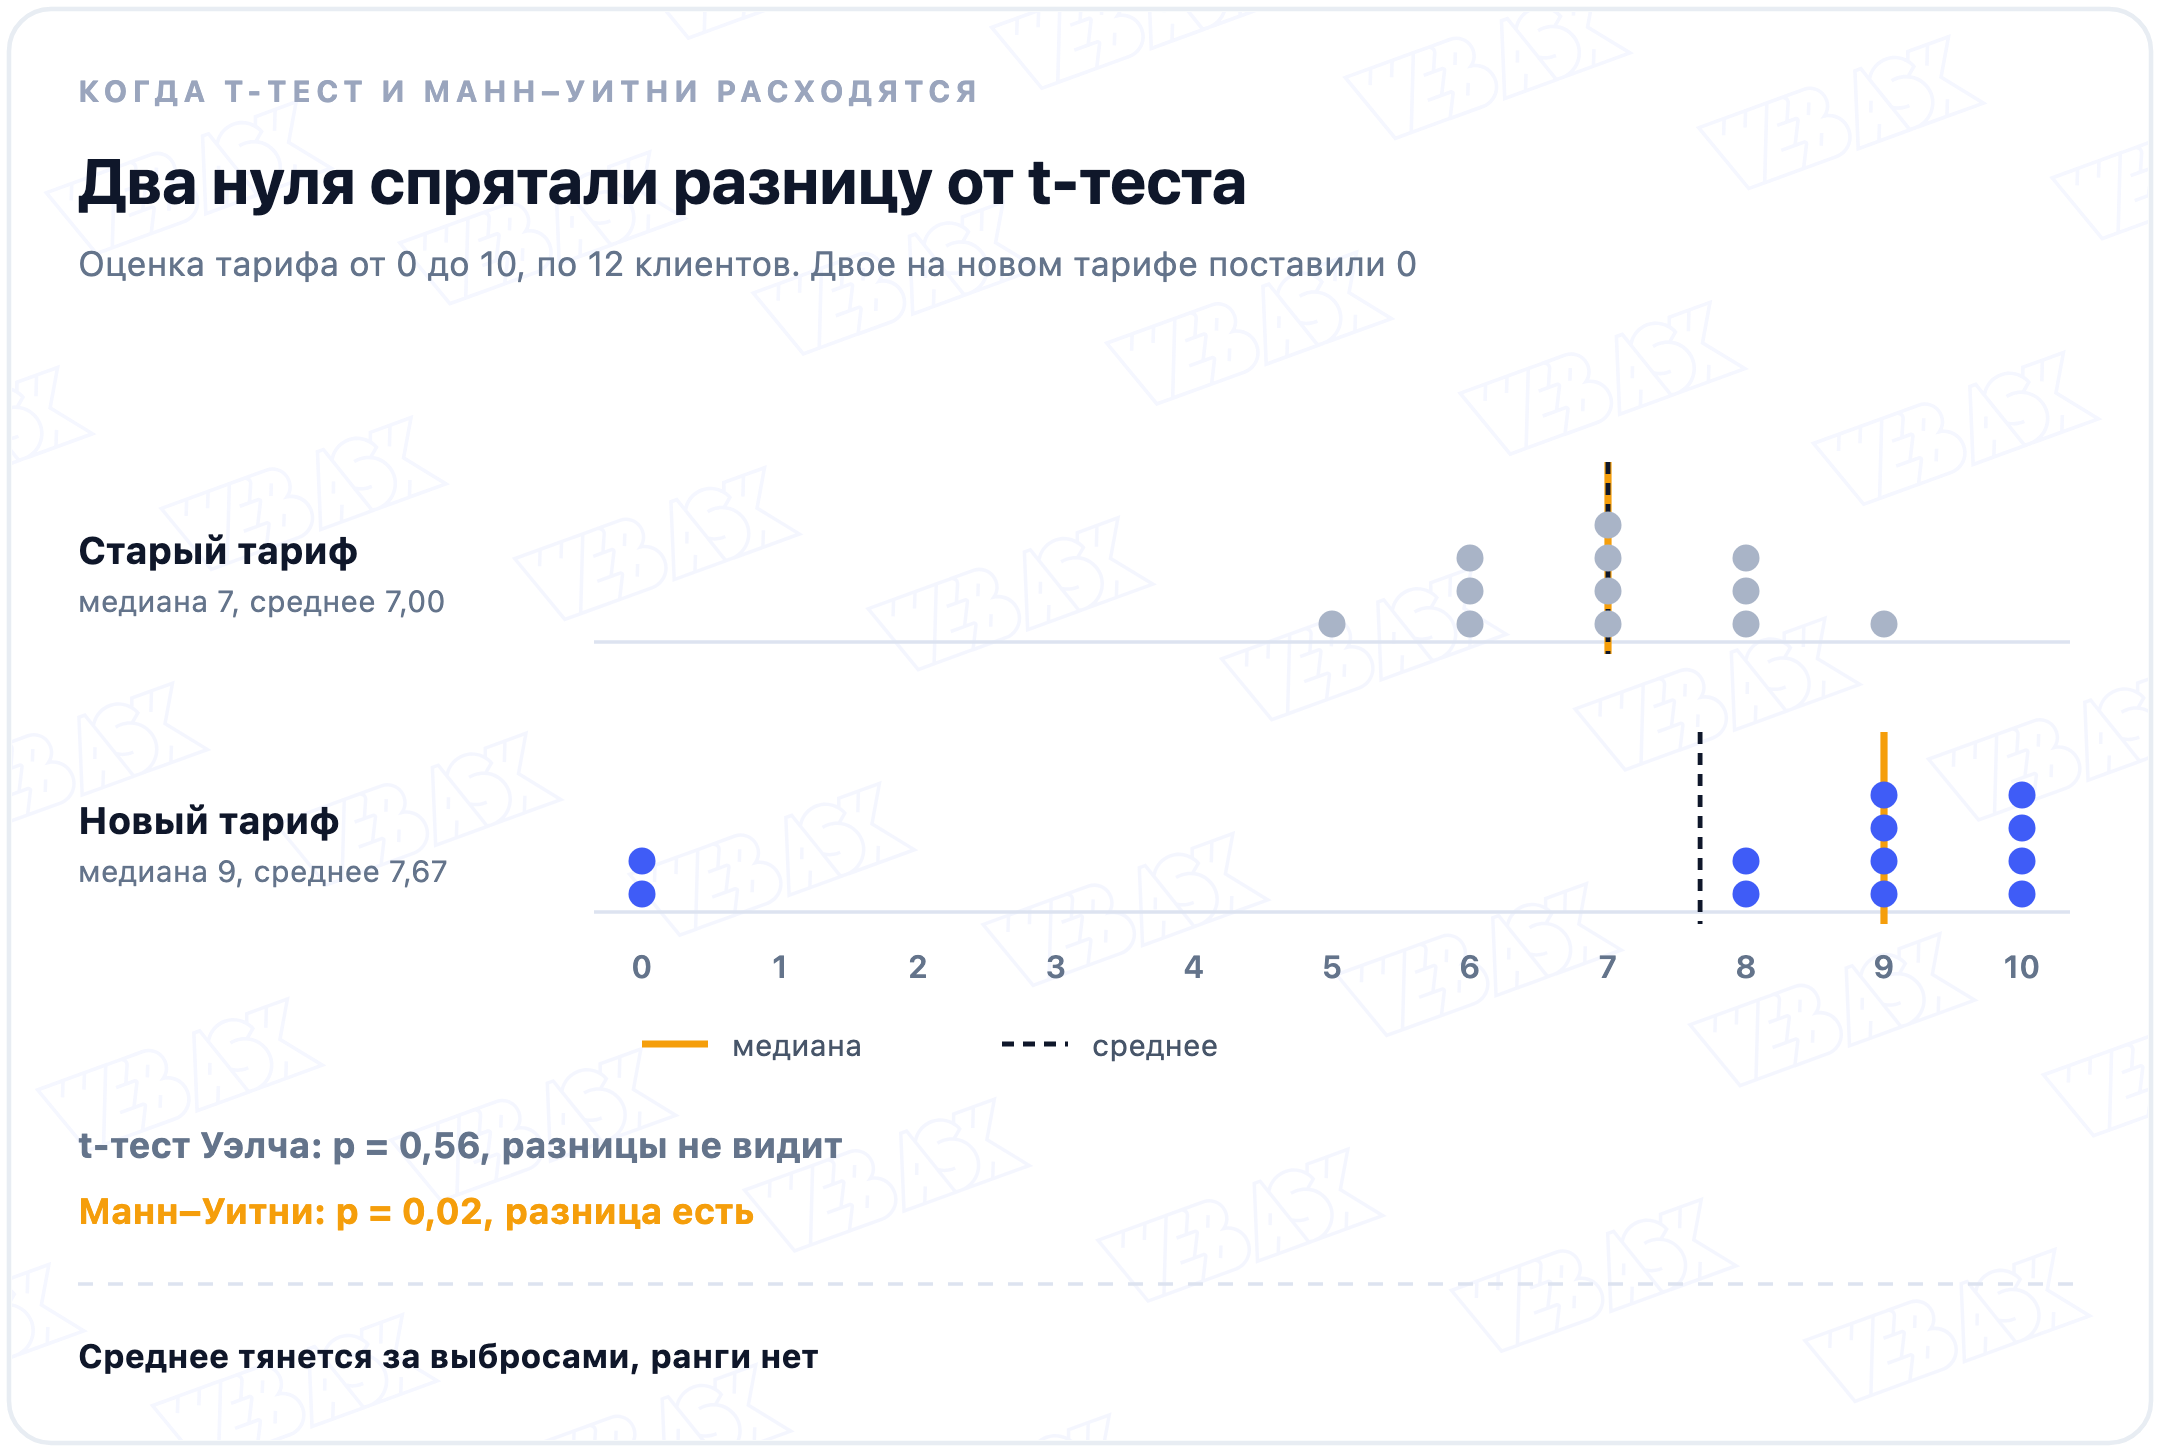
Двенадцать клиентов старого тарифа поставили от 5 до 9, медиана 7. У нового тарифа медиана 9, но двое поставили 0. Эти два нуля утянули среднее нового тарифа вниз, до 7,67 против 7,00 у старого, и раздули разброс. t-тест разницы не видит: p = 0,56. Для Манна–Уитни нули остаются двумя последними местами в ряду, не больше, и он показывает, что новый тариф оценивают выше: p = 0,02.
Выбрасывать нули из-за этого не надо. Двое недовольных клиентов нового тарифа тоже результат, и с ними стоит поговорить отдельно.
Чего критерий не показывает
- Разницу медиан в чистом виде. Манн–Уитни проверяет, какая группа чаще оказывается выше. Сравнением медиан его можно считать, только если распределения похожи по форме и просто сдвинуты друг относительно друга.
- Насколько велика разница. Для этого рядом с p нужны размер эффекта и медианы.
- Причины. Критерий скажет, что постоянные клиенты довольны больше, но не почему. Это видно из открытых вопросов и разреза по другим ответам.
Частые ошибки
- Применяют к одним и тем же людям. Если сравниваются оценки до и после у одних и тех же респондентов, нужен критерий знаковых рангов Уилкоксона.
- Много групп сравнивают попарно. Пять групп дают десять пар, и шанс поймать хотя бы одну случайную «значимую» разницу доходит почти до трети. Сначала проверяют все группы сразу критерием Краскела–Уоллиса, потом делают попарные сравнения с поправкой на множественность, например Бонферрони.
- В отчёте пишут «медианы различаются». Точнее так: оценки одной группы систематически выше.
- Сообщают только p. Без медиан и размера эффекта «p = 0,02» не объясняет, есть ли о чём говорить.
- Группы по три-четыре человека. На таких числах критерий почти ничего не найдёт, даже если разница есть: мощности не хватает.
Как это сделано в WebAsk
Сам критерий WebAsk не считает, но данные для него собираются здесь. Оценка по шкале и вопрос-разрез, например «Как давно вы с нами?», дают две группы. В отчёте ответы можно отфильтровать по этому вопросу и увидеть распределение оценок каждой группы, а для расчёта выгрузить ответы в XLSX, CSV или SPSS и посчитать критерий там.
Для быстрой проверки средних есть калькулятор t-теста и автопоиск значимых различий между сегментами. Оба работают со средними, поэтому на порядковых шкалах и данных с выбросами результат стоит перепроверить Манном–Уитни.
Коротко
- Критерий Манна–Уитни сравнивает две независимые группы по рангам и не требует нормальности.
- Он подходит для оценок по шкале, мест в рейтинге и данных с выбросами.
- U это число пар, где вторая группа выше, плюс половина ничьих. Без разницы он равен половине пар.
- Размер эффекта читают как долю пар U ÷ (n₁ × n₂): 50% значит, что разницы нет.
- Для связанных выборок нужен критерий знаковых рангов Уилкоксона, для трёх групп и больше критерий Краскела–Уоллиса.
- Рядом с p показывают медианы и распределения.
Вопросы и ответы
Что такое критерий Манна–Уитни?
Это непараметрический критерий, который проверяет, различаются ли две независимые группы. Он сравнивает не средние, а ранги: насколько часто значения одной группы оказываются выше значений другой. Подходит для оценок по шкале и данных с выбросами.
Когда применять критерий Манна–Уитни вместо t-критерия Стьюдента?
Когда данные порядковые, например оценки от 1 до 5, когда группы маленькие и распределение перекошено или в данных есть выбросы. Если группы большие, а данные числовые и без выбросов, t-критерий тоже работает и даёт более наглядный результат, разницу средних.
Как рассчитать U-критерий Манна–Уитни?
Выстроить все значения двух групп в один ряд и присвоить ранги, одинаковым значениям дать средний ранг. Сложить ранги одной группы и вычесть n × (n + 1) ÷ 2, где n это размер группы. Например, сумма рангов 301 при 16 ответах даёт U = 301 − 136 = 165.
Сравнивает ли критерий Манна–Уитни медианы?
Не напрямую. Он проверяет, оказываются ли значения одной группы систематически выше значений другой. Разницей медиан результат можно считать, только если распределения групп похожи по форме и отличаются лишь сдвигом.
Можно ли применять критерий Манна–Уитни к шкале Лайкерта?
Да, это естественный выбор для сравнения двух групп по одному вопросу со шкалой Лайкерта: ответы на ней порядковые. Одинаковых ответов на такой шкале много, поэтому считают с поправкой на ничьи, статистические программы делают это сами.
Чем критерий Манна–Уитни отличается от критерия Уилкоксона?
Критерий суммы рангов Уилкоксона по сути тот же критерий Манна–Уитни для двух независимых групп. А критерий знаковых рангов Уилкоксона нужен для связанных данных, когда одних и тех же людей оценивают дважды, например до и после изменений.
Сколько нужно ответов для критерия Манна–Уитни?
Формального минимума нет, для маленьких групп есть таблицы точных значений. Но при трёх-пяти ответах в группе критерий почти ничего не найдёт, даже если разница есть. Чтобы заметить умеренную разницу, нужны хотя бы десятки ответов в каждой группе.
Опубликовано 29 сентября 2026