
 Анкетолог
 Typeform
 Тестограф
 Яндекс Формы
 Google Forms
 SurveyMonkey
 Oprosso
 Simpoll


Критерий Шапиро–Уилка — это тест на нормальность: он проверяет, можно ли считать данные выборкой из нормального распределения.
 Алексей Логинов
Критерий Шапиро–Уилка проверяет, похожи ли данные на выборку из нормального распределения. Его запускают перед t-тестом и ANOVA, но результат сильно зависит от числа ответов: один и тот же перекос на 20 ответах тест пропускает в девяти случаях из десяти, а на 500 ловит почти всегда.
Ответы на вопрос со шкалой Лайкерта им не проверяют: на оценках по шкале он отвергает нормальность почти всегда.
Критерий предложили Сэмюэл Шапиро и Мартин Уилк: их статья вышла в журнале Biometrika в 1965 году. Таблицы коэффициентов в ней доходили до 50 наблюдений. В 1982 году Ройстон расширил метод до 2000, позже до 5000, и на его варианте сейчас работают R и библиотека scipy для Python.
Что проверяет критерий
Критерий исходит из того, что данные взяты из нормального распределения, это его нулевая гипотеза. По данным он считает статистику W, а по ней p-value.
- p меньше 0,05. Отклонение от нормальной формы есть, и случайностью его объяснить трудно. Насколько оно велико, p не говорит.
- p от 0,05 и выше. Оснований отвергнуть нормальность нет. Но и нормальность этим не доказана: на маленькой выборке тест может просто не увидеть отклонения.
Для W значения выстраивают по возрастанию, складывают с весами, рассчитанными для нормального распределения, и сравнивают результат с обычной суммой квадратов отклонений от среднего:
W = (Σ ai × x(i))² ÷ Σ (xi − x̄)², где x(i) это i-е по величине значение, x̄ среднее, а ai коэффициенты для нормального распределения.
У нормальных данных числитель и знаменатель почти совпадают, и значение W близко к 1. Чем сильнее перекос, тяжелее хвосты или больше выбросов, тем W меньше. Вручную W не считают: коэффициенты свои для каждого размера выборки, и программы вычисляют их по приближённым формулам.
Как читать W и p
Смотреть надо на p, потому что одно и то же значение W на разных выборках читается по-разному. W = 0,95 на 20 ответах даёт p около 0,37, и нормальность не отвергается. Те же 0,95 на 100 ответах дают p около 0,001.
В отчёте результат записывают вместе с размером выборки: «W = 0,917, p < 0,001, n = 60». Без n читатель не поймёт, насколько чувствительным был тест.
Почему результат зависит от размера выборки
Мы смоделировали данные с одним и тем же лёгким перекосом (асимметрия 0,5) и прогнали через тест по 400 выборок каждого размера, от 10 до 5000 ответов.
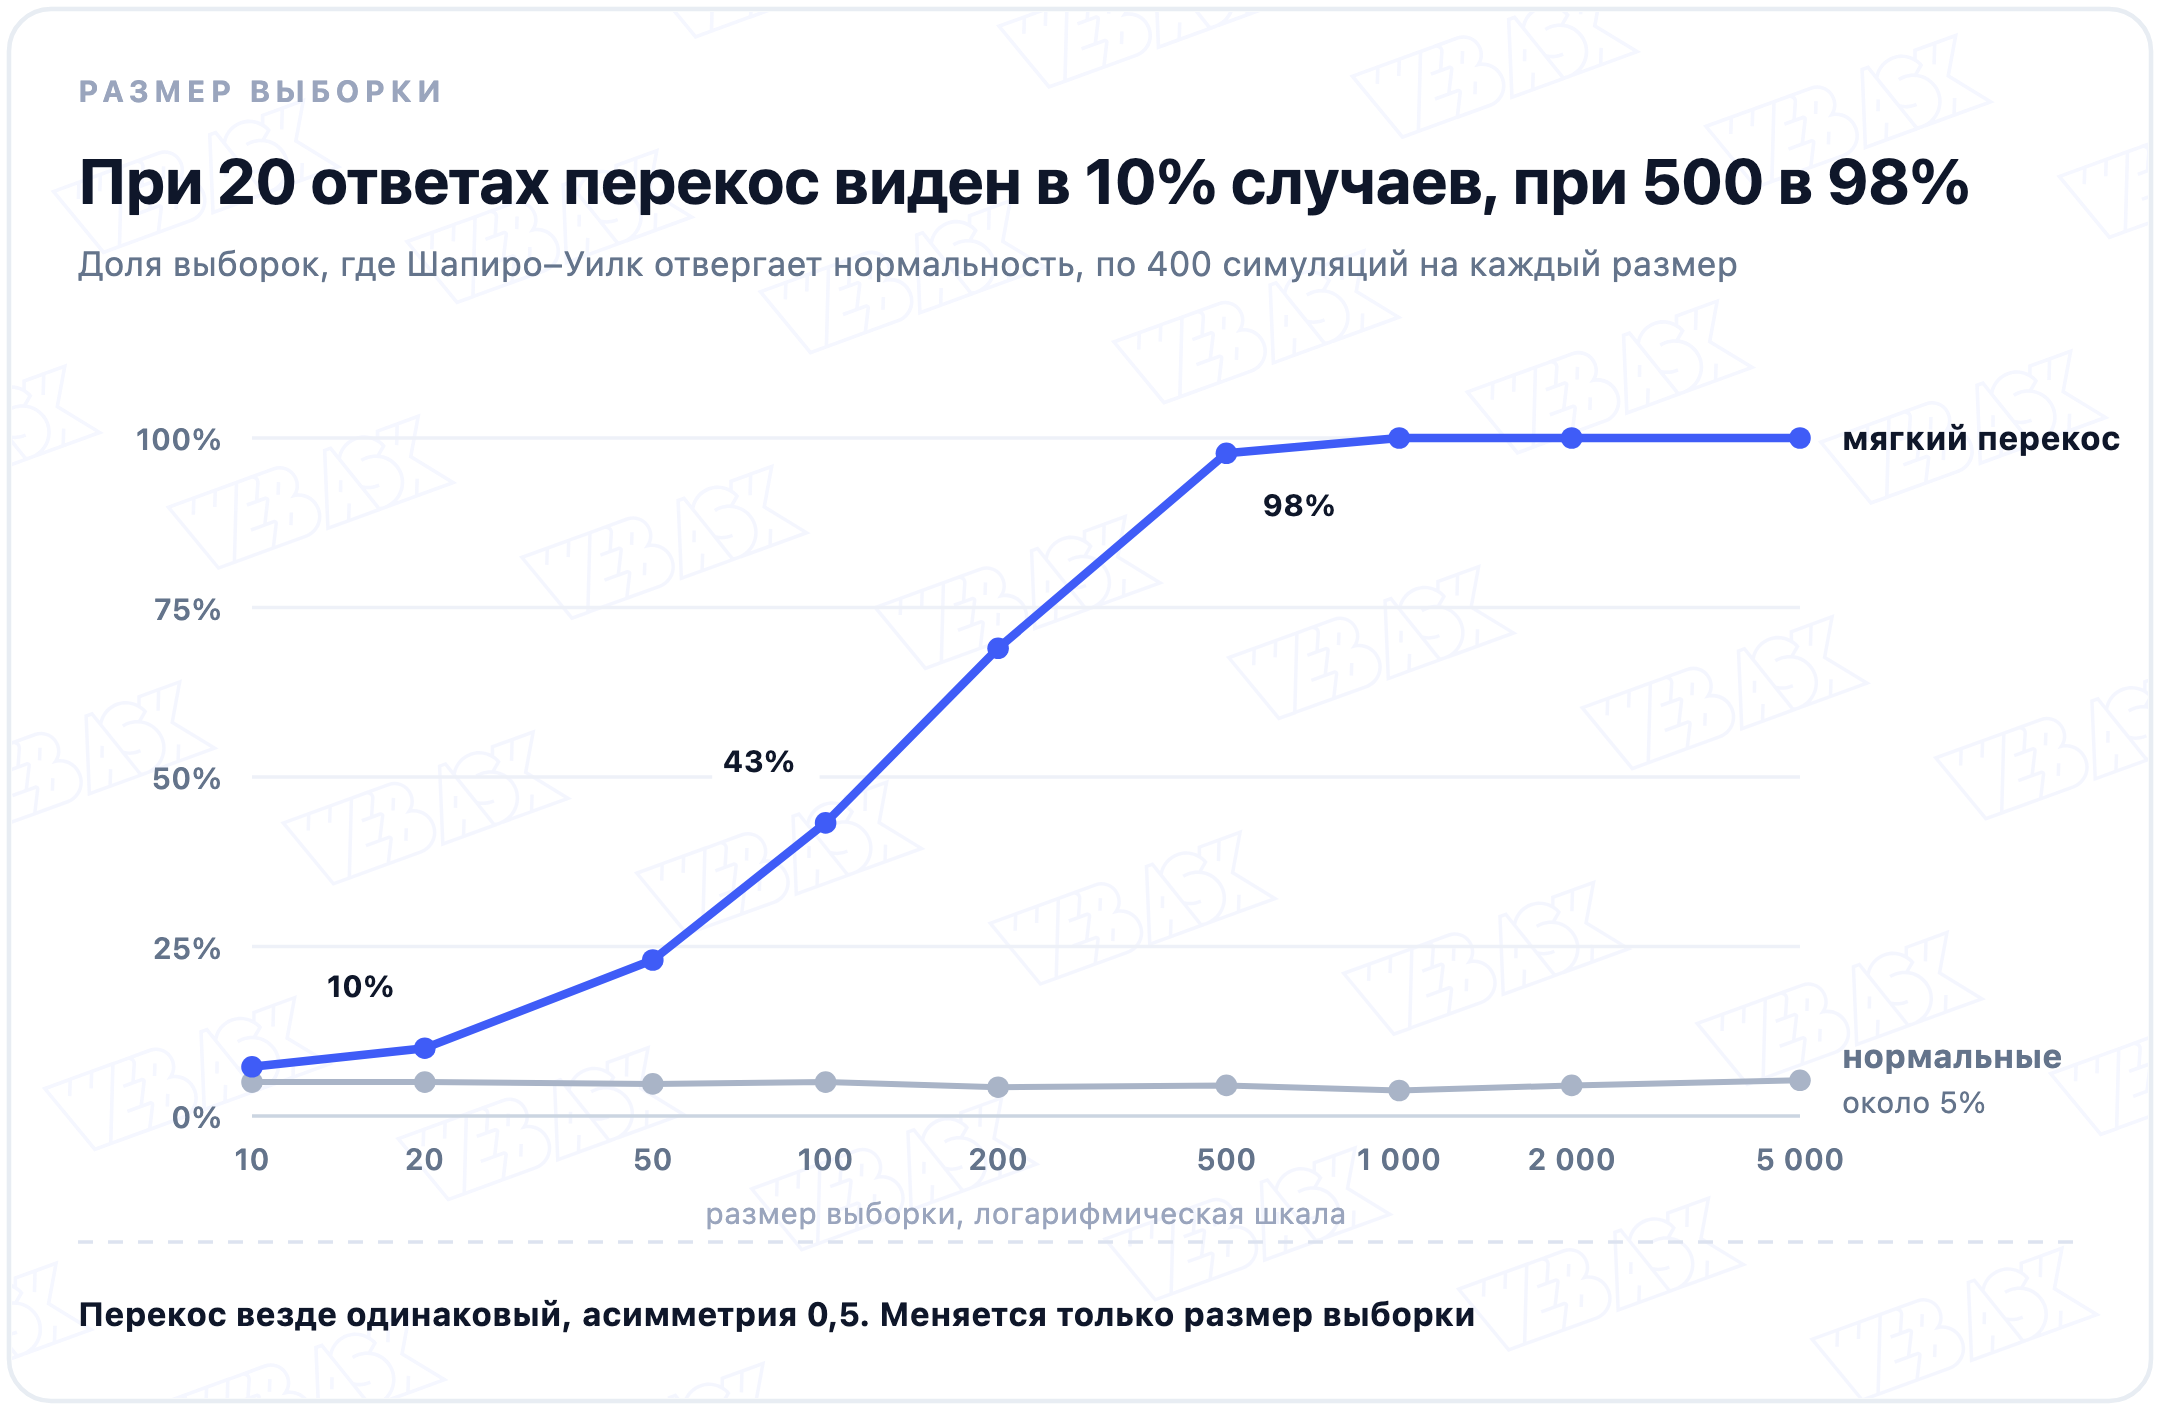
На 20 ответах перекос замечен в 10% выборок, на 100 в 43%, на 500 в 98%, а начиная с 1000 в каждой. У нормальных данных тест ошибается примерно в 5% случаев при любом размере, это и есть уровень значимости 0,05.
Отсюда неприятный вывод. На маленьких выборках, где t-тесту нормальность нужнее всего, критерий слабее всего. На больших он замечает даже слабое отклонение, которое t-тесту уже почти не мешает: по центральной предельной теореме среднее большой выборки распределено почти нормально, даже если сами данные нет. Подробнее об этом в карточке про нормальное распределение.
Поэтому на выборках в десятки ответов p больше 0,05 ещё ничего не гарантирует, смотрите на график. А на сотнях ответов p меньше 0,05 выходит почти всегда, и такой результат сам по себе не повод отказываться от t-теста.
Как проверить нормальность по Q-Q графику
Тест отвечает только на вопрос, есть ли отклонение. Какое оно и насколько сильное, видно на Q-Q графике. Данные сортируют по возрастанию и ставят против значений, которые ожидались бы при нормальном распределении: ожидаемые откладывают по горизонтали, фактические по вертикали.
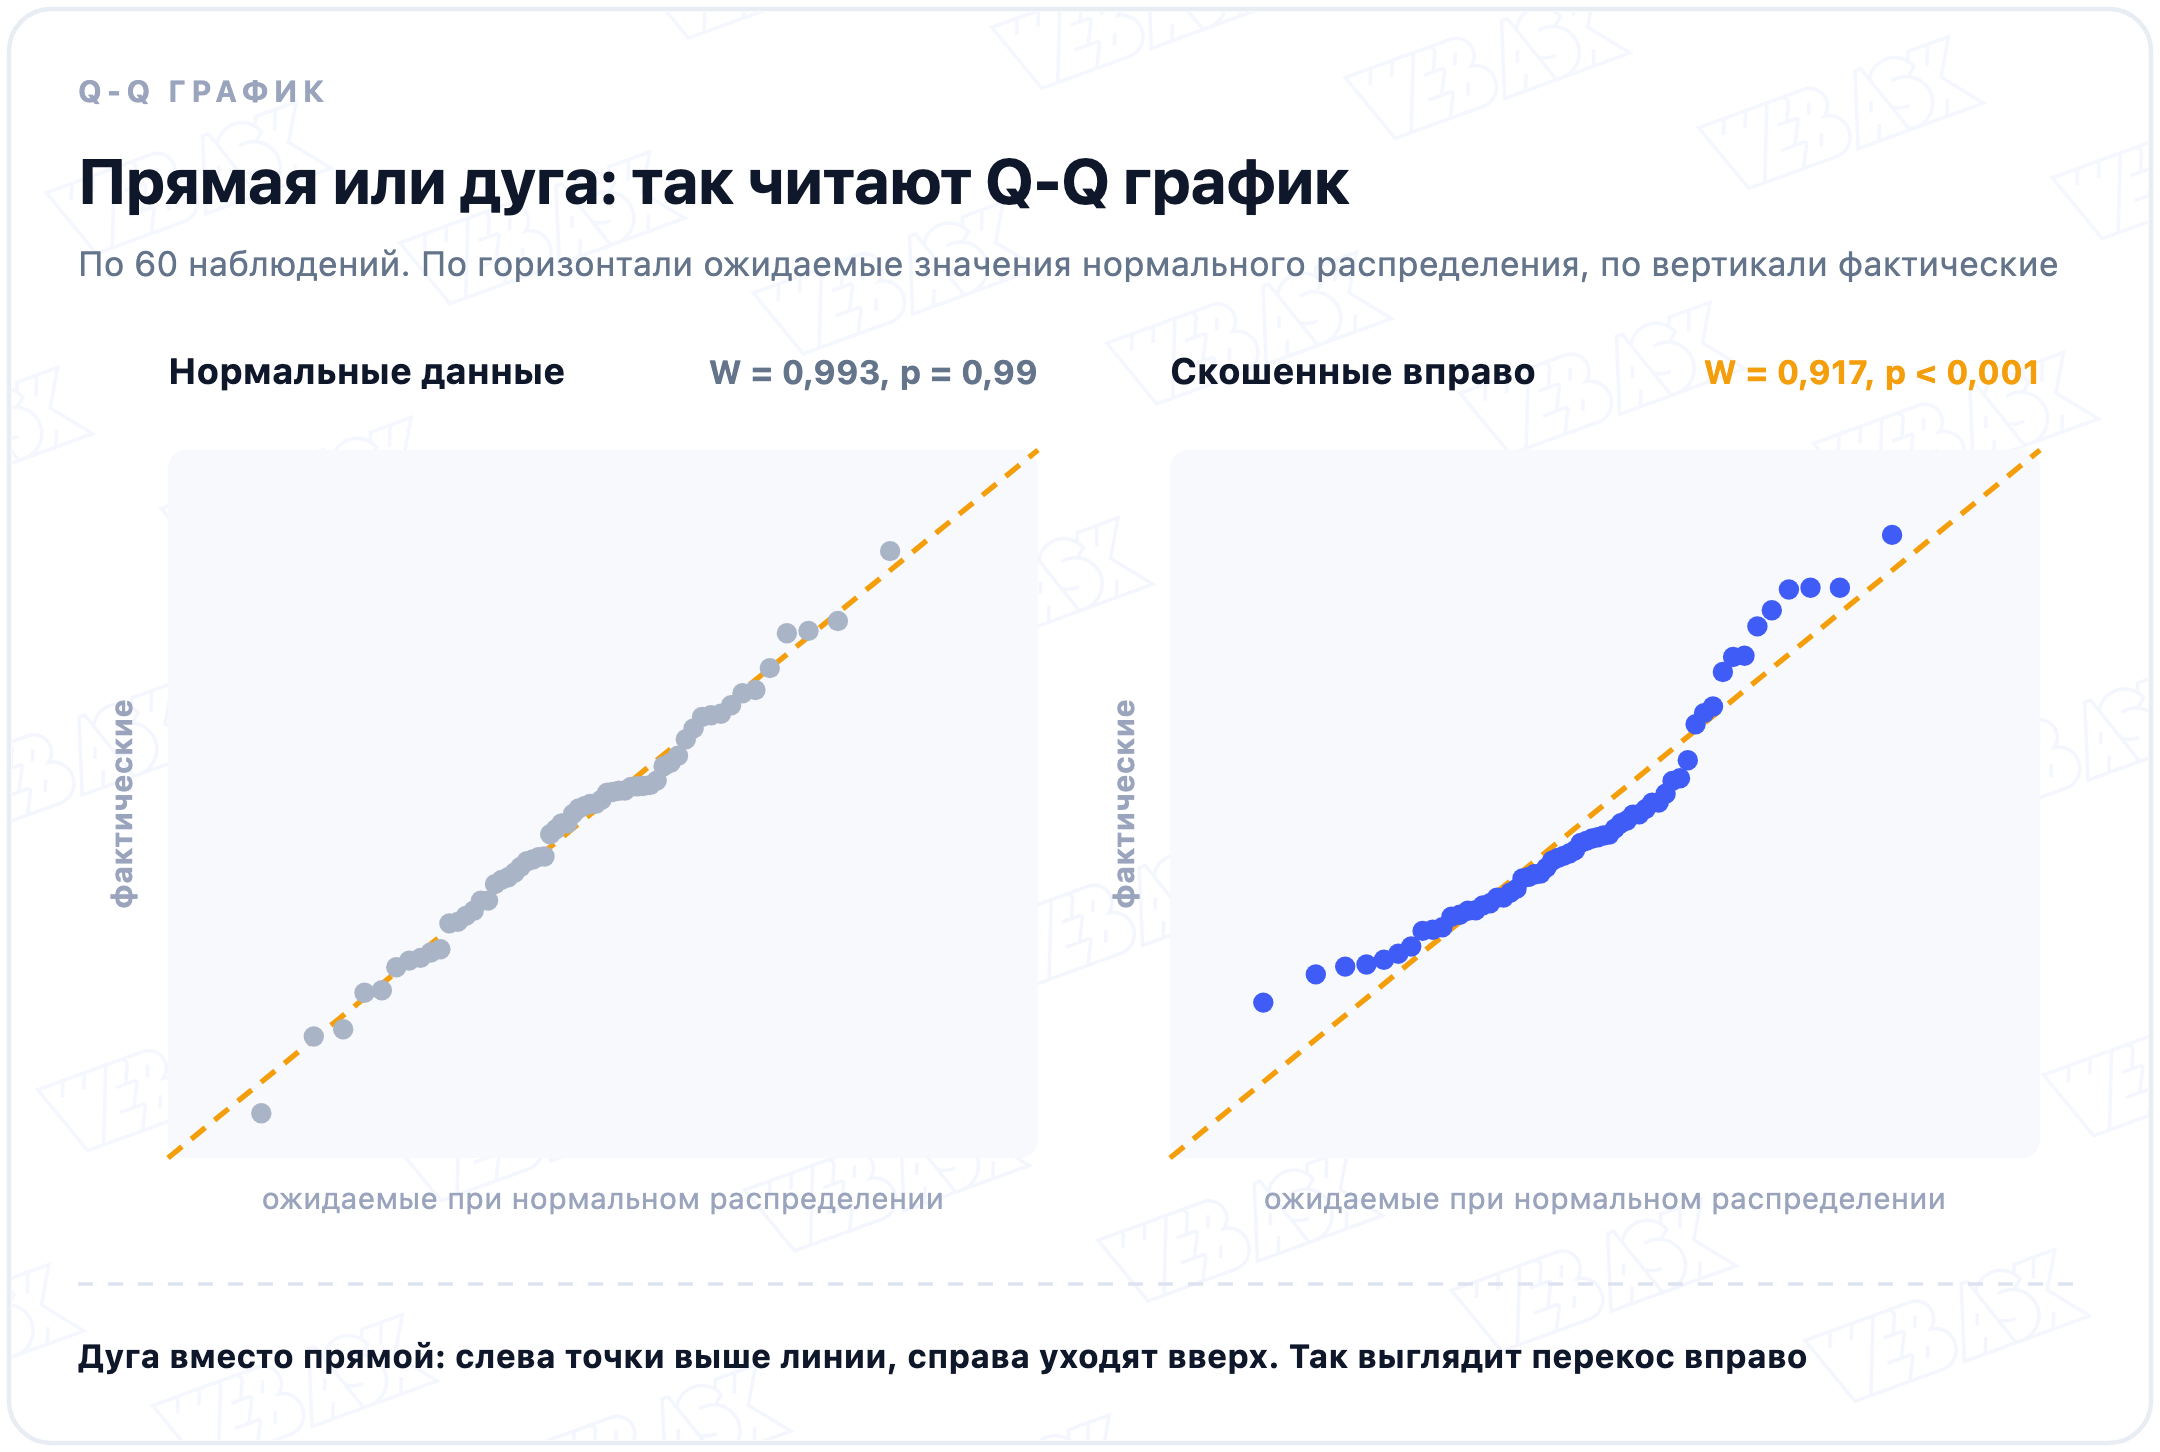
- Точки вдоль прямой. Данные близки к нормальным.
- Дуга. Данные скошены. Если концы загибаются вверх, как на правом графике, хвост тянется вправо: так обычно выглядят время заполнения анкеты и суммы покупок.
- Буква S. Хвосты тяжелее или легче нормальных: крайних значений больше или меньше, чем должно быть.
- Одна-две точки далеко от линии на краю. Похоже на выбросы. Сначала проверьте, не опечатка ли это.
Шкала от 1 до 5 проверку не пройдёт
На оценках по шкале критерий почти всегда отвергает нормальность, даже когда ответы лежат ровным колоколом.
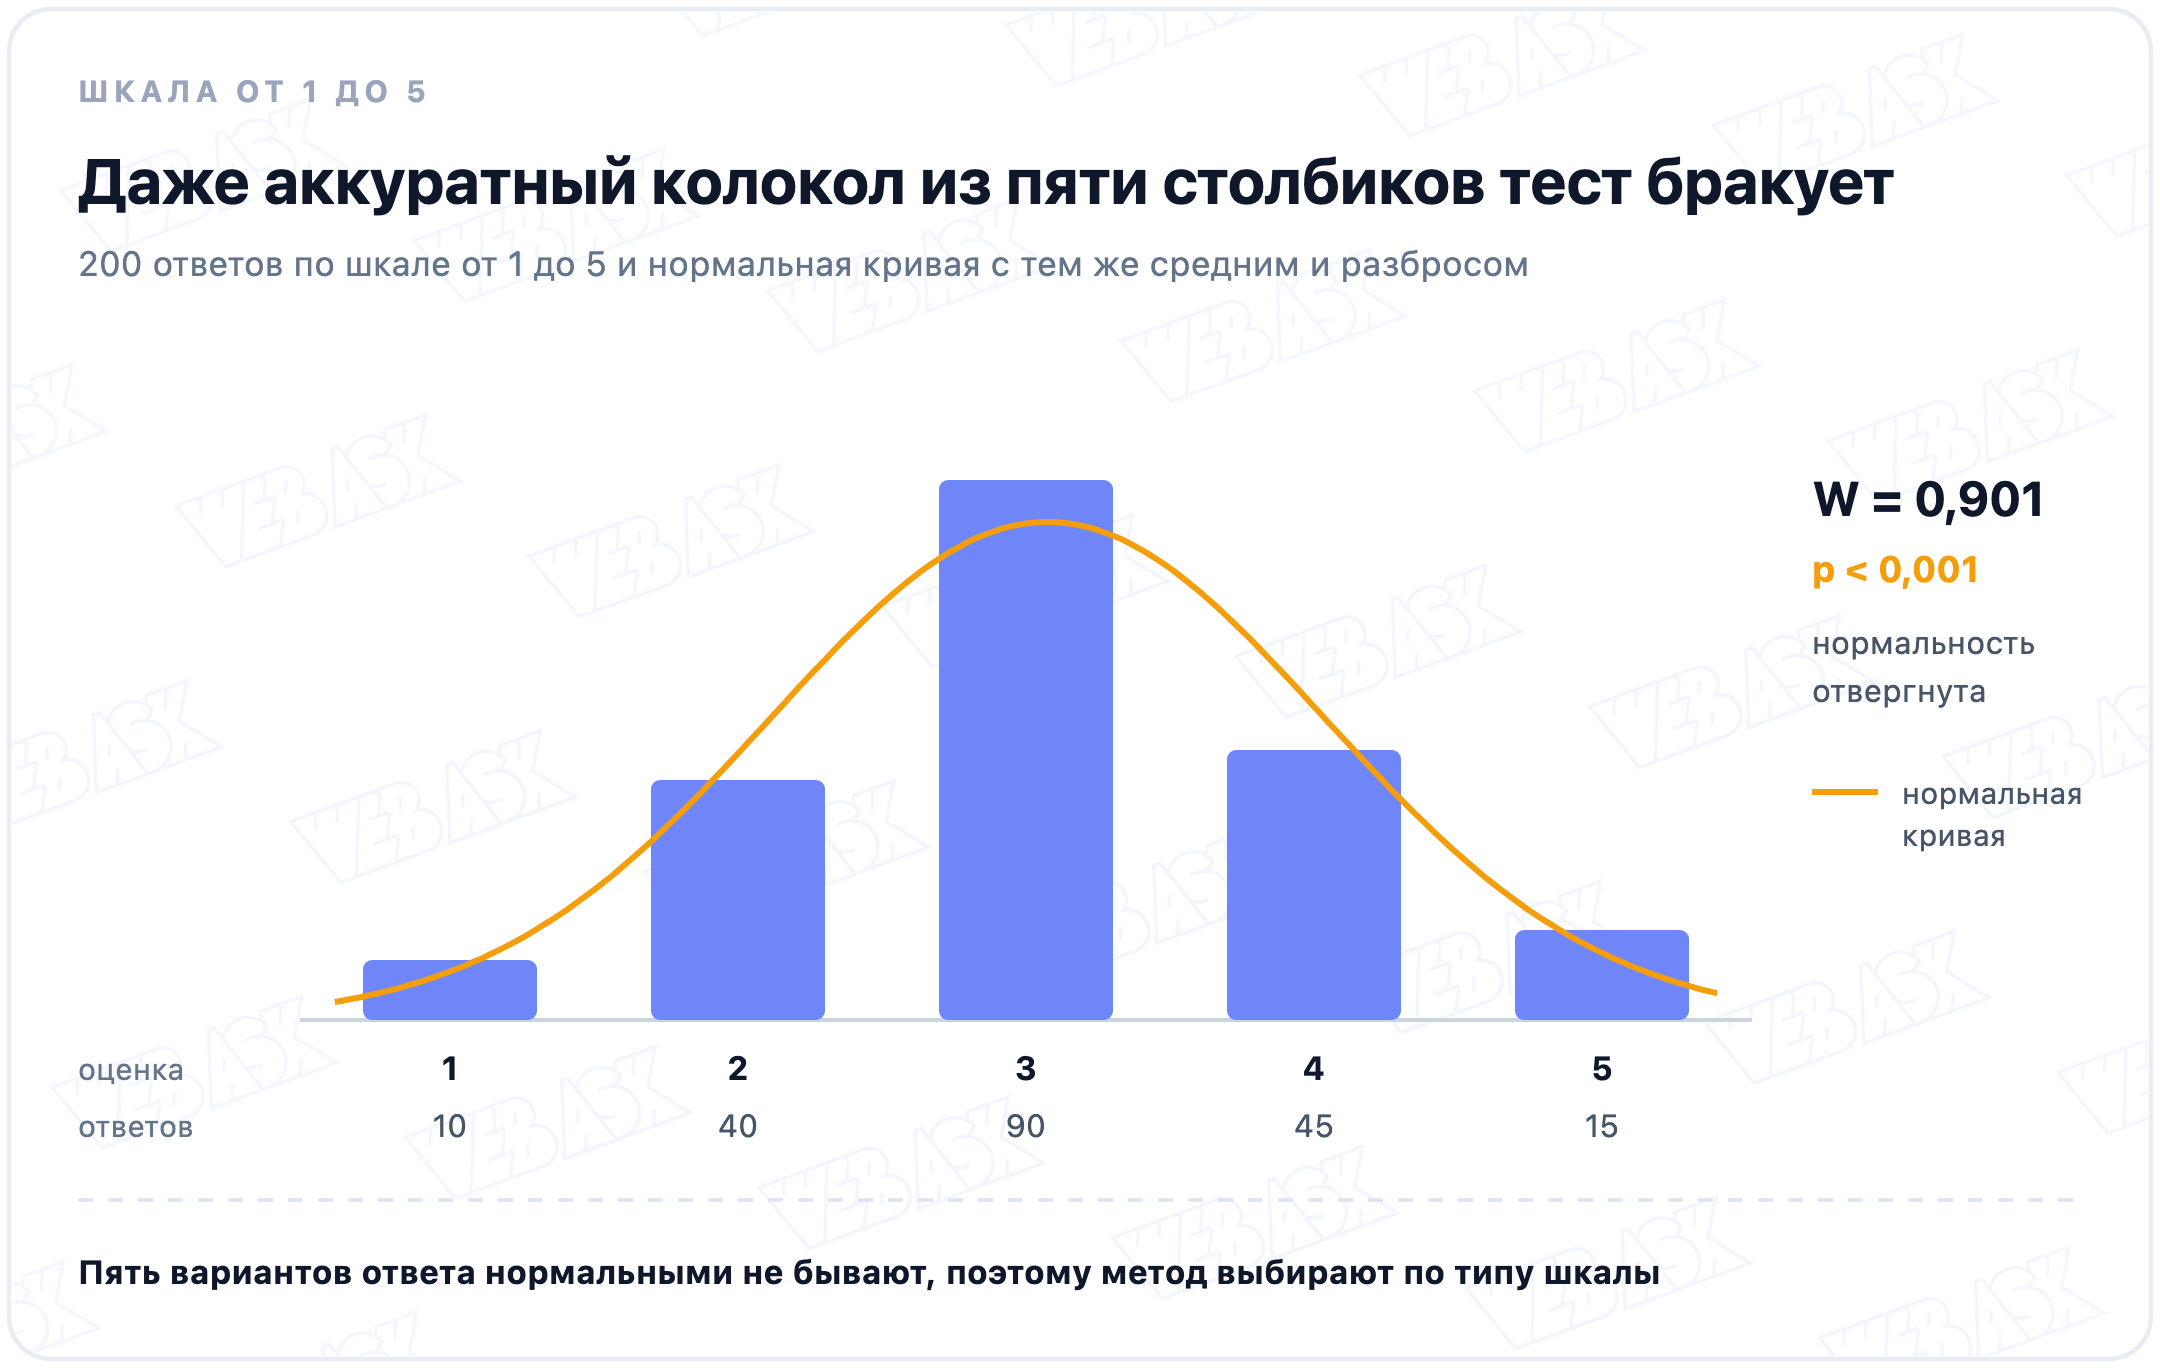
В примере 200 ответов распределены почти симметрично (асимметрия 0,02), а W = 0,901 и p < 0,001. Дело в том, что нормальное распределение непрерывное, а здесь всего пять значений и десятки одинаковых ответов на каждом. Чем больше ответов, тем увереннее тест это замечает.
Поэтому ответы на один вопрос со шкалой Лайкерта на нормальность не проверяют. Метод выбирают по типу шкалы: она порядковая, значит, для сравнения двух групп подойдёт критерий Манна–Уитни. Другое дело индекс из суммы десяти вопросов: у него десятки возможных значений, и проверка там имеет смысл.
Что делать, если нормальность отвергнута
- Сначала посмотреть на график. Q-Q график и гистограмма покажут, в чём дело: перекос, хвосты или пара выбросов.
- Прикинуть размер групп. Если в каждой группе сотни ответов, а перекос умеренный, t-тест и ANOVA обычно справляются.
- Маленьким группам и порядковым данным нужен ранговый критерий. Манна–Уитни для двух независимых групп, знаковых рангов Уилкоксона для одних и тех же людей до и после, Краскела–Уоллиса для трёх групп и больше.
- Длинный правый хвост часто лечит логарифм. Время заполнения и суммы покупок после него нередко становятся почти симметричными. Проверку повторяют на преобразованных данных, а в отчёте оговаривают, что t-тест на логарифмах сравнивает средние геометрические.
- Рядом со средним дать медианы и межквартильный размах. Для скошенных данных они описывают группу честнее среднего.
Шапиро–Уилк и другие тесты нормальности
- Колмогоров–Смирнов. Сравнивает накопленные доли в данных с теми, что дало бы нормальное распределение, и берёт самое большое расхождение. Если среднее и разброс оценивают по тем же данным, нужна поправка Лиллиефорса. SPSS показывает этот тест уже с ней.
- Андерсон–Дарлинг. Похож на Колмогорова–Смирнова, но внимательнее к хвостам.
- Д’Агостино–Пирсон. Складывает две проверки, по асимметрии и по эксцессу. Их можно посмотреть и по отдельности, тогда видно, что не так: перекос или хвосты.
Разали и Ва в 2011 году сравнили на смоделированных данных четыре теста: Шапиро–Уилка, Колмогорова–Смирнова, Лиллиефорса и Андерсона–Дарлинга. Самым мощным оказался Шапиро–Уилк, следом с небольшим отставанием шёл Андерсон–Дарлинг, Колмогоров–Смирнов замкнул список. Мощнее значит, что при том же размере выборки тест чаще замечает настоящее отклонение. Так что на выборках до нескольких тысяч с него и начинают.
Частые ошибки
- Все ответы проверяют одной кучей. Для t-теста по двум группам нормальность нужна в каждой группе, для парного t-теста у разностей «после минус до», для ANOVA и регрессии у остатков. Две нормальные группы с разными средними вместе могут дать двугорбое распределение, и тест его забракует.
- p больше 0,05 принимают за доказательство нормальности. В нашей модели на 20 ответах скошенные данные проходили проверку в 90% случаев.
- Бросают t-тест на большой выборке из-за p меньше 0,05. На 1000 ответах тест бракует даже лёгкий перекос, который t-тесту уже не страшен.
- Шкалу от 1 до 5 гоняют через тест. Она его почти никогда не проходит, и метод для неё выбирают по типу данных.
- Выборка больше 5000. R такую не примет, scipy посчитает, но предупредит, что p может быть неточным. На таких объёмах надёжнее смотреть на график.
Как это сделано в WebAsk
Встроенного теста на нормальность в WebAsk нет. Зато в отчёте видно, как распределились ответы на вопрос, а фильтр по вопросу-разрезу покажет это для каждой группы отдельно. Длинный хвост или выброс часто заметны уже здесь, до всякого теста. Для расчёта ответы выгружают в XLSX, CSV или SPSS.
Дальше проверка занимает одну строку или пару кликов:
- SPSS. Analyze → Descriptive Statistics → Explore, в окне Plots отметить Normality plots with tests. Программа покажет Шапиро–Уилка, Колмогорова–Смирнова с поправкой Лиллиефорса и Q-Q график.
- R. Функция
shapiro.test(x). - Python. Функция
scipy.stats.shapiro(x)из библиотеки scipy.
Если проверка показала, что t-тест годится, его можно посчитать в калькуляторе t-теста WebAsk.
Коротко
- Критерий Шапиро–Уилка проверяет, похожи ли данные на нормальное распределение. p меньше 0,05 значит, что нормальность отвергнута.
- У нормальных данных W близко к 1, но читать надо p: порог W зависит от размера выборки.
- На десятках ответов тест слабый и пропускает перекос, на сотнях и тысячах ловит отклонения, которые t-тесту не мешают.
- Тест дополняют Q-Q графиком: он показывает, какое отклонение и насколько оно сильное.
- Шкалу от 1 до 5 на нормальность не проверяют, метод выбирают по типу шкалы.
- Нормальность проверяют в каждой группе или у остатков, а не по всем ответам сразу.
Вопросы и ответы
Что такое критерий Шапиро–Уилка?
Это статистический тест, который проверяет, взяты ли данные из нормального распределения. Он считает статистику W и p-value: при p меньше 0,05 нормальность отвергают. Критерий работает на выборках от 3 до 5000 наблюдений и по мощности обычно обходит Колмогорова–Смирнова.
Как интерпретировать результат теста Шапиро–Уилка?
Если p от 0,05 и выше, оснований отвергать нормальность нет, но это не доказательство: на маленькой выборке тест может не заметить отклонения. Если p меньше 0,05, форма данных отличается от нормальной. Насколько сильно, покажет Q-Q график, ведь на сотнях ответов тест замечает и несущественные отклонения.
Что означает W в критерии Шапиро–Уилка?
W это статистика критерия, число от 0 до 1. Чем ближе W к 1, тем больше данные похожи на нормальные. Порог W зависит от размера выборки: W = 0,95 на 20 наблюдениях нормальность не отвергает, а на 100 отвергает. Поэтому выводы делают по p.
Для какого размера выборки подходит критерий Шапиро–Уилка?
Современные версии работают на выборках от 3 до 5000 наблюдений, исходный вариант 1965 года был рассчитан до 50. На десятках наблюдений тест слабый и пропускает умеренный перекос, на сотнях и тысячах отвергает нормальность даже при небольших отклонениях.
Чем критерий Шапиро–Уилка отличается от Колмогорова–Смирнова?
Шапиро–Уилк построен специально для проверки нормальности и при том же размере выборки чаще замечает отклонение. Колмогоров–Смирнов сравнивает данные с любым заданным распределением, а для проверки нормальности с параметрами из самих данных ему нужна поправка Лиллиефорса. Если нужен один тест, обычно берут Шапиро–Уилка.
Что делать, если данные не распределены нормально?
Посмотреть на Q-Q график и на размер групп. При сотнях ответов в группе и умеренном перекосе t-тест обычно работает. Для маленьких групп и порядковых шкал берут ранговые критерии: Манна–Уитни для двух групп, Краскела–Уоллиса для трёх и больше. Длинный правый хвост часто убирает логарифмирование.
Как посчитать критерий Шапиро–Уилка?
В R это функция shapiro.test, в Python scipy.stats.shapiro, в SPSS пункт Explore с отметкой Normality plots with tests. В Excel встроенной функции нет, нужна надстройка. Ответы опроса из WebAsk для расчёта выгружают в XLSX, CSV или SPSS.
Опубликовано 29 сентября 2026