
 Анкетолог
 Typeform
 Тестограф
 Яндекс Формы
 Google Forms
 SurveyMonkey
 Microsoft Forms
 Online Test Pad
 Oprosso
 Simpoll


 Алексей Логинов
Пять регионов сравнили попарно по пяти метрикам: вышло 50 p-value, и три из них меньше 0,05. В модели, на которой получены эти числа, настоящих различий нет ни одного.
Что такое поправка Бонферрони
Поправка Бонферрони (Bonferroni correction) — это способ проверять много гипотез сразу и держать риск хотя бы одной ложной находки на выбранном уровне.
Поправка Бонферрони делит уровень значимости на число сравнений: для 50 проверок порог 0,05 превращается в 0,001.
Неравенство, на котором стоит поправка, вывел итальянский математик Карло Эмилио Бонферрони в 1936 году. К сравнению средних его применила Олив Джин Данн в статье 1961 года. Позже появились более мягкие варианты: метод Стуре Холма 1979 года и процедура Йоава Бенджамини и Йосефа Хохберга 1995 года.
Проблема сидит в арифметике. Если различия нет, проверка на уровне 5% всё равно «находит» его в одном случае из двадцати, и с числом сравнений такие шансы копятся: при 20 независимых проверках хотя бы одна ложная находка случится с вероятностью 64%, при 50 около 92%. Формула простая: 1 − 0,95m, где m число сравнений. О самой ложной находке подробнее в карточке про ошибки первого и второго рода.
Откуда в опросе ложные находки
Хи-квадрат по данным опросаСравнения в опросах множатся незаметно. Пять регионов дают 10 пар, пять метрик превращают их в 50 проверок, а если добавить пол и возраст, счёт пойдёт на сотни. Так устроен любой перебор срезов: каждая ячейка отчёта со звёздочкой значимости это отдельная проверка.
Насколько вероятно, что вы порекомендуете нас коллеге?
Вот и всё — такой опрос собирается за пару минут, а индекс WebAsk считает сам.
Создать свой опрос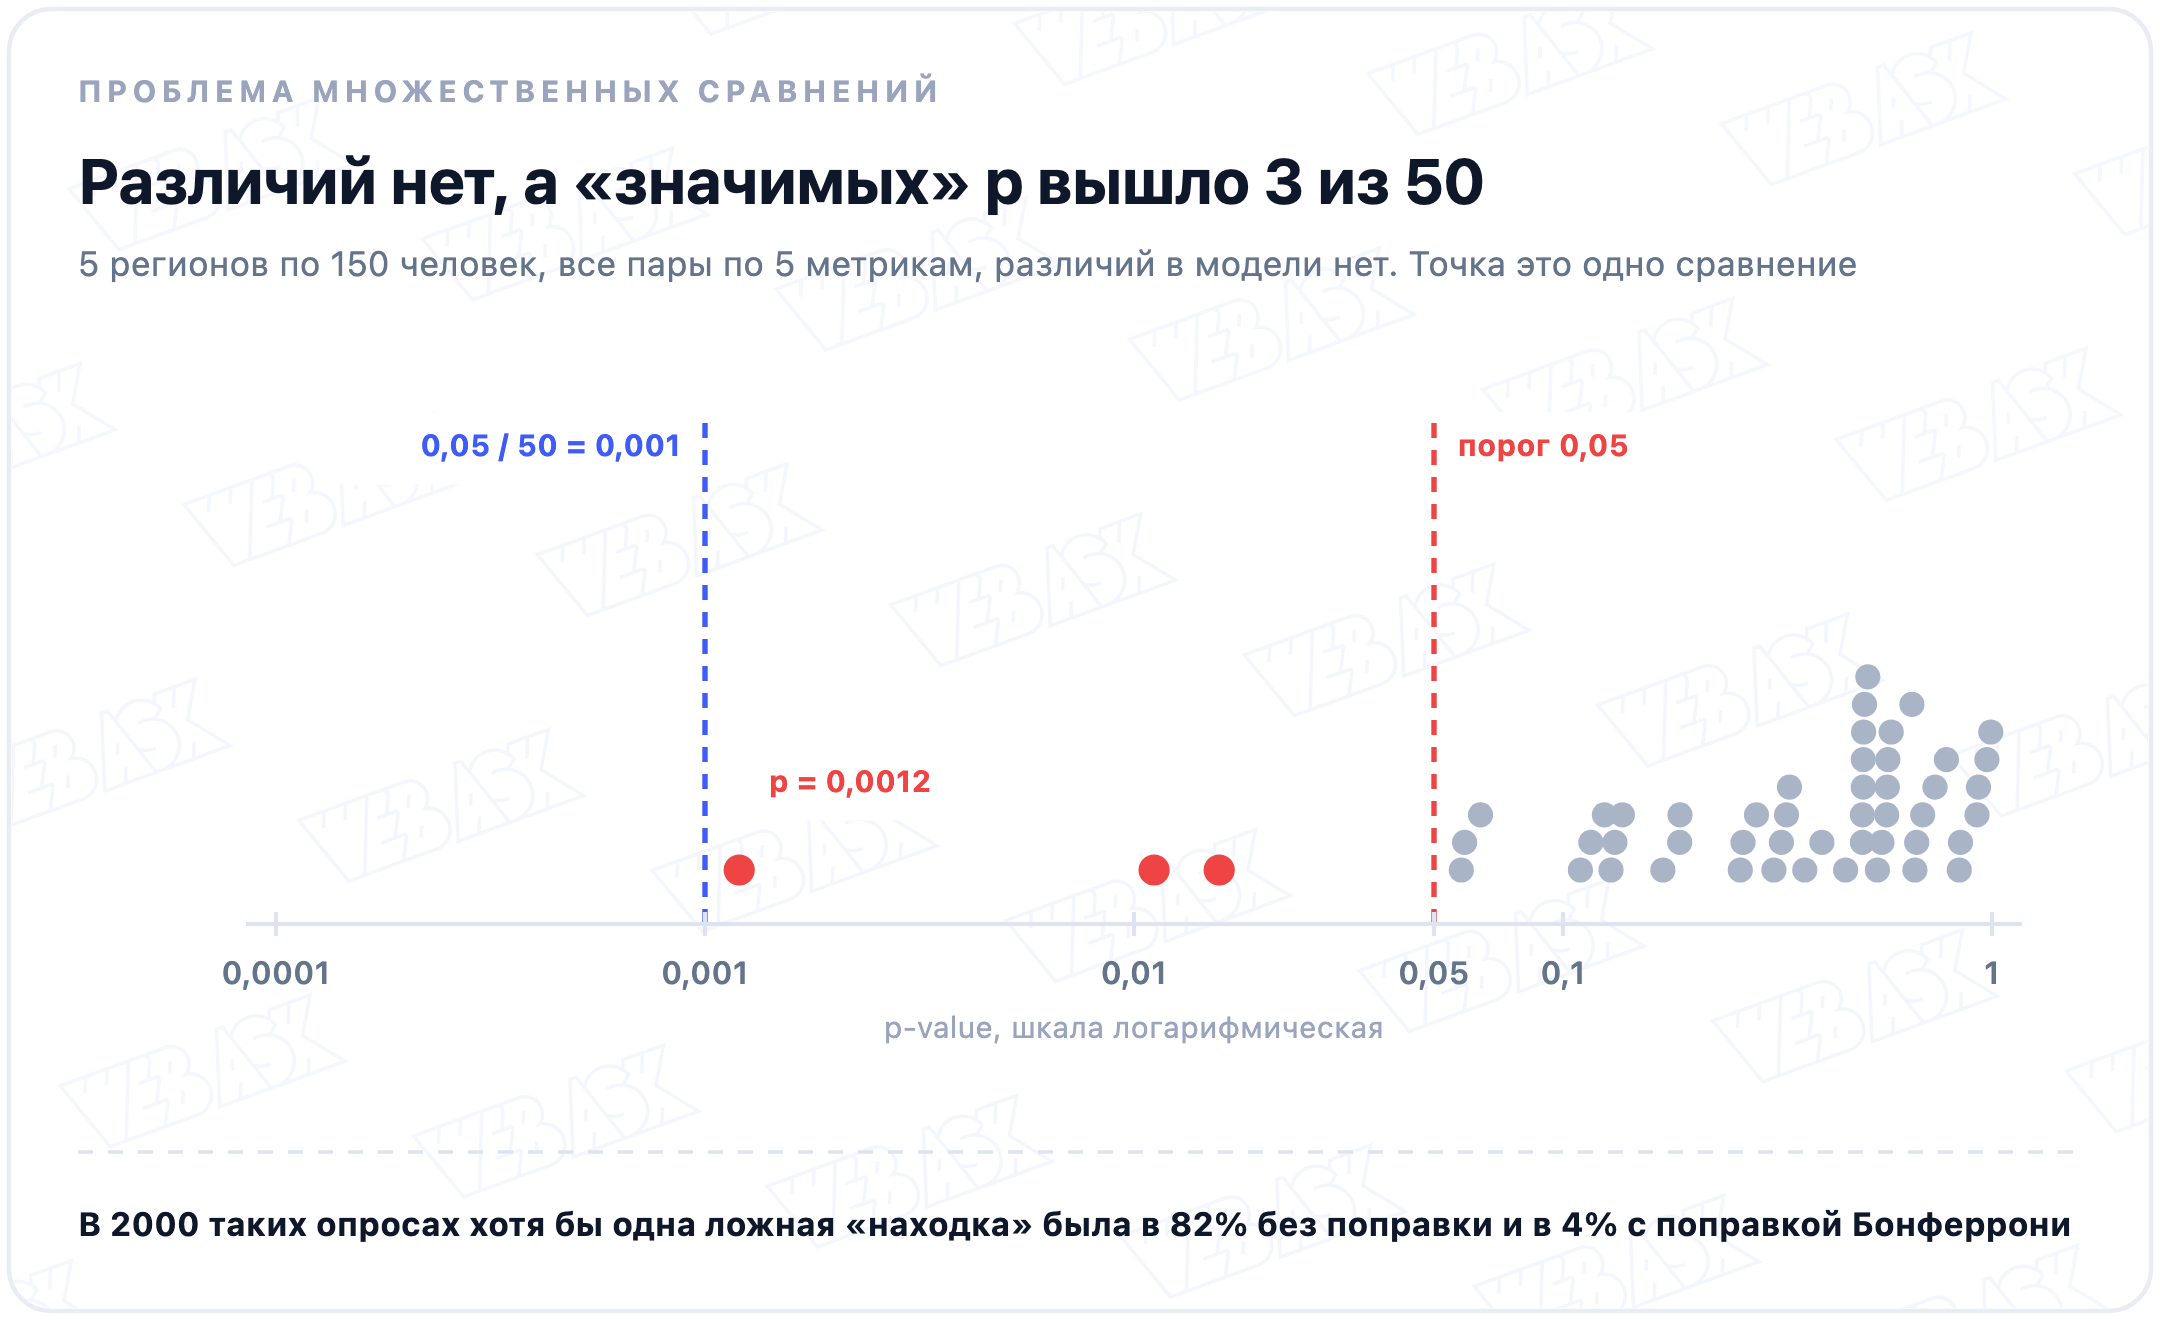
В модели все пять регионов отвечают одинаково, и всё же три сравнения из 50 дали p меньше 0,05, одно даже 0,0012. В 2000 таких опросов хотя бы одна ложная «находка» была в 82% случаев. Это меньше теоретических 92%, потому что пары регионов пересекаются и проверки зависят друг от друга. С поправкой Бонферрони ложная находка случилась в 4% опросов, в пределах обещанных 5%.
Как работают три поправки
Все три сравнивают p-value с порогом, но порог считают по-разному. Пусть сравнений m, p-value отсортированы по возрастанию, а i номер места.
- Бонферрони. Значимо всё, где p ≤ α / m. Для 50 сравнений и α = 0,05 это 0,001. То же самое, что умножить каждое p на m и сравнить с 0,05.
- Холм. Самое маленькое p сравнивают с α / m, второе с α / (m − 1), третье с α / (m − 2) и так далее, пока очередное p не окажется выше своего порога. Всё до этого места значимо.
- Бенджамини–Хохберг. Ищут самое большое i, при котором p ≤ i × α / m, и значимыми считают все p до него включительно. Эта процедура следит за другим: за средней долей ложных среди найденного.
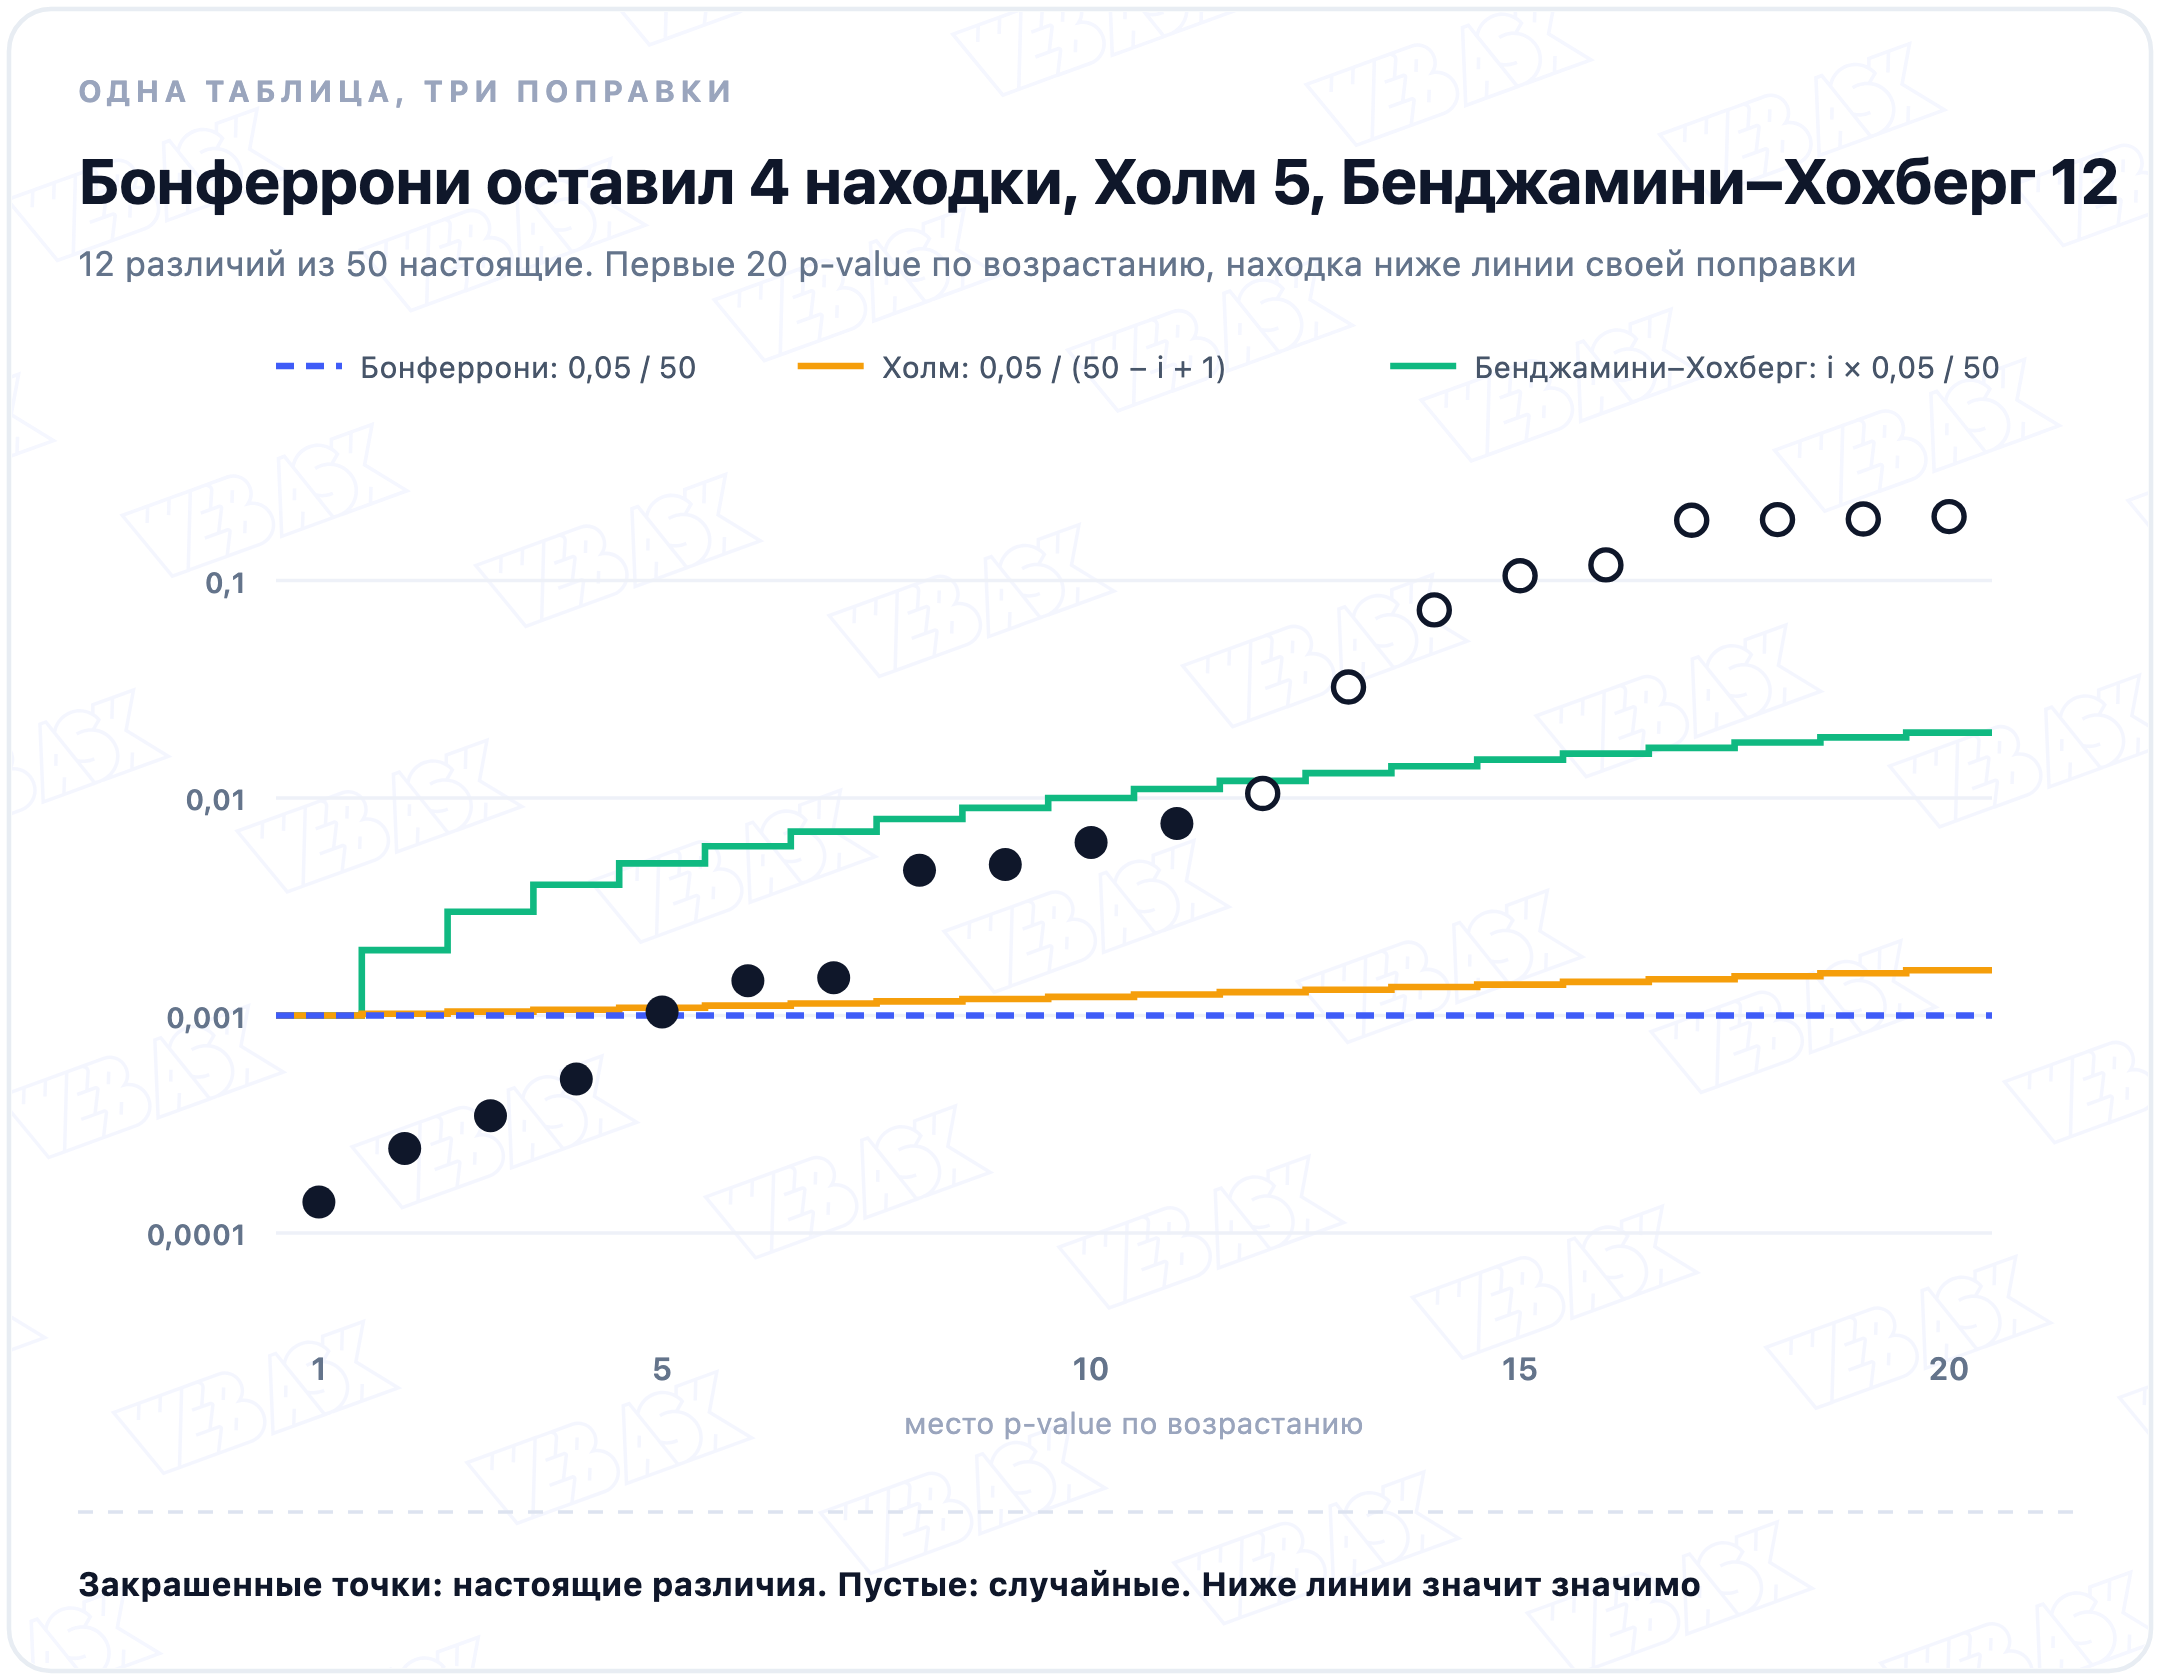
В опросе на графике 12 различий из 50 настоящие. Бонферрони признал четыре. Пятое p = 0,00104 чуть выше его порога, но ниже порога Холма для пятого места, 0,05 / 46 = 0,00109, поэтому у Холма находок пять. Бенджамини–Хохберг дошёл до двенадцатого места: 11 настоящих различий и одно случайное с p = 0,0105. Без поправки значимыми вышли бы 13 сравнений, из них два случайных.
Что выбрать
Бонферрони и Холм защищают от того, чтобы в отчёт попала хоть одна ложная находка. Платить за это приходится пропущенными настоящими различиями. Чтобы увидеть цену, мы повторили опрос с 12 настоящими различиями 2000 раз.
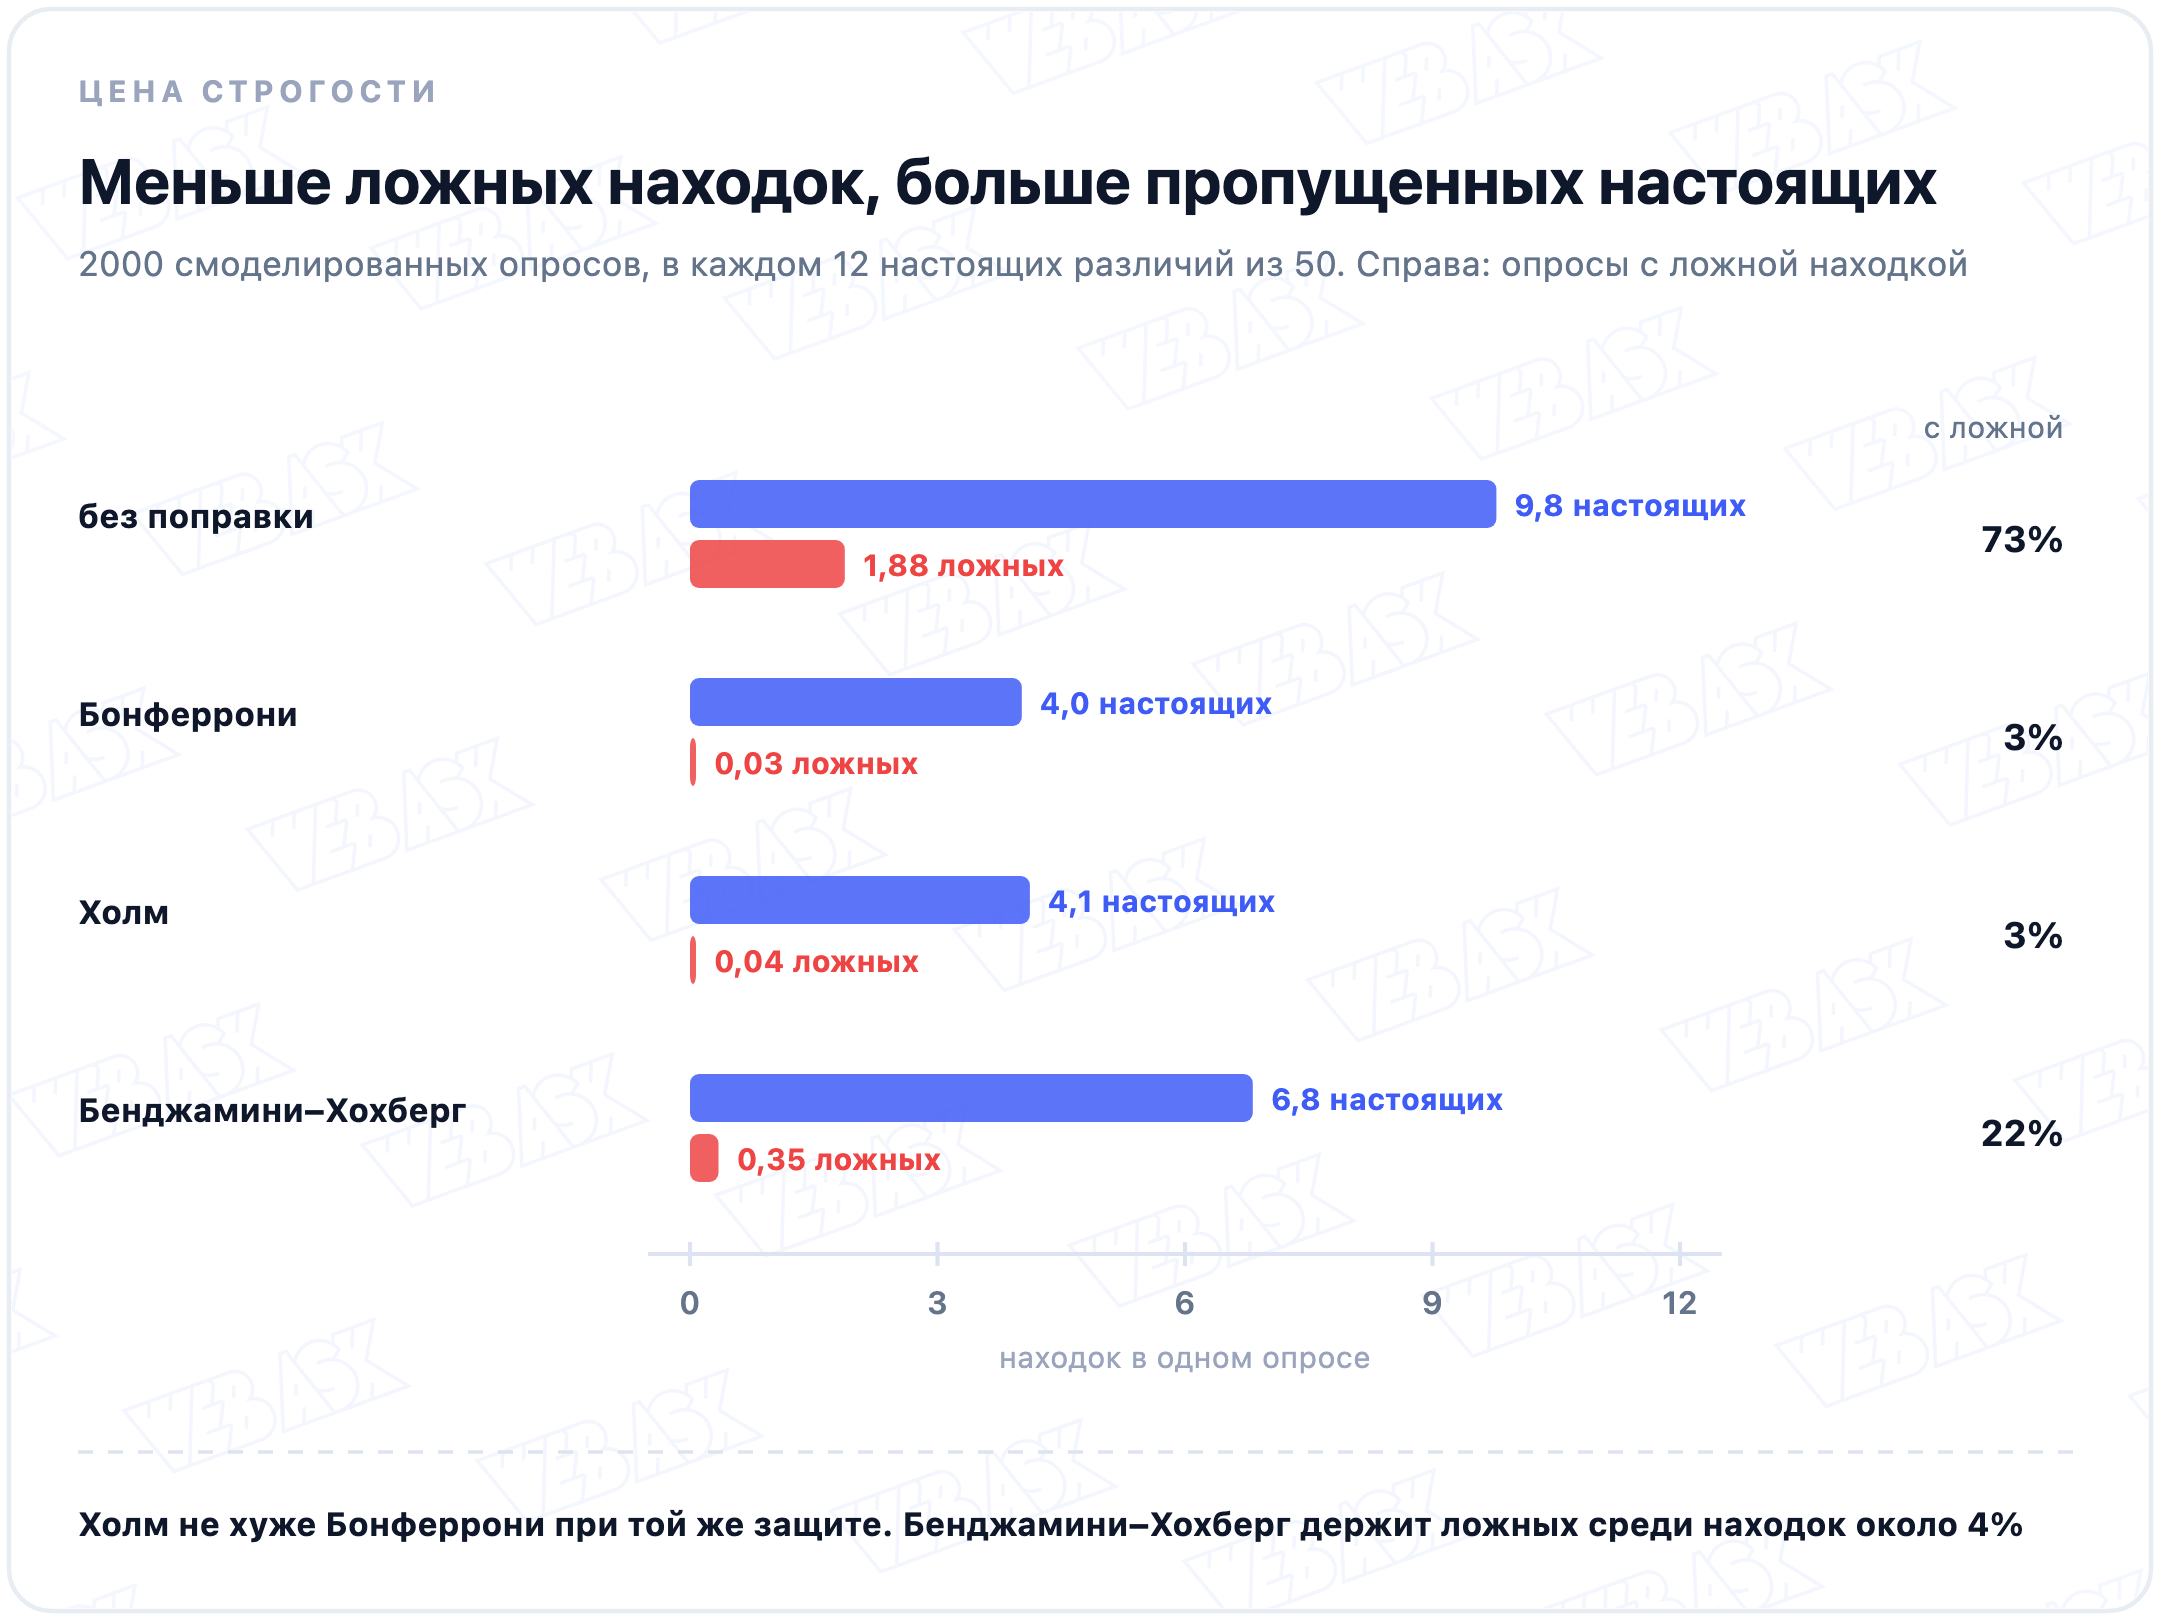
Без поправки находилось в среднем 9,8 настоящих различий и 1,9 ложных, и в 73% опросов была хотя бы одна ложная. Бонферрони и Холм находили около четырёх настоящих, а ложная проскакивала в 3% опросов. Бенджамини–Хохберг находил 6,8 настоящих, ложных среди найденного было около 4%.
- Холм вместо Бонферрони. Защищает так же и никогда не находит меньше. В документации R прямо сказано, что брать обычного Бонферрони незачем: его во всём перекрывает метод Холма.
- Бонферрони, когда сравнений пять-десять. Порог α / m читатель отчёта проверит в уме, а проигрыш Холму на таком числе проверок невелик.
- Бенджамини–Хохберг для разведки. Подходит, когда сравнений десятки или сотни и каждую находку потом всё равно проверят: пропущенное различие обходится дороже лишнего. Цена: часть найденного окажется случайной, в среднем не больше 5% при уровне 0,05.
Чего поправка не исправит
- Сравнения, которые не посчитали. m это все проверки, на которые смотрели. Если перебрали 200 срезов и показали в отчёте 10, делить надо на 200.
- Плохие данные. Смещённую выборку, наводящий вопрос или выбросы поправка не видит: она работает только с теми p-value, которые ей дали.
- Размер различия. Значимость и после поправки ничего не говорит о том, велико ли различие. Для этого смотрят на размер эффекта.
- Сильно связанные проверки. Если сравнения почти дублируют друг друга, например одна метрика в двух похожих формулировках, Бонферрони перестраховывается: настоящая доля ложных находок ниже 5%, а пропусков больше.
Частые ошибки
- Делят на число значимых сравнений. Делить надо на число всех проверок, включая незначимые.
- Семейство сравнений выбрано после результатов. Обычно поправку делают внутри одного вопроса анализа, например по всем парам регионов для оценки доставки. Решают это до того, как смотрят на p.
- Бонферрони после дисперсионного анализа. Для всех попарных сравнений средних после ANOVA есть критерий Тьюки, он рассчитан как раз на эту задачу и обычно находит больше.
- Двойная поправка. Скорректированное p, уже умноженное на m, сравнивают с порогом 0,05 / m. Поправка применяется один раз.
Как посчитать в Excel, R и Python
В Excel хватает трёх формул. Пусть p-value 50 сравнений стоят в B2:B51.
- Отсортируйте p по возрастанию. В A2:A51 поставьте номера мест от 1 до 50.
- Бонферрони. В C2 скорректированное p
=МИН(1;B2*50), значимо всё меньше 0,05. - Холм. В D2 порог
=0,05/(50-A2+1). Значимы строки сверху до первой, где p выше порога. - Бенджамини–Хохберг. В E2 порог
=A2*0,05/50. Найдите последнюю строку, где p не выше порога: она и все строки над ней значимы.
- R.
p.adjust(p, method = "holm"), другие варианты method = "bonferroni" и "BH". - Python.
multipletests(p, method="holm")из statsmodels.stats.multitest, варианты "bonferroni" и "fdr_bh". - SPSS. В однофакторном дисперсионном анализе кнопка Post Hoc, отметка Bonferroni. В таблицах сопряжённости Cells → Compare column proportions → Adjust p-values (Bonferroni method).
Как это сделано в WebAsk
Какую разницу между группами можно заметитьВ WebAsk поправку делает автопоиск стат-значимых различий. В него загружают CSV с ответами: числовые колонки становятся метриками, текстовая колонка с категориями сегментом. Инструмент сравнивает все пары сегментов по каждой метрике t-тестом Уэлча и сортирует находки по размеру эффекта, d Коэна. Поправку выбирают переключателем: Bonferroni или без поправки, уровень значимости 0,05, 0,01 или 0,10.
Ответы для автопоиска выгружаются из опроса в CSV. Сегментом может быть ответ на вопрос о регионе или скрытая переменная с источником ответа. Если сравнений много и нужна разведка, удобнее посчитать p в R или Python и прогнать их через Бенджамини–Хохберга.
Коротко
- При 50 сравнениях на уровне 5% хотя бы одна ложная находка почти неизбежна: 92% в теории, 82% в нашей модели опроса.
- Бонферрони сравнивает каждое p с 0,05 / m, Холм с порогом, который растёт с местом p, Бенджамини–Хохберг с i × 0,05 / m.
- Холм защищает так же, как Бонферрони, и находит не меньше, поэтому по умолчанию берут его.
- Бенджамини–Хохберг находит больше, но допускает среди найденного долю ложных, в среднем до 5%.
- m это все проверки, на которые смотрели, и считают его до анализа.
Вопросы и ответы
Что такое поправка Бонферрони простыми словами?
Это правило для случая, когда проверяют сразу много гипотез: порог значимости делят на их число. При 20 сравнениях и уровне 0,05 значимым считают только p не больше 0,0025. Тогда шанс ошибиться хоть раз на весь набор проверок остаётся в пределах 5%.
Как рассчитать поправку Бонферрони?
Порог 0,05 делят на число проверок m и с результатом сравнивают каждое p. Или, что то же самое, умножьте каждое p-value на число сравнений и сравните с 0,05; скорректированное p больше 1 не бывает, его обрезают до 1. В Excel это формула =МИН(1;p*m).
Чем поправка Холма отличается от Бонферрони?
Холм сортирует p-value и сравнивает самое маленькое с α / m, следующее с α / (m − 1) и так далее до первого незначимого. Защита от ложных находок та же, а находит он не меньше, часто больше. Поэтому вместо обычного Бонферрони рекомендуют Холма.
Когда использовать метод Бенджамини–Хохберга?
Когда сравнений много и задача разведочная: найденное потом проверят, а пропущенное различие обойдётся дороже лишнего. Метод держит долю ложных среди найденного в среднем не выше уровня значимости, но не обещает, что ложных не будет совсем.
Нужна ли поправка, если сравнений всего два-три?
При трёх проверках шанс ложной находки уже около 14% (1 − 0,95³). Часто поступают так: главную гипотезу, заявленную до сбора данных, проверяют без поправки, а остальные результаты помечают как разведочные или поправляют.
Почему поправку Бонферрони называют слишком строгой?
Она рассчитана на худший случай и не учитывает связь между проверками. На 50 сравнениях порог падает до 0,001, и часть настоящих различий теряется: в нашей модели Бонферрони находил 4 из 12 настоящих различий, а без поправки 9,8. Зато ложные без поправки проскакивали в 73% опросов.
Опубликовано 14 октября 2026