
 Анкетолог
 Typeform
 Тестограф
 Яндекс Формы
 Google Forms
 SurveyMonkey
 Microsoft Forms
 Online Test Pad
 Oprosso
 Simpoll


 Алексей Логинов
В двух филиалах средняя оценка отдела одинаковая, 7,0 из 10. Только в одном почти все поставили 6, 7 или 8, а в другом мнения разбежались от 4 до 10, и среднее этого не показывает.
Что такое F-критерий Фишера
F-критерий Фишера (F-test) — это статистический тест, который сравнивает две дисперсии через их отношение и проверяет, случаен ли перевес одной над другой.
F-критерий Фишера считают делением большей дисперсии на меньшую: при одинаковом разбросе F близок к 1, а значимым становится, когда превышает табличный порог для своих степеней свободы.
В работе с опросами F встречается в трёх местах. Им сравнивают разброс ответов двух групп. На нём держится дисперсионный анализ, где F показывает, различаются ли средние нескольких сегментов. И его выдаёт регрессия, когда проверяет модель целиком.
С точным тестом Фишера его путают из-за фамилии. Точный тест работает с таблицей 2×2 и долями, F-критерий с дисперсиями и средними.
Как сравнить разброс двух групп
Описательный анализ данных опросаВернёмся к филиалам. В каждом 40 анкет, оценка по шкале от 0 до 10, среднее 7,0. Дисперсия в филиале А 1,03, в филиале Б 4,05.
Насколько вероятно, что вы порекомендуете нас коллеге?
Вот и всё — такой опрос собирается за пару минут, а индекс WebAsk считает сам.
Создать свой опрос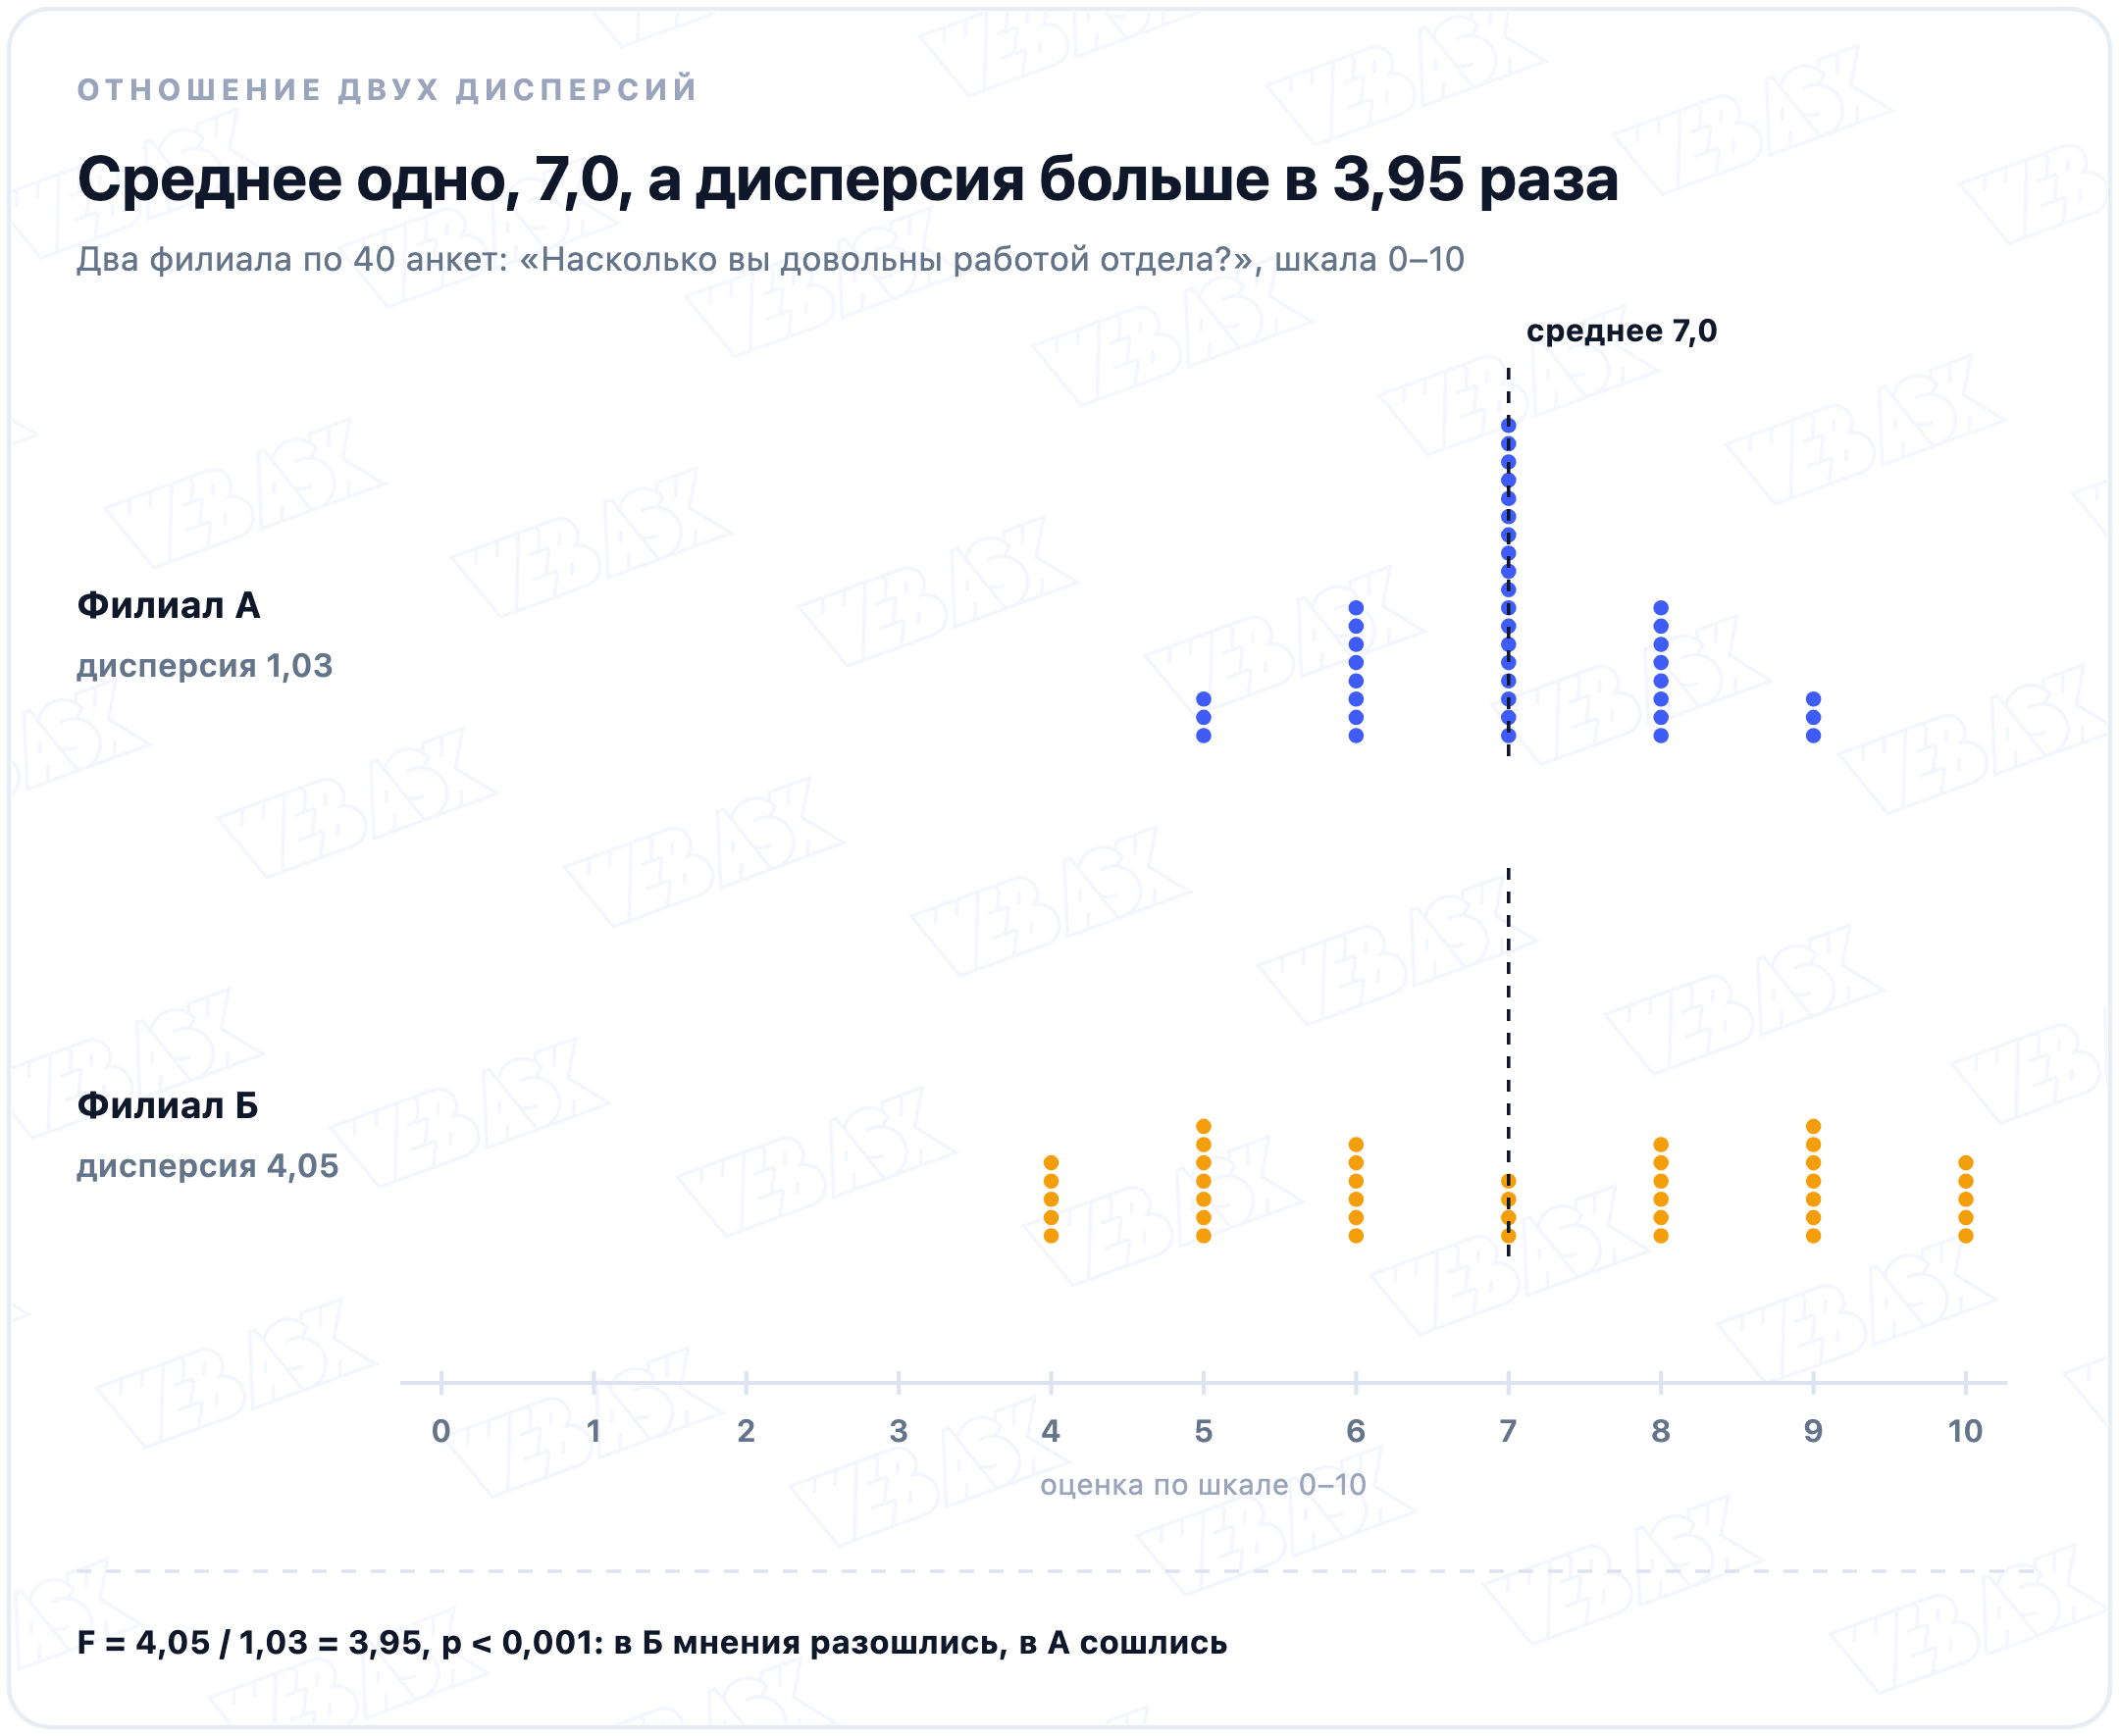
F = 4,05 / 1,03 = 3,95. Степеней свободы у каждой группы на одну меньше, чем анкет, то есть 39 и 39. Если настоящей разницы в разбросе нет, двусторонний порог при α = 0,05 для таких групп равен 1,89, а у нас почти вдвое больше: p меньше 0,001.
Вывод для отчёта простой. В Б мнения разошлись, и среднее 7,0 там описывает почти никого. Почти половина сотрудников этого филиала ставит отделу 8–10, почти половина 4–6, и разбирать стоит обе группы отдельно.
Разброс в опросе говорит о согласии людей. Одно и то же среднее при разной дисперсии ставит разные задачи: в А отдел всех устраивает примерно одинаково, в Б кого-то полностью, а кого-то подводит. Поэтому рядом со средним в отчёте показывают стандартное отклонение или межквартильный размах, а F-критерий отвечает на вопрос, не случайна ли разница в разбросе между группами.
Большую дисперсию всегда ставят в числитель, поэтому F не бывает меньше единицы. Зато порог берут двусторонний: при уровне значимости 0,05 его ищут для правого хвоста 0,025.
Сколько анкет нужно, чтобы увидеть разницу
Дисперсия на малой выборке сама по себе гуляет сильно. Поэтому F-критерий на десятке анкет почти слеп.
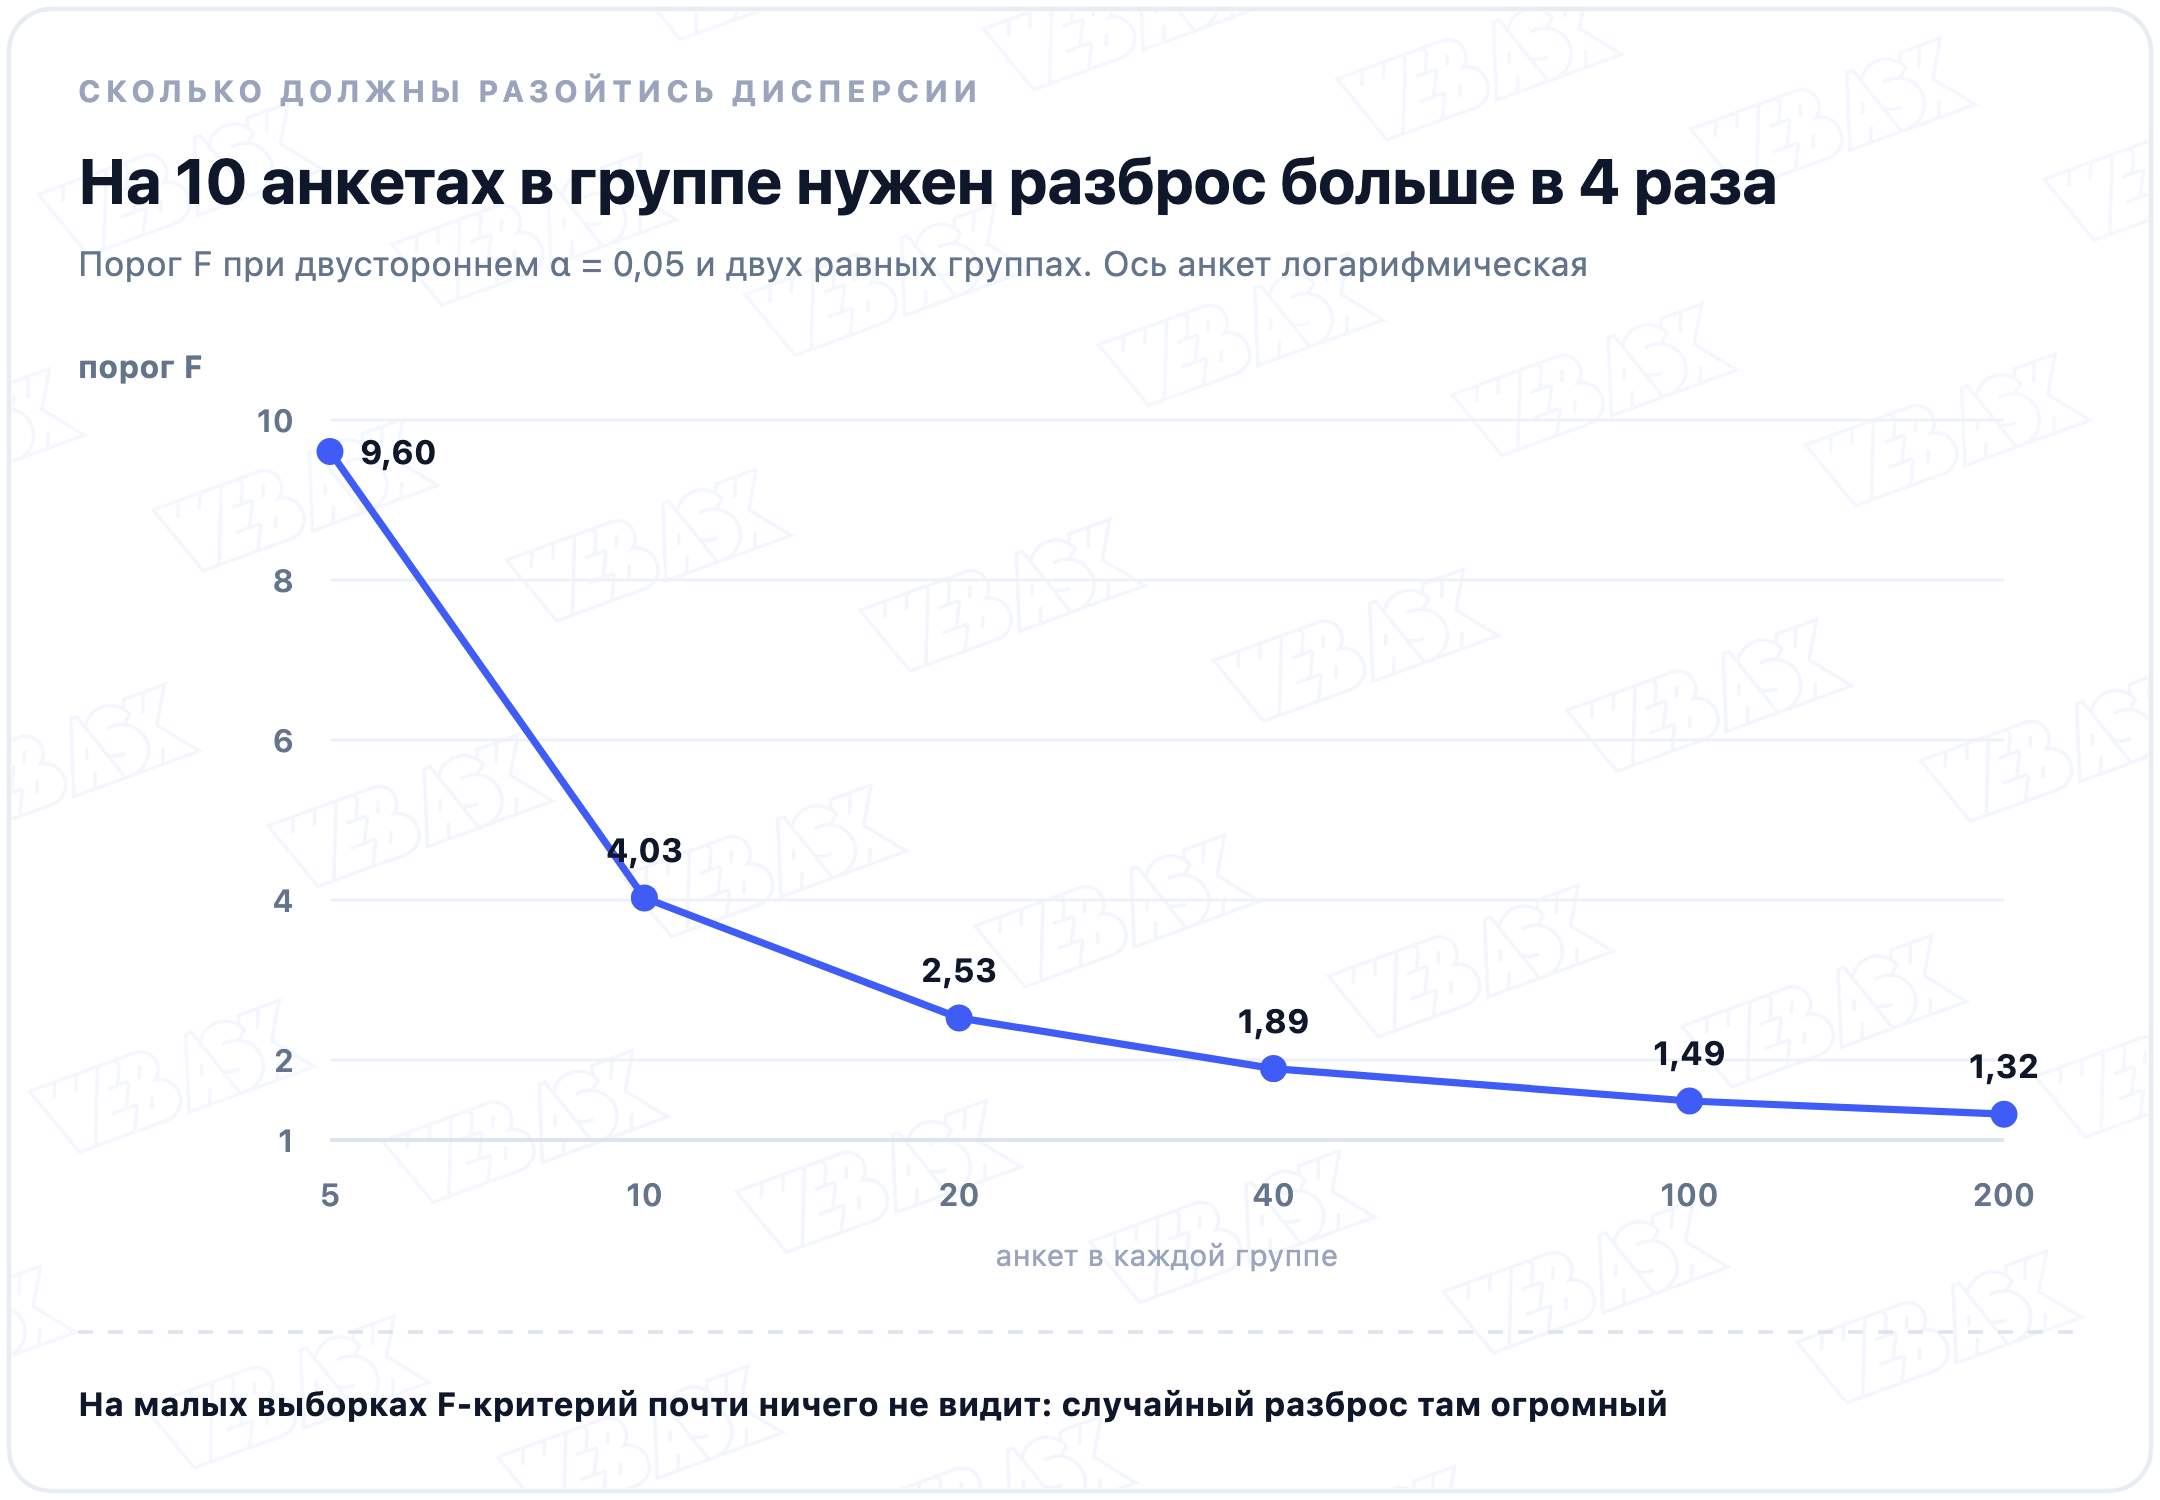
При пяти анкетах в группе одна дисперсия должна быть больше другой в 9,6 раза, при десяти в 4 раза. С сорока анкет хватает разницы в 1,9 раза, с двухсот в 1,3. Если групп по десять человек и F вышел незначимым, это ещё не значит, что разброс одинаковый: тест просто не мог его заметить.
Практический вывод для опросов: сравнивать разброс имеет смысл от нескольких десятков анкет в группе. На малых группах честнее показать ответы точками на одной шкале и не делать выводов о согласии.
F в дисперсионном анализе и регрессии
Сравнительный анализ группВ ANOVA F отвечает на другой вопрос: различаются ли средние нескольких групп. Считают его так же, отношением, только сверху стоит разброс между средними групп, а снизу разброс внутри групп. Если средние далеко друг от друга, а внутри групп тесно, F большой.
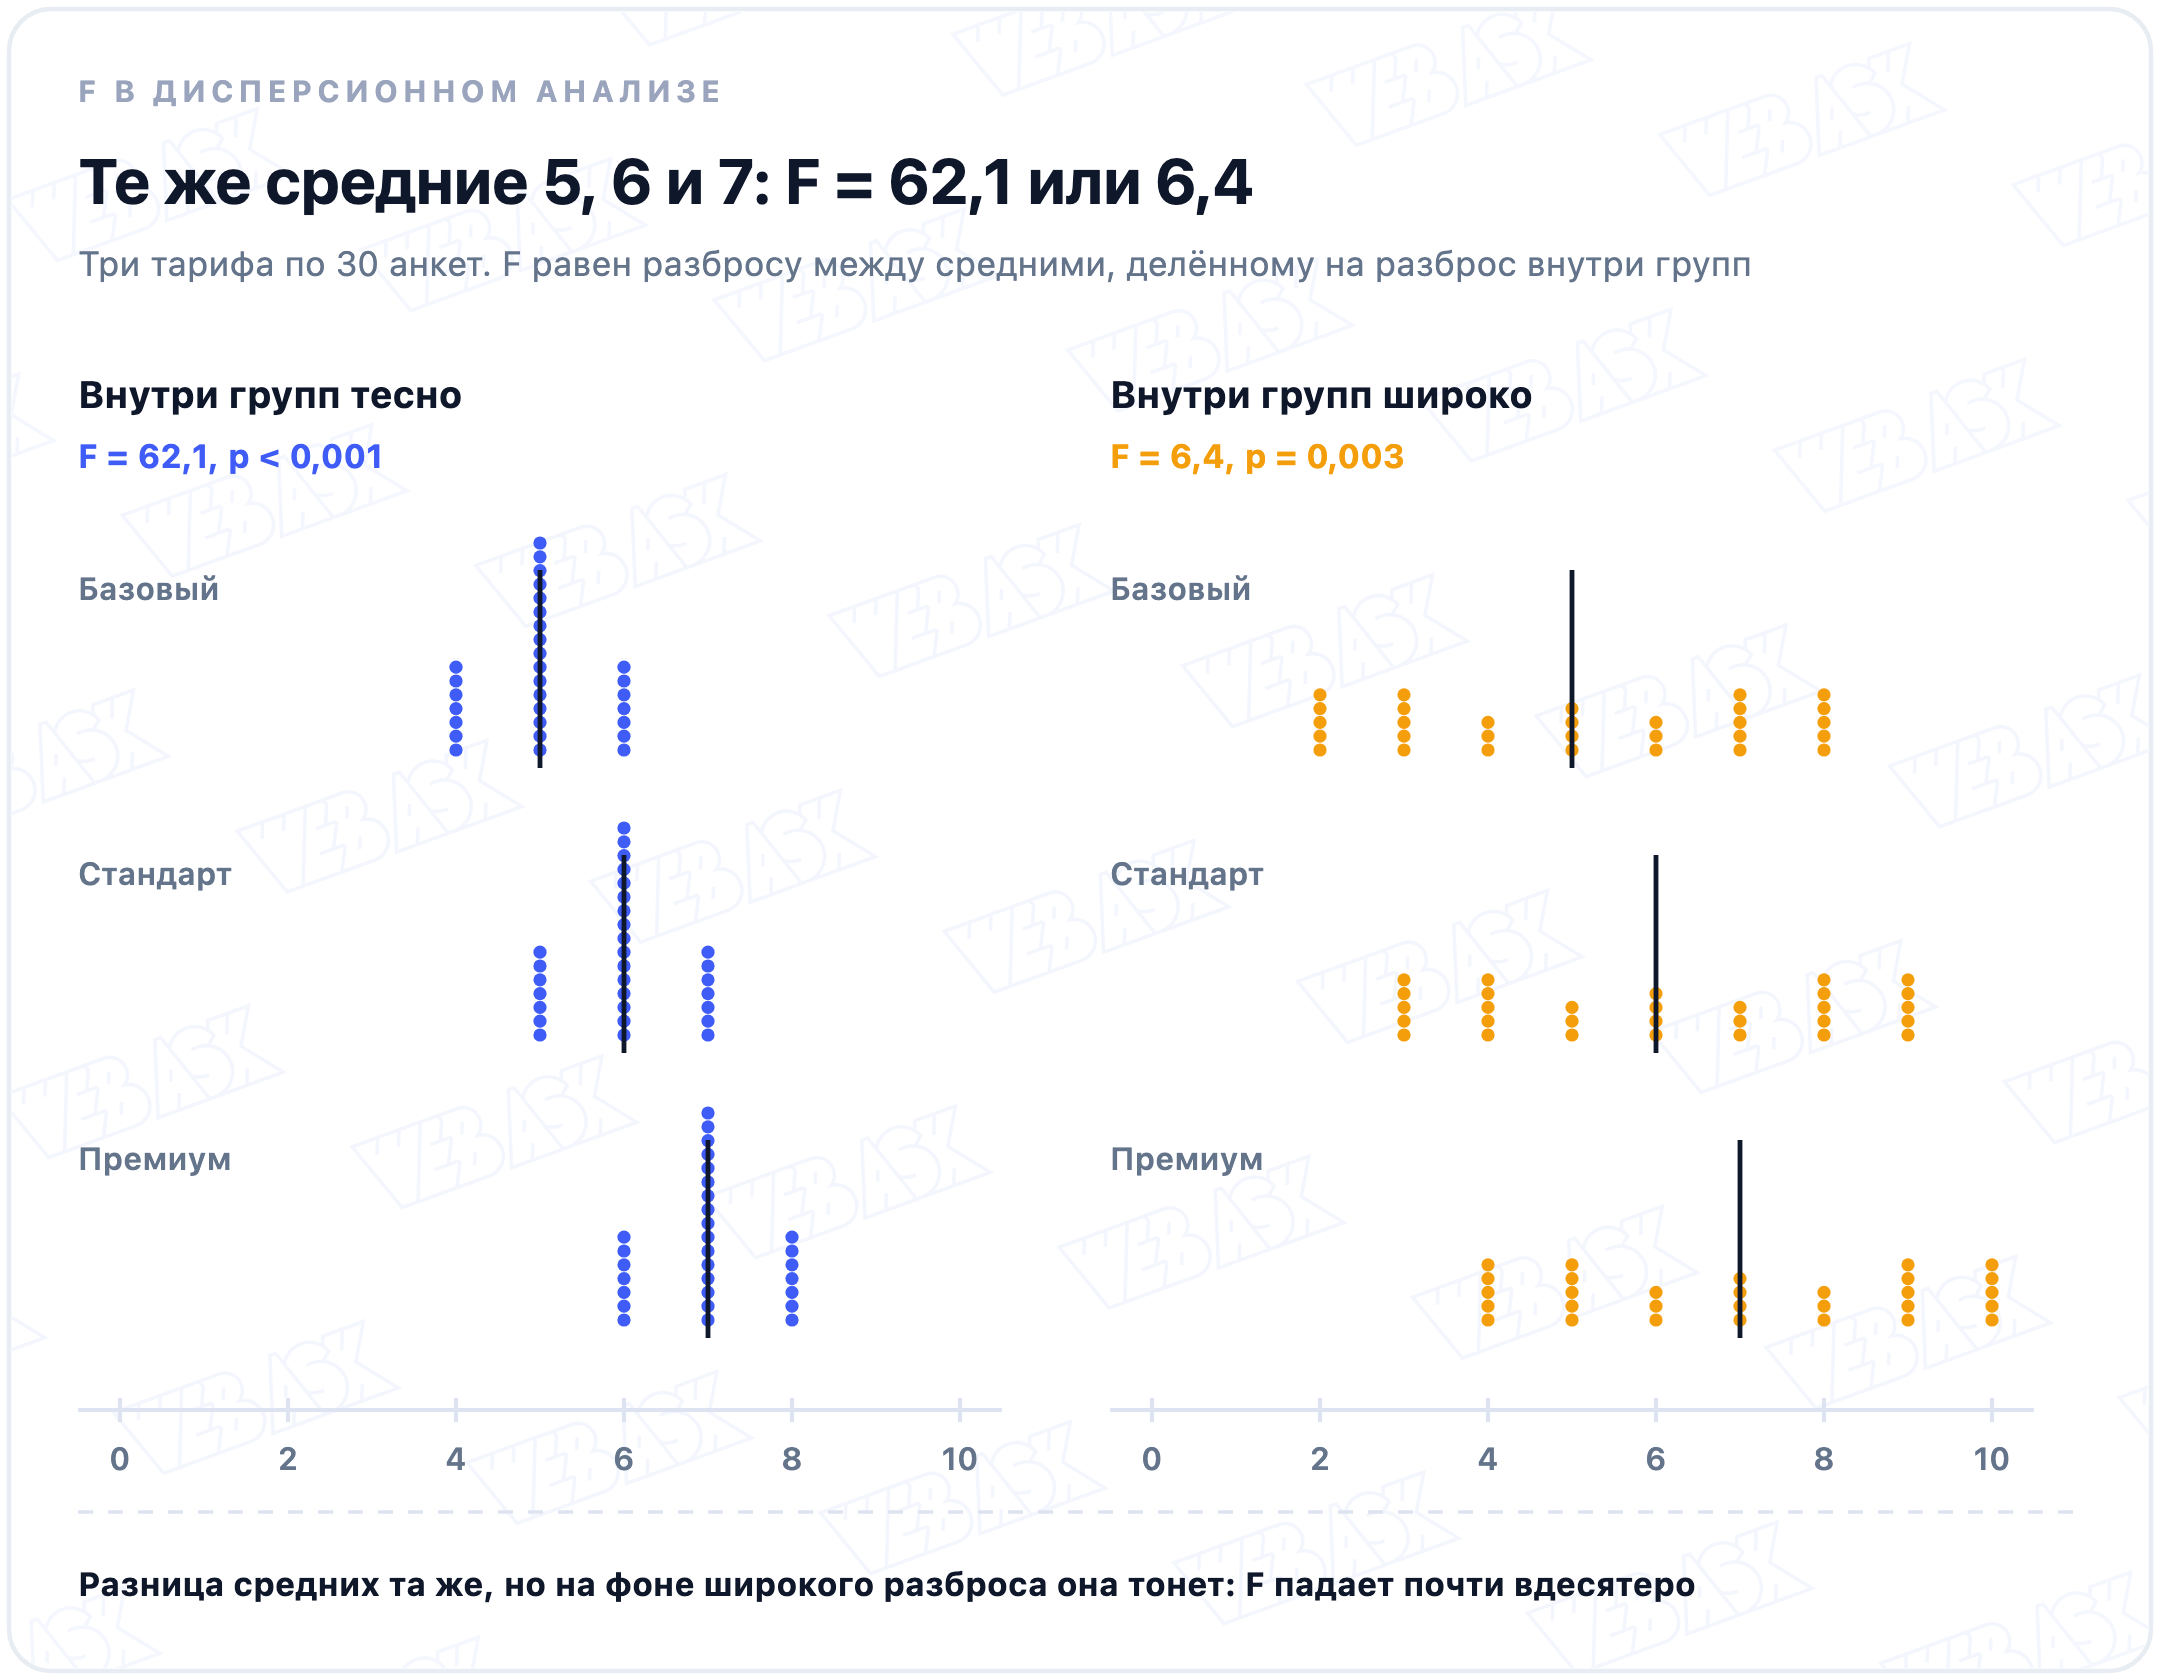
На картинке три тарифа по 30 анкет со средними 5, 6 и 7. При тесных ответах F = 62,1. При широких те же средние дают F = 6,4: разница всё ещё значима, порог для 2 и 87 степеней свободы равен 3,10, но запас уже небольшой. Ещё шире разброс, и тест перестанет её видеть.
В регрессии F проверяет модель целиком: объясняют ли все предикторы вместе хоть что-то сверх простого среднего. Значимый F при скромном R² встречается часто, особенно на больших выборках, и означает лишь, что модель лучше пустой.
Как посчитать F-критерий в Excel
Ответы двух групп лежат в двух столбцах, по анкете в строке.
- Дисперсии. Для каждой группы
=ДИСП.В(A2:A41), большую делите на меньшую. - p-value.
=F.ТЕСТ(A2:A41;B2:B41)сразу даёт двустороннюю вероятность. - Порог.
=F.ОБР.ПХ(0,025;39;39)вернёт 1,89, первым идёт число степеней свободы числителя.
Без Excel порог берут из таблицы. Ниже значения для правого хвоста 0,05, как в обычных таблицах ANOVA: столбцы это степени свободы числителя, строки знаменателя.
| Знаменатель | 1 | 2 | 3 | 5 |
|---|---|---|---|---|
| 5 | 6,61 | 5,79 | 5,41 | 5,05 |
| 10 | 4,96 | 4,10 | 3,71 | 3,33 |
| 20 | 4,35 | 3,49 | 3,10 | 2,71 |
| 30 | 4,17 | 3,32 | 2,92 | 2,53 |
| 60 | 4,00 | 3,15 | 2,76 | 2,37 |
| 120 | 3,92 | 3,07 | 2,68 | 2,29 |
Для сравнения двух дисперсий эта таблица соответствует двустороннему α = 0,10. Для двустороннего 0,05 нужна таблица хвоста 0,025 или функция Excel.
Когда F-критерий врёт
Сравнение двух дисперсий требует нормального распределения, и требует всерьёз. Джордж Бокс ещё в статье 1953 года показал, насколько этот тест чувствителен к форме распределения, куда сильнее, чем сравнение средних. А оценки по шкалам 0–10 и 1–5 редко бывают нормальными: упираются в потолок, скашиваются, собираются в два горба.
Поэтому для разброса ответов чаще берут критерий Левене: он сравнивает средние отклонения от центра группы и спокойнее переносит скос. SPSS выводит его рядом с t-тестом. Проверить нормальность можно критерием Шапиро–Уилка, но на десятках анкет и он мало что скажет.
Если же разброс проверяют лишь затем, чтобы выбрать вариант t-теста, проще сразу взять t-тест Уэлча: равных дисперсий он не требует.
Частые ошибки
- Путаница с точным тестом Фишера. Тот для долей в таблице 2×2, этот для дисперсий.
- Меньшая дисперсия в числителе. F выходит меньше единицы, и по обычной таблице его не прочитать.
- Односторонняя таблица для двустороннего вопроса. Порог занижен, ложных находок вдвое больше.
- Вывод по десятку анкет. Незначимый F на малых группах ничего не доказывает.
- F на скошенных шкалах. Результат зависит от формы распределения сильнее, чем от разброса.
Как это сделано в WebAsk
Ответы выгружаются в Excel, и там F считают по шагам выше. Если цель сравнить средние оценки сегментов, автопоиск различий делает это t-тестом Уэлча для всех пар сегментов, и проверять равенство дисперсий перед ним не нужно. Уровень значимости выбирают перед запуском, рядом с p выводится размер эффекта.
Коротко
- F-критерий делит одну дисперсию на другую, и F около 1 значит, что разброс одинаковый.
- Он проверяет разброс двух групп, средние в ANOVA и модель в регрессии.
- На малых выборках порог высокий: при 10 анкетах в группе нужна разница в 4 раза.
- В Excel работают F.ТЕСТ и F.ОБР.ПХ, в таблицах обычно хвост 0,05.
- На скошенных шкалах надёжнее критерий Левене.
Вопросы и ответы
Что такое F-критерий Фишера простыми словами?
Это проверка, случайно ли одна группа разбросана сильнее другой. Дисперсии делят друг на друга, и если отношение больше табличного порога, разница в разбросе считается значимой.
Чем F-критерий отличается от точного теста Фишера?
F-критерий сравнивает дисперсии и лежит в основе дисперсионного анализа. Точный тест Фишера проверяет связь в таблице 2×2 на малых выборках. Общая у них только фамилия автора.
Как найти табличное значение F-критерия?
В таблице по двум степеням свободы: числителя (столбец) и знаменателя (строка). В Excel то же значение даёт F.ОБР.ПХ(α;степени свободы числителя;степени свободы знаменателя).
Как посчитать F-критерий в Excel?
Функция F.ТЕСТ(массив1;массив2) сразу возвращает двустороннее p для двух столбцов. Само значение F получают делением большей дисперсии ДИСП.В на меньшую.
Сколько анкет нужно для F-критерия?
Чем больше, тем лучше. При 10 анкетах в группе дисперсии должны различаться в 4 раза, при 40 в 1,9 раза, при 200 в 1,3 раза. На десятке анкет разброс групп почти не сравнить.
Что показывает F-критерий в регрессии?
Объясняет ли модель хоть что-то лучше простого среднего. Значимый F не говорит, что модель хороша: это видно по R² и по ошибкам прогноза.
Что делать, если данные не нормальные?
Для сравнения разброса взять критерий Левене или Брауна–Форсайта, для сравнения средних t-тест Уэлча или непараметрический критерий. F-тест двух дисперсий к ненормальности особенно чувствителен.
Опубликовано 30 октября 2026