


Ранжирование (Ranking)
 Алексей Логинов Обновлено 3 сентября 2026 Время чтения ≈ 11 мин.
Ранжирование это тип вопроса, в котором респондент расставляет объекты по порядку: от самого важного к самому неважному. На выходе получается не оценка каждого объекта, а их взаимный порядок, и читать его надо иначе, чем оценки.
Что такое ранжирование
Формулировка выглядит так: «расставьте по важности: цена, качество, доставка, ассортимент, сервис». Каждый объект получает ранг: первый, второй, третий. Отличие от множественного выбора в том, что там порядок не фиксируется, отмеченные варианты равны между собой.
Ранг это порядковая величина. Он говорит, что цена важнее качества, но не говорит, насколько важнее, и не говорит, важна ли цена вообще. Из этого свойства растут почти все ошибки при анализе, поэтому дальше о них подробно.
Ранжирование против оценивания по шкале
Альтернатива ранжированию это оценить каждый объект по шкале. Так проще для отвечающего, но появляется знакомая беда: человек ставит всему высокие оценки, и приоритеты не проявляются. Ранжирование вынуждает различить.
Насколько это меняет итог, проверяли не раз. В расщеплённом эксперименте на General Social Survey 1980 года порядок тринадцати качеств у двух форматов почти совпал, корреляция вышла 0,966. Оговорку тут надо сделать сразу: полного ранжирования там не было, респондента просили выбрать три самых и три наименее желательных качества, а корреляция считана по тринадцати пунктам, не по людям. Так что три знака после запятой обманчивы.
Более свежее сравнение дало ту же картину с уточнением. В рандомизированном исследовании Дель Гранде и Качоровского на списке из 41 пункта первые шесть приоритетов у обеих групп совпали, а расхождения начались с седьмого места и приходились на пункты средней важности.
Отсюда практическое правило. Нужен топ-3 «что важнее в среднем по выборке» это формат почти не изменит ответ. Нужны расстояния между пунктами, порог важности или порядок в хвосте списка это формат ответ изменит.
Платить за это приходится временем. В том же исследовании на списке из шестнадцати пунктов группа с оцениванием потратила в среднем 12,1 минуты, а группа с ранжированием 21,0 минуты. Выборка там небольшая, 36 человек, но направление совпадает с остальными работами.
Сколько объектов человек способен упорядочить
Здесь в ходу правило «не больше пяти», и происхождение у него неожиданное. Оно попало в отраслевой справочник в разделе про телефонные опросы, где список приходится держать в голове, и ссылки на исследование при нём нет. А главный методический источник по дизайну анкет, глава Кросника и Прессера, никакого предела вообще не устанавливает.
Подпирать этот предел «магическим числом семь» Миллера нельзя, хотя так делают часто. Миллер писал про точность абсолютных суждений и про объём непосредственной памяти, а совпадение семёрок сам называл случайностью, а не законом.
Что известно из измерений. Время растёт вместе с длиной списка почти линейно: примерно семь секунд на сам вопрос плюс около пяти секунд на каждый объект, то есть десять объектов это около минуты. Но число объектов объясняет лишь половину разброса в субъективной трудности: упорядочить десять близких по смыслу объектов оказалось так же тяжело, как двадцать хорошо различимых. Значит ориентироваться надо на содержание списка, а не на одну его длину.
А вот сколько людей вообще справляется с задачей.
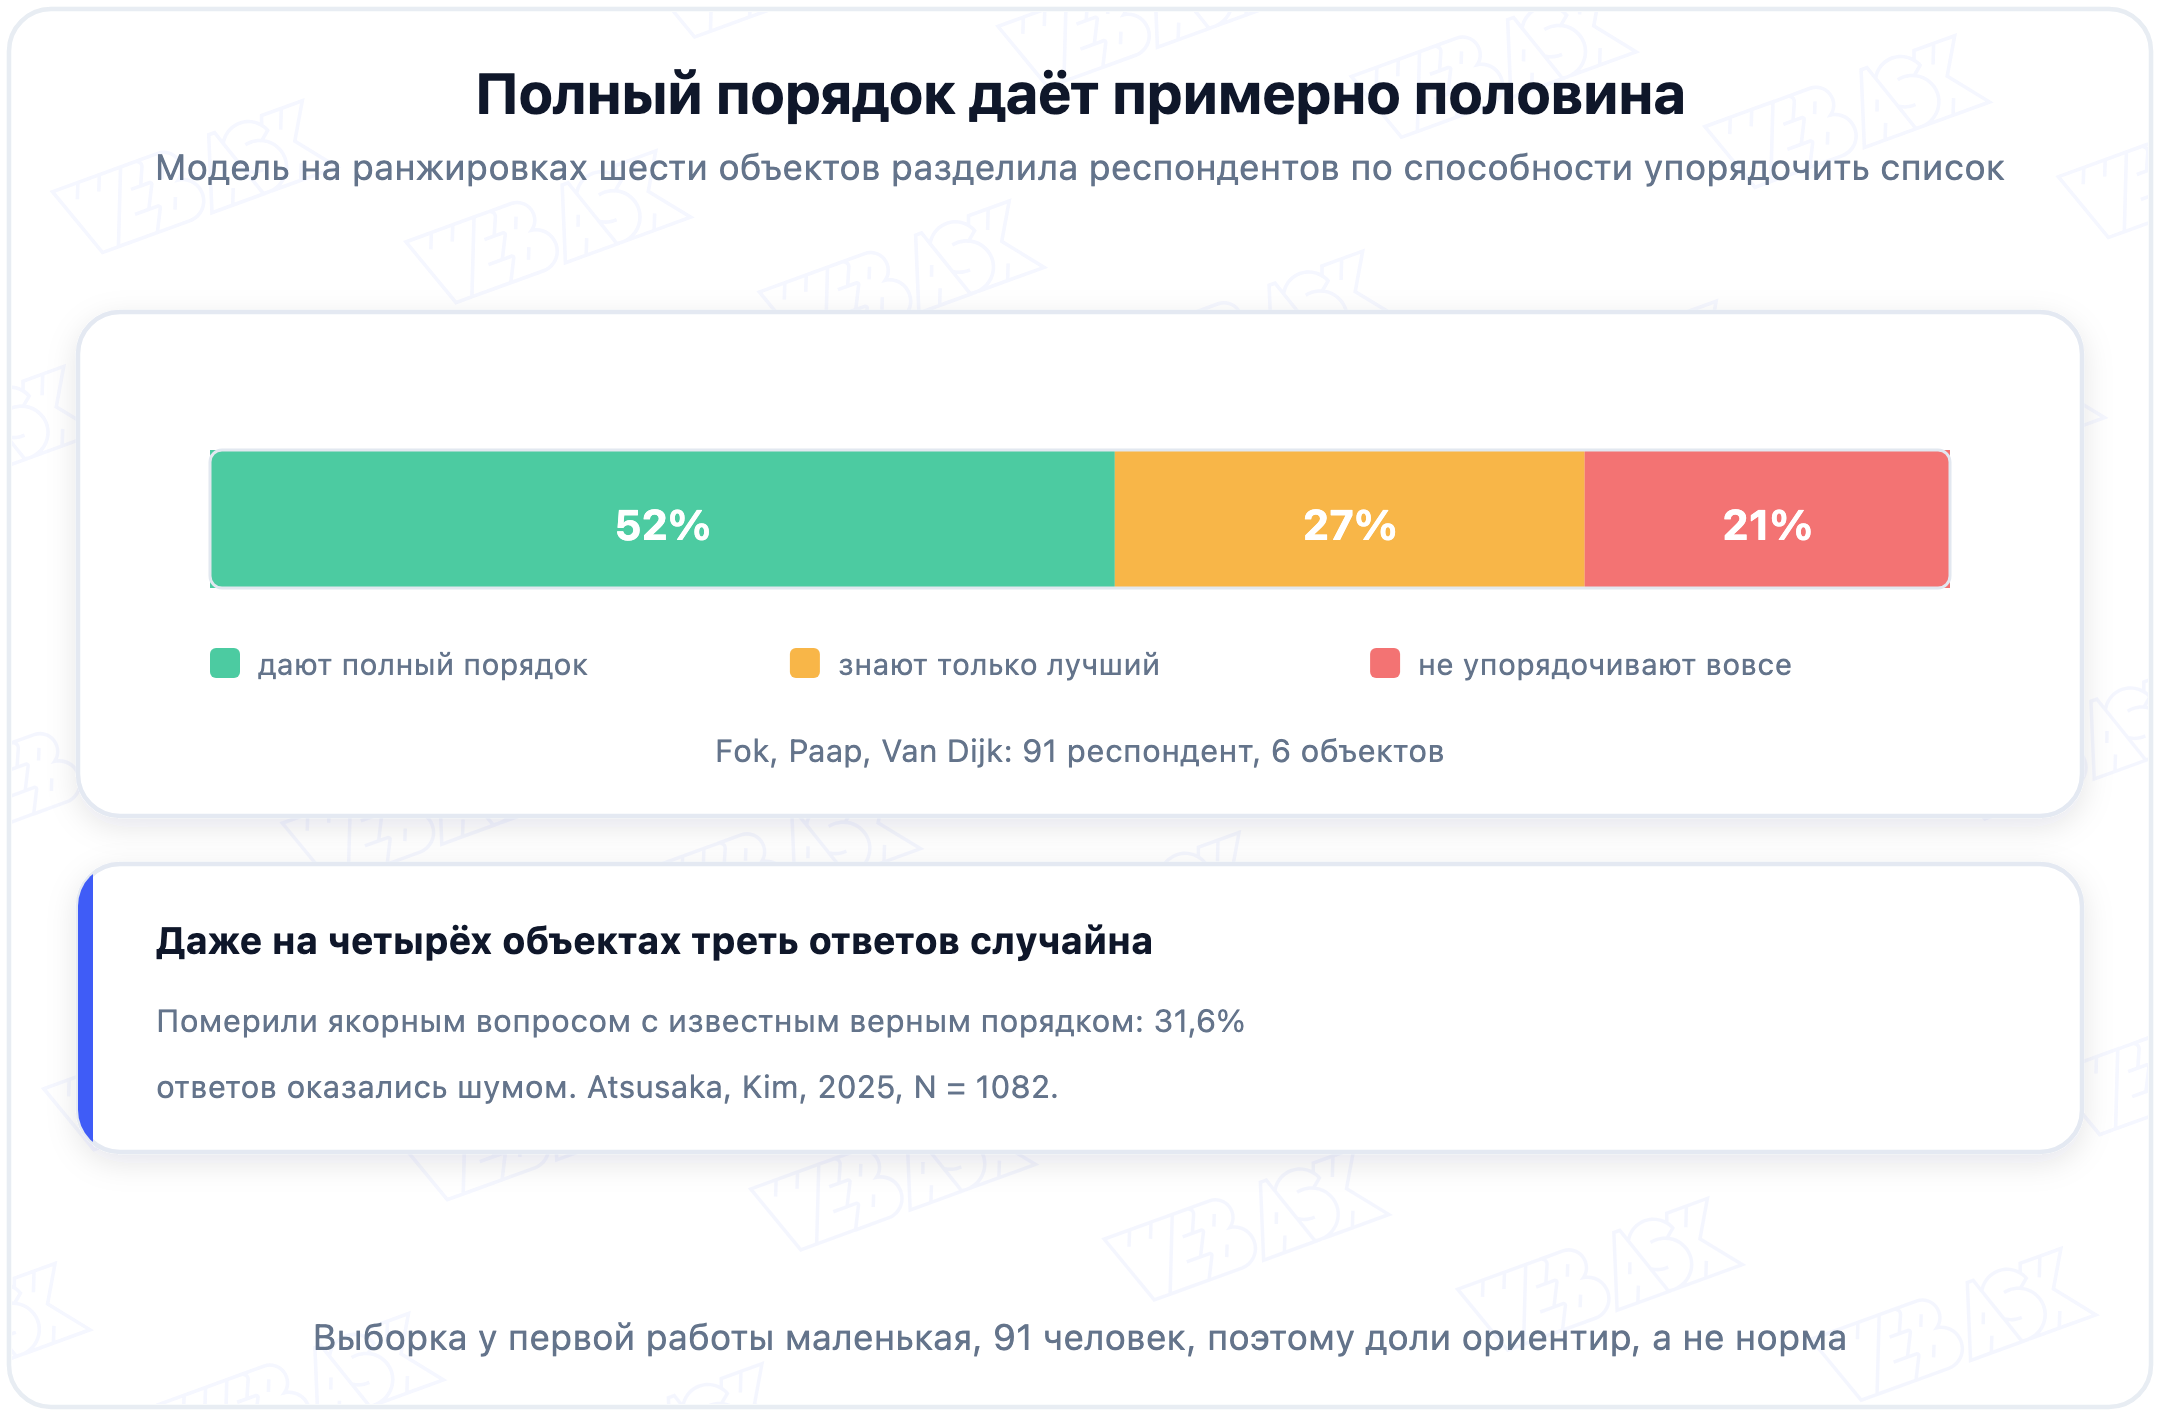
Модель на ранжировках шести объектов разделила респондентов на три группы: полный порядок дают около половины, четверть надёжно указывает только самый предпочитаемый объект, а пятая часть не упорядочивает вовсе. Выборка там 91 человек, так что доли это ориентир, а не норма.
Отдельно измерили, сколько в ранжировании шума. Через якорный вопрос с объективно верным порядком получилось, что даже на четырёх объектах около трети ответов не несёт информации о предпочтениях.
Перетаскивание записывает ранжировку за того, кто её не делал
Это главная практическая ловушка, и она про интерфейс, а не про методику.
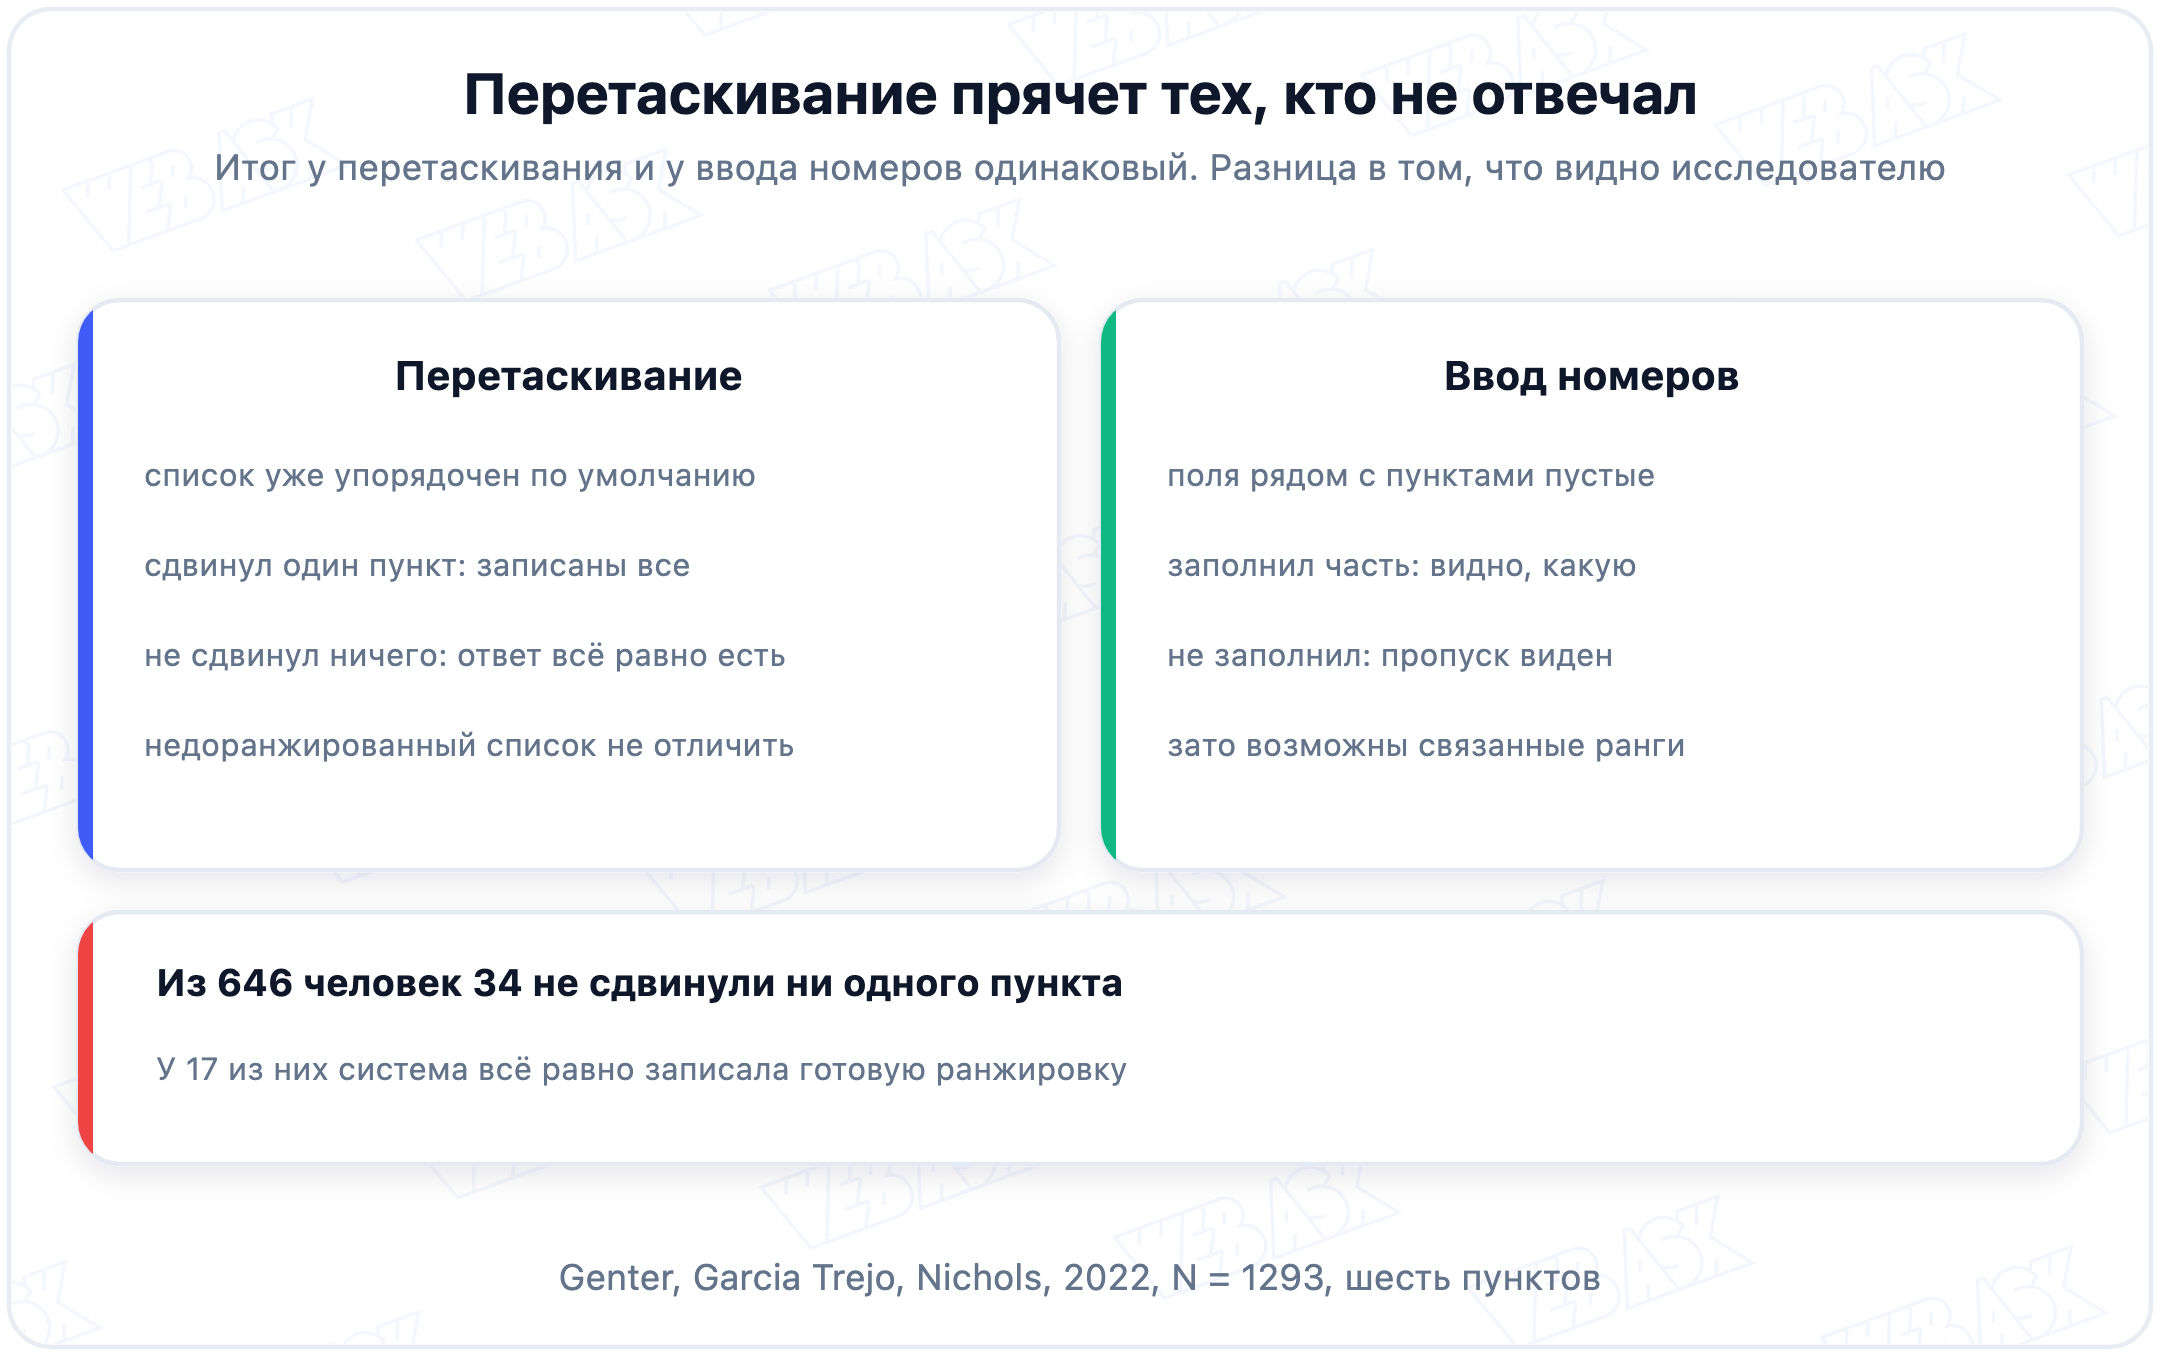
В рандомизированном эксперименте перетаскивание и ввод номеров дали одинаковую итоговую ранжировку и одинаковое время на вопрос. Разница оказалась в другом: перетаскивание физически не показывает, что человек часть списка не ранжировал. Либо записаны все пункты, либо ни один, а достаточно сдвинуть один пункт, чтобы система записала порядок остальных. Из 646 человек в этом условии 34 не сдвинули ни одного пункта, и у 17 из них ответ всё равно оказался записан.
Небрежный ответ выглядит соответственно: список остаётся в том порядке, в котором его показали. В данных это видно как перекос. При четырёх объектах и рандомизированном порядке ответ «как предъявлено» встретился в 8,8% случаев, тогда как при полной случайности ожидалось бы 4,2%. Обратный порядок тоже встречался чаще ожидаемого.
Рандомизация порядка тут помогает только частично. Она убирает направленный сдвиг в пользу первых пунктов, но сами случайные ответы никуда не деваются: после рандомизации они распределяются равномерно и стягивают итог к картине «респондентам всё равно», размывая реальные различия.
Есть и более общая беда: инструкцию к вопросу на ранжирование не выполняет большая доля отвечающих. В почтовом опросе даже в лучшем из двух проверенных форматов правильно ответили лишь около двух третей. Отклонения при этом узнаваемые: проранжировали больше пунктов, чем просили, дали двум пунктам одинаковый ранг, упорядочили часть списка, упорядочили один пункт.
Как читать ранги
Начнём с вопроса, который задают чаще всего: законно ли считать средний ранг, если ранг это порядковая величина. Формально среднее по порядковой шкале не определено, и спор об этом идёт с работы Стивенса 1946 года, где оговорку сделал сам автор классификации.
Для ранжирования спор во многом беспредметен. Упорядочить объекты по среднему рангу это в точности метод Борда, только записанный иначе: «средневзвешенный ранг», который печатают платформы опросов, равен числу объектов плюс один минус средний ранг, то есть даёт тот же порядок. А на реальных данных средний ранг оказался почти неотличим от строгой модели: у Эллисона и Кристакиса 475 врачей ранжировали восемь способов поддержания жизни, и порядок по среднему рангу совпал с оценками разложенного логита везде, кроме одной перестановки соседних позиций.
Настоящие ловушки другие, и их две.
Первая: отрицательная связь между объектами это артефакт. Сумма рангов у каждого респондента зафиксирована, при пяти объектах это всегда 15. Поэтому ранги двух объектов отрицательно коррелируют сами по себе, без всякой связи между объектами. Величина известна заранее и равна минус единице, делённой на число объектов минус один.
| Объектов в списке | Корреляция рангов двух объектов |
|---|---|
| 3 | минус 0,50 |
| 4 | минус 0,33 |
| 5 | минус 0,25 |
| 10 | минус 0,11 |
Вывод «чем важнее цена, тем менее важно качество» из такой матрицы делать нельзя: это свойство арифметики, а не мнений.
Вторая: средний ранг маскирует раскол. Объект со средним рангом 3,0 из пяти это и «все поставили третьим», и «половина поставила первым, половина пятым». В первом случае доля первых мест ноль, во втором пятьдесят процентов, а среднее одинаковое.
Поэтому средний ранг показывают не в одиночку. Методисты, работающие с ранжированием, перечисляют четыре величины:
- средний ранг, для общего порядка
- распределение рангов по позициям, оно и вскрывает раскол
- доля попаданий в топ-k, удобна для отчёта
- вероятность парного превосходства, сколько раз объект оказался выше конкретного соперника
Из критериев чаще всего берут критерий Фридмана и коэффициент конкордации Кендалла. Полезно знать, что это одна и та же статистика на одной и той же таблице, различаются они формулировкой нулевой гипотезы. И у коэффициента конкордации нет отрицательной половины: расколотая аудитория даёт ноль, то есть то же число, что и полный хаос.
Ранжирование в WebAsk
В конструкторе это отдельный тип вопроса. Настраиваются варианты ответа, случайный порядок вариантов, сортировка по алфавиту и обязательность ответа.
Случайный порядок стоит включать всегда, когда порядок вариантов не несёт смысла: это снимает направленный сдвиг в пользу первых пунктов, то есть эффект первичности. Обязательность закрывает вторую дыру, ту самую, из-за которой нетронутый список записывается как готовый ответ.
Проверить свои данные можно грубой прикидкой: посмотрите, как часто встречается ранжировка, точно совпадающая с порядком предъявления. Если чаще, чем даёт случайность, часть респондентов список не трогала.
Когда нужен MaxDiff, а когда хватит ранжирования
MaxDiff, он же наилучшее-наихудшее шкалирование, показывает не весь список, а по четыре-пять объектов за раз и просит указать в наборе самый и наименее важный. Метод предложил Джордан Луивьер, каноническая книга у Луивьера, Флинна и Марли.
Экономность считается прямо: два клика в наборе из четырёх объектов раскрывают пять парных сравнений из шести, а в наборе из пяти семь из десяти. На выходе получается не порядок, а шкала со сравнимыми расстояниями, поэтому баллы можно складывать и переводить в проценты. При равных затратах на разметке словаря метод дал воспроизводимость выше, чем шкальная оценка.
Но есть важная оговорка в пользу простого ранжирования. Когда баллы усредняют по всей выборке, MaxDiff и обычные форматы дают практически один и тот же порядок объектов. Так что если вам нужен только общий рейтинг по выборке, ранжирования достаточно. MaxDiff нужен, когда требуются оценки отдельных респондентов или сегментов, либо когда важны расстояния между объектами. Для решений о составе продукта и цене берут conjoint-анализ.
И его собственное ограничение: баллы чисто относительные. Видно, что один объект важнее другого, но не видно, важен ли хоть один в абсолютном смысле. Для ответа на вопрос «важно или неважно вообще» нужен добавочный якорный вопрос.
MaxDiff Рейтинговая шкала (Rating Scale)Коротко
- Ранг говорит о порядке, но не о величине разрыва и не об абсолютной важности.
- Правило «не больше пяти объектов» пришло из телефонных опросов и исследованием не подкреплено. Ориентируйтесь на содержание списка, а не на одну длину.
- Полный порядок даёт примерно половина отвечающих, а треть ответов шум даже на четырёх объектах.
- Перетаскивание записывает готовую ранжировку за того, кто ничего не двигал. Спасает обязательность вопроса и проверка на совпадение с порядком показа.
- Отрицательная связь в матрице рангов это артефакт фиксированной суммы, а не вывод о мнениях.
- Средний ранг показывайте вместе с распределением по позициям, иначе раскол аудитории не увидите.
Вопросы и ответы
Сколько вариантов давать на ранжирование?
Жёсткого предела в литературе нет, распространённое «не больше пяти» взято из телефонных опросов без исследования за ним. Смотрите на содержание: близкие по смыслу объекты утомляют не меньше, чем длинный список хорошо различимых. Время считается примерно как семь секунд на вопрос плюс пять секунд на объект.
Можно ли считать средний ранг?
Для итогового порядка можно. Упорядочивание по среднему рангу это метод Борда, и на реальных данных оно почти совпадает с оценками строгих моделей. Но показывать средний ранг в одиночку нельзя: он не отличает единодушие от раскола.
Почему в матрице рангов всё отрицательно связано?
Потому что сумма рангов у каждого респондента фиксирована. При пяти объектах корреляция рангов двух объектов равна минус 0,25 просто по арифметике. Содержательного смысла в этой связи нет.
Чем ранжирование отличается от оценивания по шкале?
Ранжирование вынуждает различить объекты, оценивание позволяет поставить всему одинаково высоко. Итоговый топ у двух форматов обычно совпадает, а вот расстояния между объектами и порядок в хвосте списка расходятся. Ранжирование при этом дольше: на списке из шестнадцати пунктов вышло 21,0 минуты против 12,1 у оценивания.
Что делать с неполными ответами?
Сначала решить, возможны ли они у вас: при перетаскивании неполный ответ обычно записывается как полный, и отличить его нельзя. Если ранжируются номера в поля, неполные ответы видны, и их надо обрабатывать сознательно, а не молча выбрасывать: тех, кто упорядочил только верх списка, в выборке заметная доля.
Обновлено 3 сентября 2026 Опубликовано 23 февраля 2026
