
 Анкетолог
 Typeform
 Тестограф
 Яндекс Формы
 Google Forms
 SurveyMonkey
 Microsoft Forms
 Online Test Pad
 Oprosso
 Simpoll


 Алексей Логинов
Спросите людей, что важно при выборе фитнес-клуба, и в анкете почти всё легко окажется «очень важным». Шкала разрешает ставить высокие оценки всему подряд, а в паре один из вариантов приходится уступить.
Что такое метод парных сравнений
Метод парных сравнений (Paired Comparison) — это способ узнать порядок предпочтений, при котором варианты показывают парами и просят выбрать один из двух.
Метод парных сравнений превращает эти выборы в шкалу: у каждого варианта считают долю выигранных сравнений, а модель Брэдли–Терри переводит их в вероятность, что один вариант предпочтут другому.
Шкалировать суждения через пары предложил психолог Луис Терстоун в 1927 году в статье о законе сравнительного суждения. Через 25 лет Ральф Брэдли и Милтон Терри описали модель, которая из побед и поражений вычисляет силу каждого варианта. Исходные данные у обеих моделей одни и те же: кто у кого выиграл.
Метод берут, когда вариантов немного, а различаются они слабо: критерии выбора, названия продукта, упаковки, льготы для сотрудников. На том же принципе стоит метод анализа иерархий Томаса Саати, только там эксперты сравнивают критерии попарно по шкале силы предпочтения, а не выбирают один из двух.
Сколько пар получится
Если сравнить каждый вариант с каждым, пар выходит n × (n − 1) / 2. Пять вариантов дают 10 пар, восемь уже 28, десять 45. Число растёт почти квадратично: каждый новый вариант добавляет столько пар, сколько вариантов было до него.
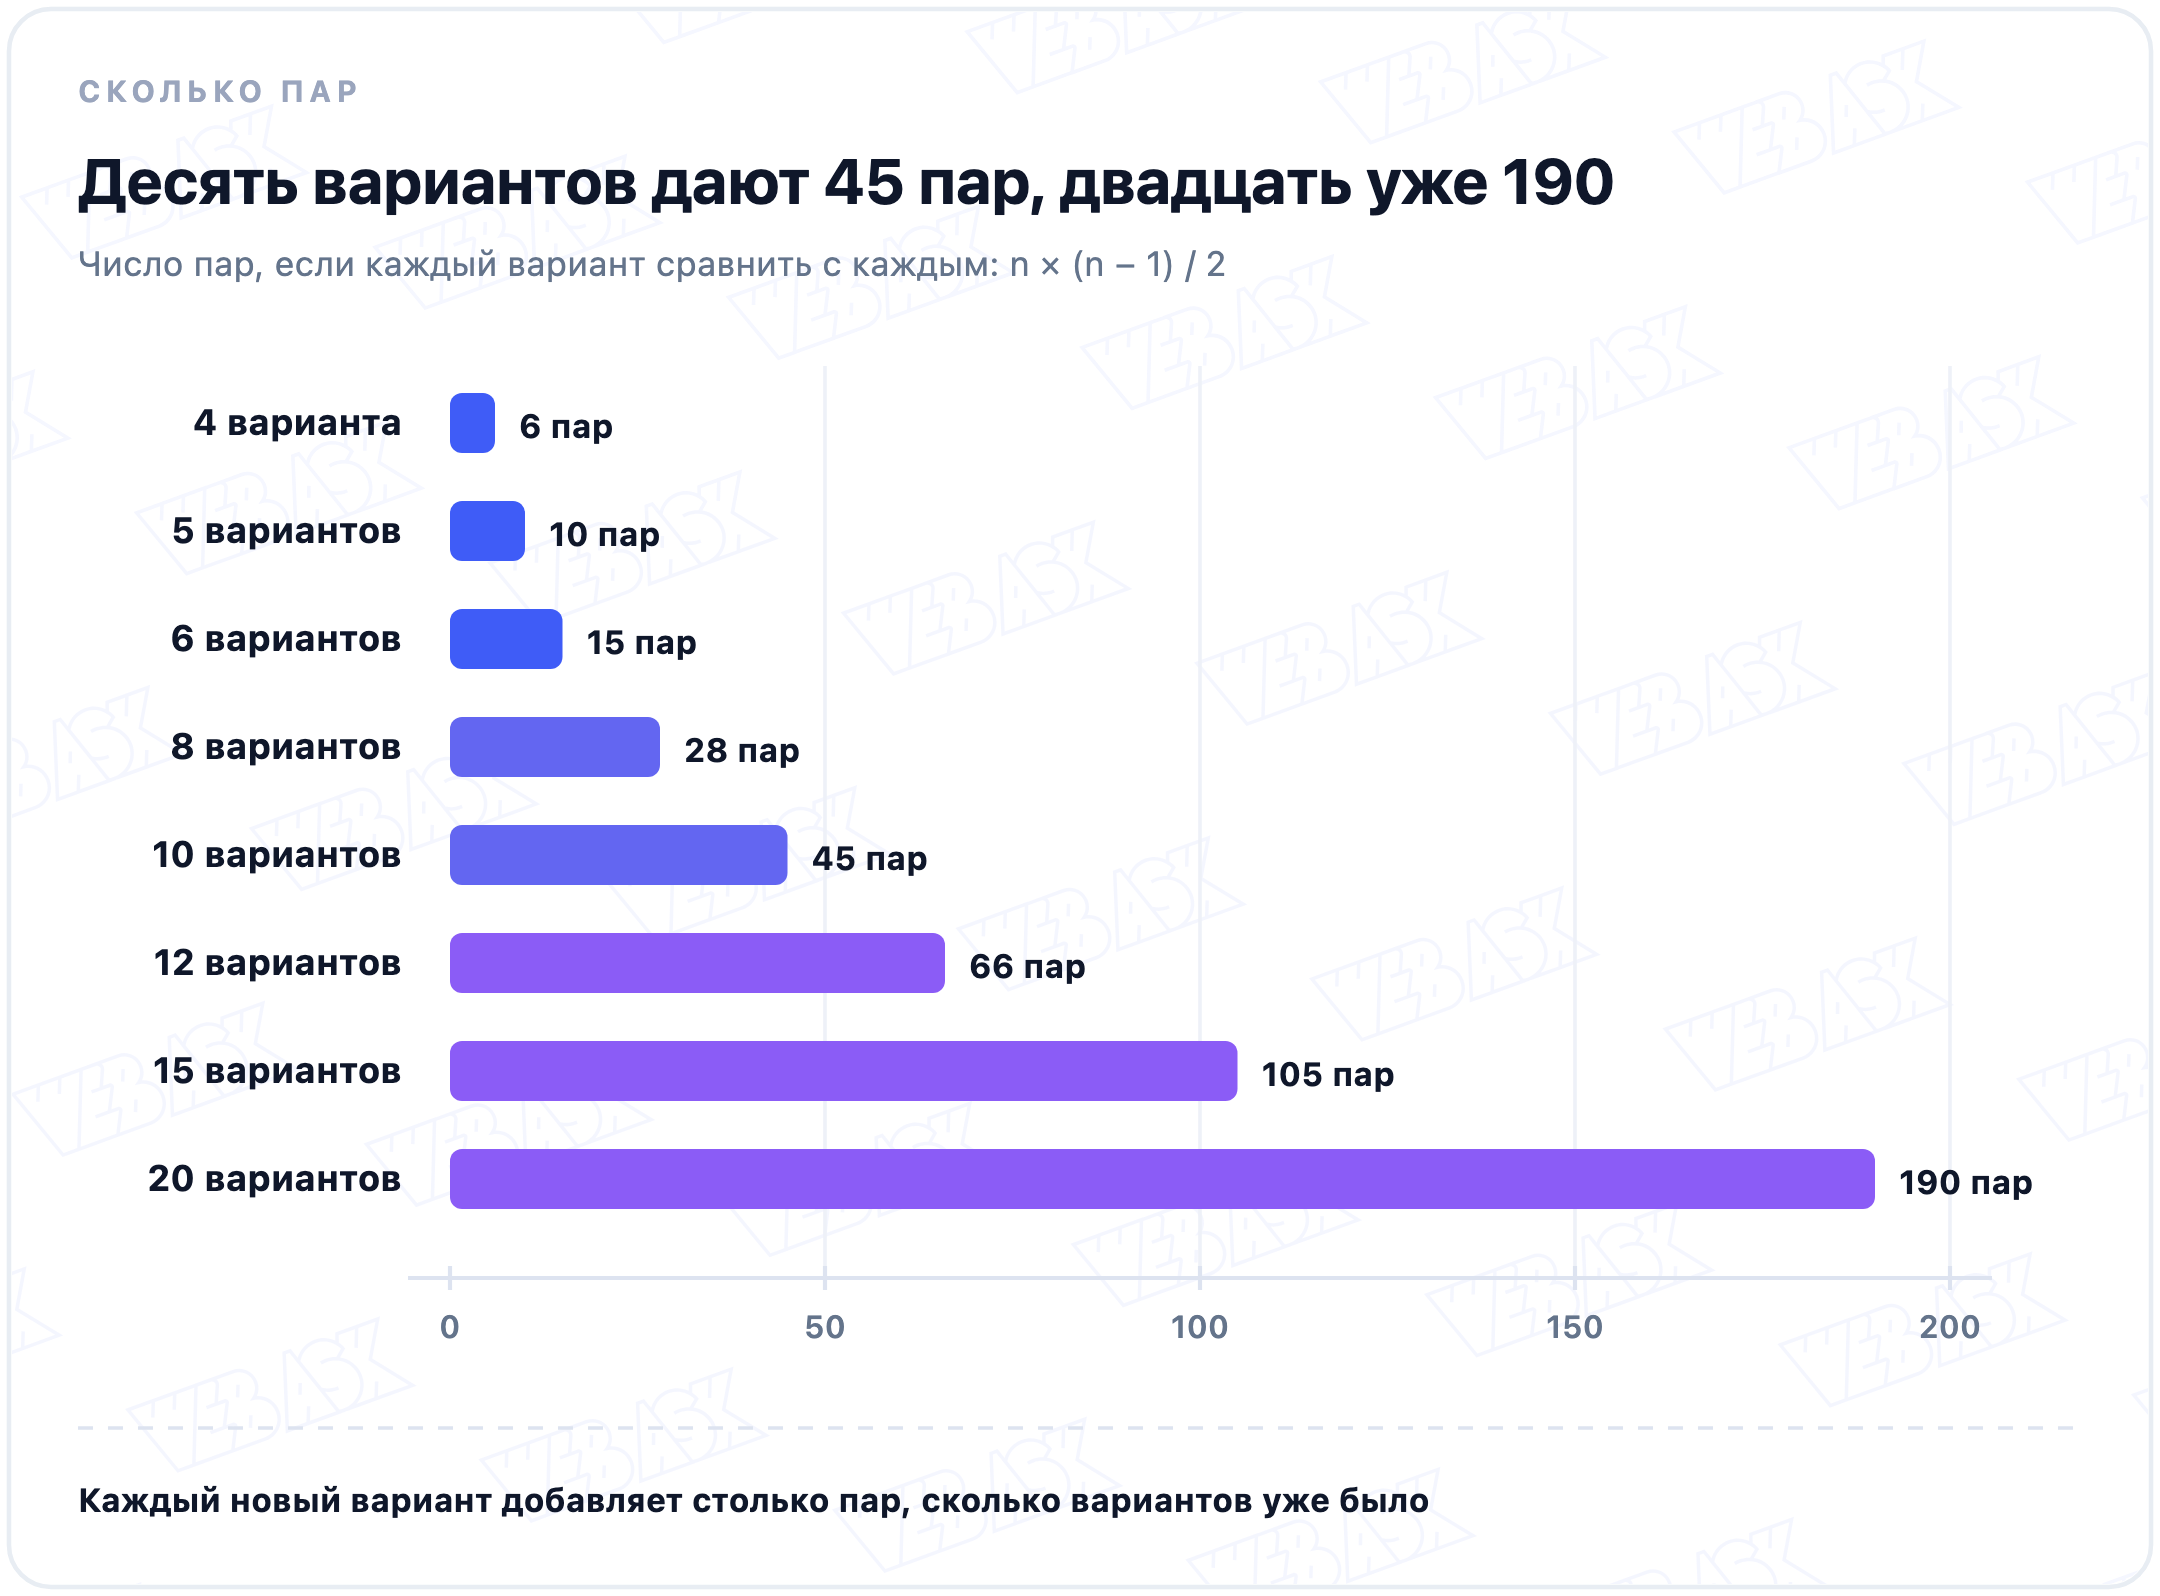
На десяти вариантах это 45 экранов подряд, поэтому полный план держат коротким. Большой набор делят на группы или показывают каждому участнику только часть пар: модель Брэдли–Терри соберёт общую шкалу и из неполных данных. Другой выход даёт MaxDiff: в наборе из четырёх вариантов человек отмечает лучший и худший, и два клика раскрывают пять пар из шести.
Как провести
- Один критерий на весь опрос. «Что для вас важнее при выборе клуба?», а не «что лучше?»: иначе каждый сравнивает по своему основанию.
- Каждая пара на своём экране, а порядок пар случайный, чтобы сравнения меньше влияли друг на друга.
- Левый и правый вариант меняют местами. Порядок внутри пары тоже влияет (сказывается эффект первичности), и случайная сторона его гасит.
- Нужен ли ответ «одинаково»? Без него выбор чище, с ним честнее, когда разницы правда нет. Если добавили, ничью считают как половину победы каждому.
- Длина плана тоже часть дизайна: 45 пар подряд для участника уже работа, и к концу ответы становятся небрежнее. Так работает усталость от опроса.
Как читать матрицу парных сравнений
Возьмём условный пример. Фитнес-клуб выбирал, что подчеркнуть в рекламе, и попросил 80 человек сравнить пять критериев выбора: близость к дому, цену абонемента, тренеров, расписание и оборудование. Каждый прошёл все 10 пар. Результаты складывают в матрицу: в клетке стоит доля участников, выбравших вариант из строки против варианта из столбца.
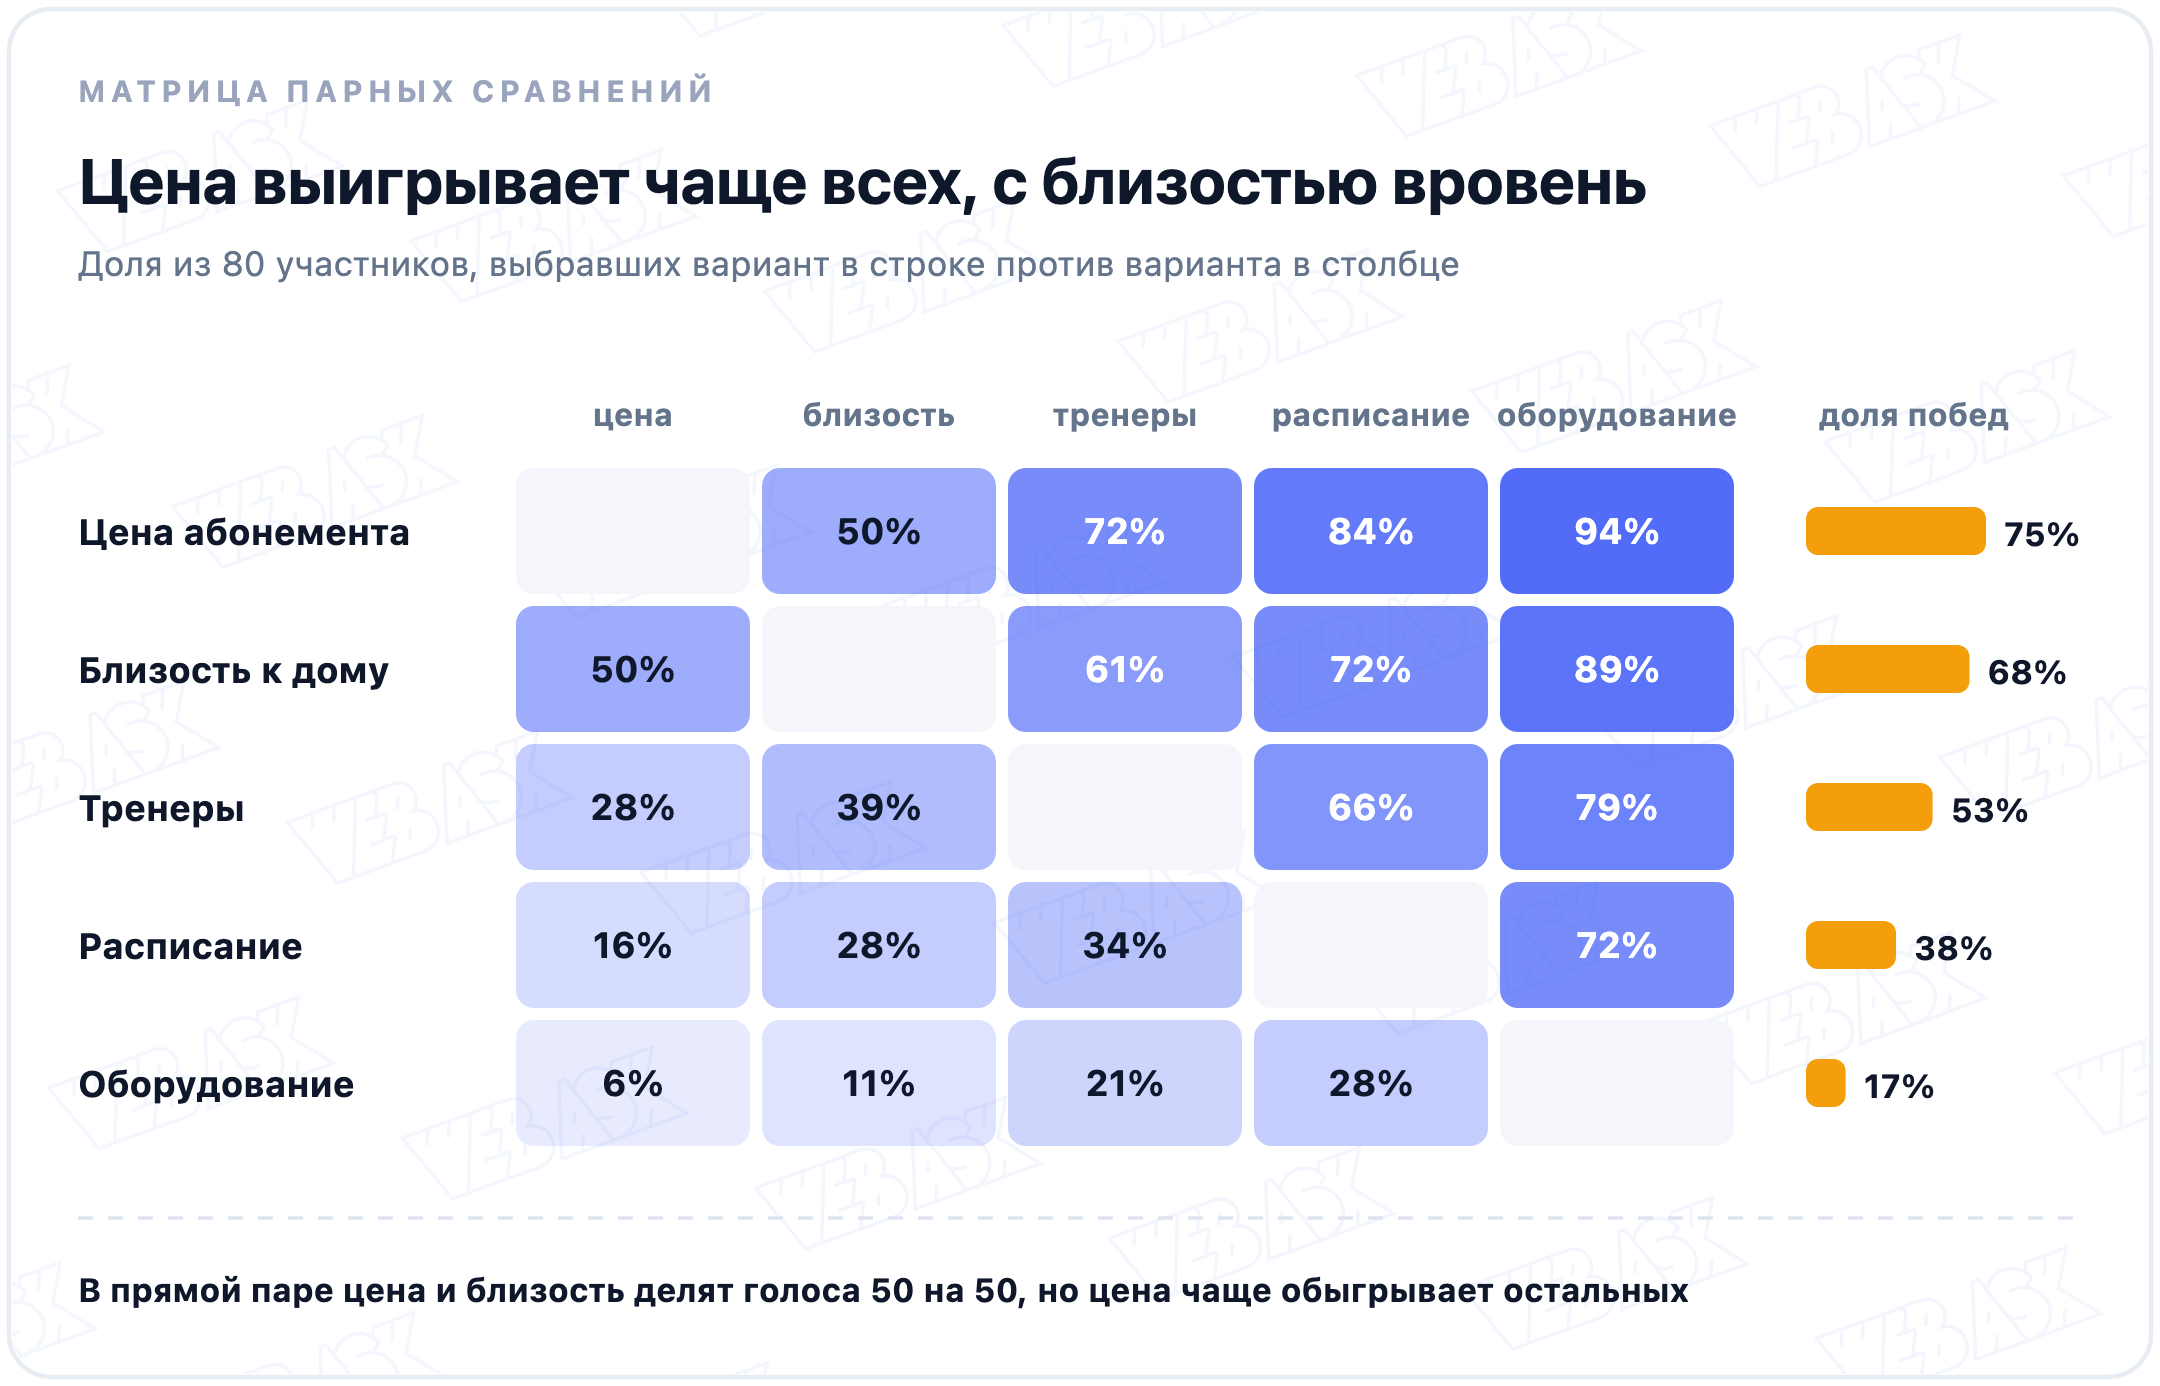
Строка «Цена абонемента» читается так: против близости цену выбрали 50% участников, против тренеров 72%, против оборудования 94%. Справа доля побед, то есть сколько из своих 320 сравнений вариант выиграл. У цены это 75%, у оборудования 17%. В среднем по всем вариантам доля побед всегда 50%: в каждой паре один выигрывает, другой проигрывает.
Итоговая колонка прячет одну деталь. Цена и близость в прямой паре сыграли вничью, 40 голосов на 40, а вперёд цену вывели победы над остальными. Сказать по этим данным «цена важнее близости» нельзя. Можно сказать, что цена реже проигрывает слабым соперникам.
Отдельную клетку тоже не стоит читать буквально. При 80 участниках доля в одной паре гуляет примерно на ±11 пунктов: для 50% это интервал от 39 до 61%. Значит, 55% против 45% в одной паре ещё не победа, а 72% против 28% уже да.
Сила вариантов: модель Брэдли–Терри
Доля побед зависит от того, с кем вариант сравнивали. Модель Брэдли–Терри даёт каждому варианту силу, и вероятность выбрать A против B в ней равна силе A, делённой на сумму сил A и B. В примере силы, если привести их к сумме 100, вышли такие: цена 40, близость 30, тренеры 17, расписание 9, оборудование 4.
Из сил получаются предсказания для любой пары. Цене против тренеров модель даёт вероятность 40 / (40 + 17), около 70%, в данных было 72%. Близость против оборудования модель оценивает в 89%, в данных тоже 89%. Если по какой-то паре ответов мало или нет совсем, модель всё равно даёт оценку, на этом и держатся неполные планы.
Проверка на противоречия
Человек предпочёл цену близости, близость тренерам, а тренеров цене. Это круговая тройка: такие ответы друг другу противоречат. Тройки считают для каждого участника, а Морис Кендалл и Бернард Бабингтон Смит в 1940 году предложили из них коэффициент согласованности. При пяти вариантах он равен единице минус число круговых троек, делённое на 5: больше пяти таких троек у пяти вариантов не бывает.
В примере 69 участников из 80 ответили без единой круговой тройки, 10 допустили одну, один две. Одна тройка обычно значит, что два варианта для человека почти равны. Много троек у одного участника похоже на ответы наугад, такие анкеты стоит разобрать отдельно, как при поиске недобросовестных ответов.
Чего метод не показывает
Как расставить приоритеты по модели КаноАбсолютной важности. Если все пять критериев людям безразличны, матрица всё равно выстроит их по порядку. Насколько каждый критерий важен сам по себе, покажет отдельный вопрос со шкалой.
Выбор из двух молчит и о силе предпочтения: человек мог выбрать цену с трудом или не задумываясь. Где это важно, берут шкалу силы, как в методе анализа иерархий: «немного важнее», «намного важнее».
Причину выбора матрица тоже не объяснит. Почему цена обыгрывает тренеров, расскажет открытый вопрос или интервью.
Частая ошибка: читать долю побед как долю людей
75% побед у цены не значат, что 75% участников считают цену главным критерием. Это доля выигранных сравнений, и в ней смешаны все соперники, сильные и слабые. Добавьте в набор шестой критерий, который всем безразличен, и доля побед у всех остальных вырастет, хотя мнения людей не изменились.
Для отчёта честнее давать матрицу целиком или силы по Брэдли–Терри: отношение сил двух вариантов в модели не зависит от того, кто ещё был в наборе. А узнать, что для человека главное, проще отдельным вопросом с одним выбором.
Как это сделано в WebAsk
«Парное сравнение» в WebAsk устроено как отдельный тип вопроса. В настройках задаются пары, к каждому варианту можно добавить картинку, например фото упаковки. Порядок пар перемешивается по желанию, а режим показа по одной паре за раз выводит каждую пару отдельным экраном. Тип доступен в тарифах начиная с «Базового».
Ответы выгружаются в Excel или CSV, и матрица собирается в таблице: для каждой пары считают, сколько раз выбрали каждый вариант. Если вариантов больше пяти-шести, удобнее разбить их на два вопроса или заменить часть пар вопросом на ранжирование.
Коротко
- Полный план растёт быстро: 10 пар на пять вариантов, 45 на десять.
- Матрица показывает каждую пару, доля побед даёт общий порядок, модель Брэдли–Терри переводит его в силы и вероятности.
- Круговые тройки ловят противоречивые и случайные ответы.
- В WebAsk для метода есть тип вопроса «Парное сравнение» со случайным порядком пар.
Вопросы и ответы
Чем метод парных сравнений отличается от ранжирования?
Ранжирование просит расставить все варианты сразу, а середину длинного списка людям расставлять труднее всего. Парное сравнение дробит ту же задачу на выборы из двух. Плата за это: число экранов, на пять вариантов их уже 10.
Сколько вариантов можно сравнивать?
Полный план из n вариантов даёт n × (n − 1) / 2 пар: 10 на пять, 28 на восемь, 45 на десять. Для больших наборов каждому участнику показывают часть пар или берут MaxDiff.
Что такое матрица парных сравнений?
Таблица, где в строках и столбцах одни и те же варианты, а в клетке доля людей, выбравших вариант из строки против варианта из столбца. Клетки, симметричные относительно диагонали, в сумме дают 100%.
Нужна ли модель Брэдли–Терри, если есть доля побед?
Для порядка хватает доли побед. Модель нужна, когда пары показывали не всем, когда хочется предсказать исход любой пары или сравнить силы, которые не зависят от состава набора.
Как метод связан с методом анализа иерархий Саати?
Метод Саати тоже строит матрицу парных сравнений, но эксперт оценивает силу предпочтения по шкале от 1 до 9, а не просто выбирает. Его берут для весов критериев в решениях, а парное сравнение в опросе для предпочтений аудитории.
Опубликовано 2 октября 2026