
 Анкетолог
 Typeform
 Тестограф
 Яндекс Формы
 Google Forms
 SurveyMonkey
 Microsoft Forms
 Online Test Pad
 Oprosso
 Simpoll


 Алексей Логинов
На первых 20 анкетах довольны 85% клиентов, к сотой анкете 74%, к тысячной 70%, и сервис за это время не менялся. Цифра просто успокаивается, когда ответов становится больше.
Что такое закон больших чисел
Закон больших чисел (law of large numbers) — это теорема о том, что с ростом числа независимых наблюдений их среднее приближается к истинному среднему.
Калькулятор размера выборки Сколько респондентов нужно опросить? Формула Кокрена с поправкой на FPC ПосчитатьЗакон больших чисел верен и для долей, потому что доля ответов «да» тоже среднее, только из нулей и единиц.
Для частот закон доказал Якоб Бернулли в книге «Искусство предположений», она вышла в 1713 году, уже после смерти автора. Название «закон больших чисел» дал Симеон Пуассон в книге 1837 года, где объяснял им, на чём держится морское страхование. Общую форму для средних в 1867 году доказал Пафнутий Чебышёв.
Страховщик не знает, у кого из клиентов случится авария, но по тысячам договоров уверенно знает долю аварий и на ней строит тарифы. Опрос устроен так же: ответ отдельного клиента непредсказуем, а доля довольных среди сотен ответов устойчива.
С центральной предельной теоремой закон часто путают. Закон больших чисел говорит, куда приходит среднее, а ЦПТ описывает, как распределены его отклонения: колоколом, шириной σ/√n.
Как закон работает в опросе
Сколько ответов нужно для опросаПредставим пять одинаковых опросов, где на самом деле довольны 70% клиентов. Ответы приходят по одному, и после каждого считаем долю довольных.
Насколько вероятно, что вы порекомендуете нас коллеге?
Вот и всё — такой опрос собирается за пару минут, а индекс WebAsk считает сам.
Создать свой опрос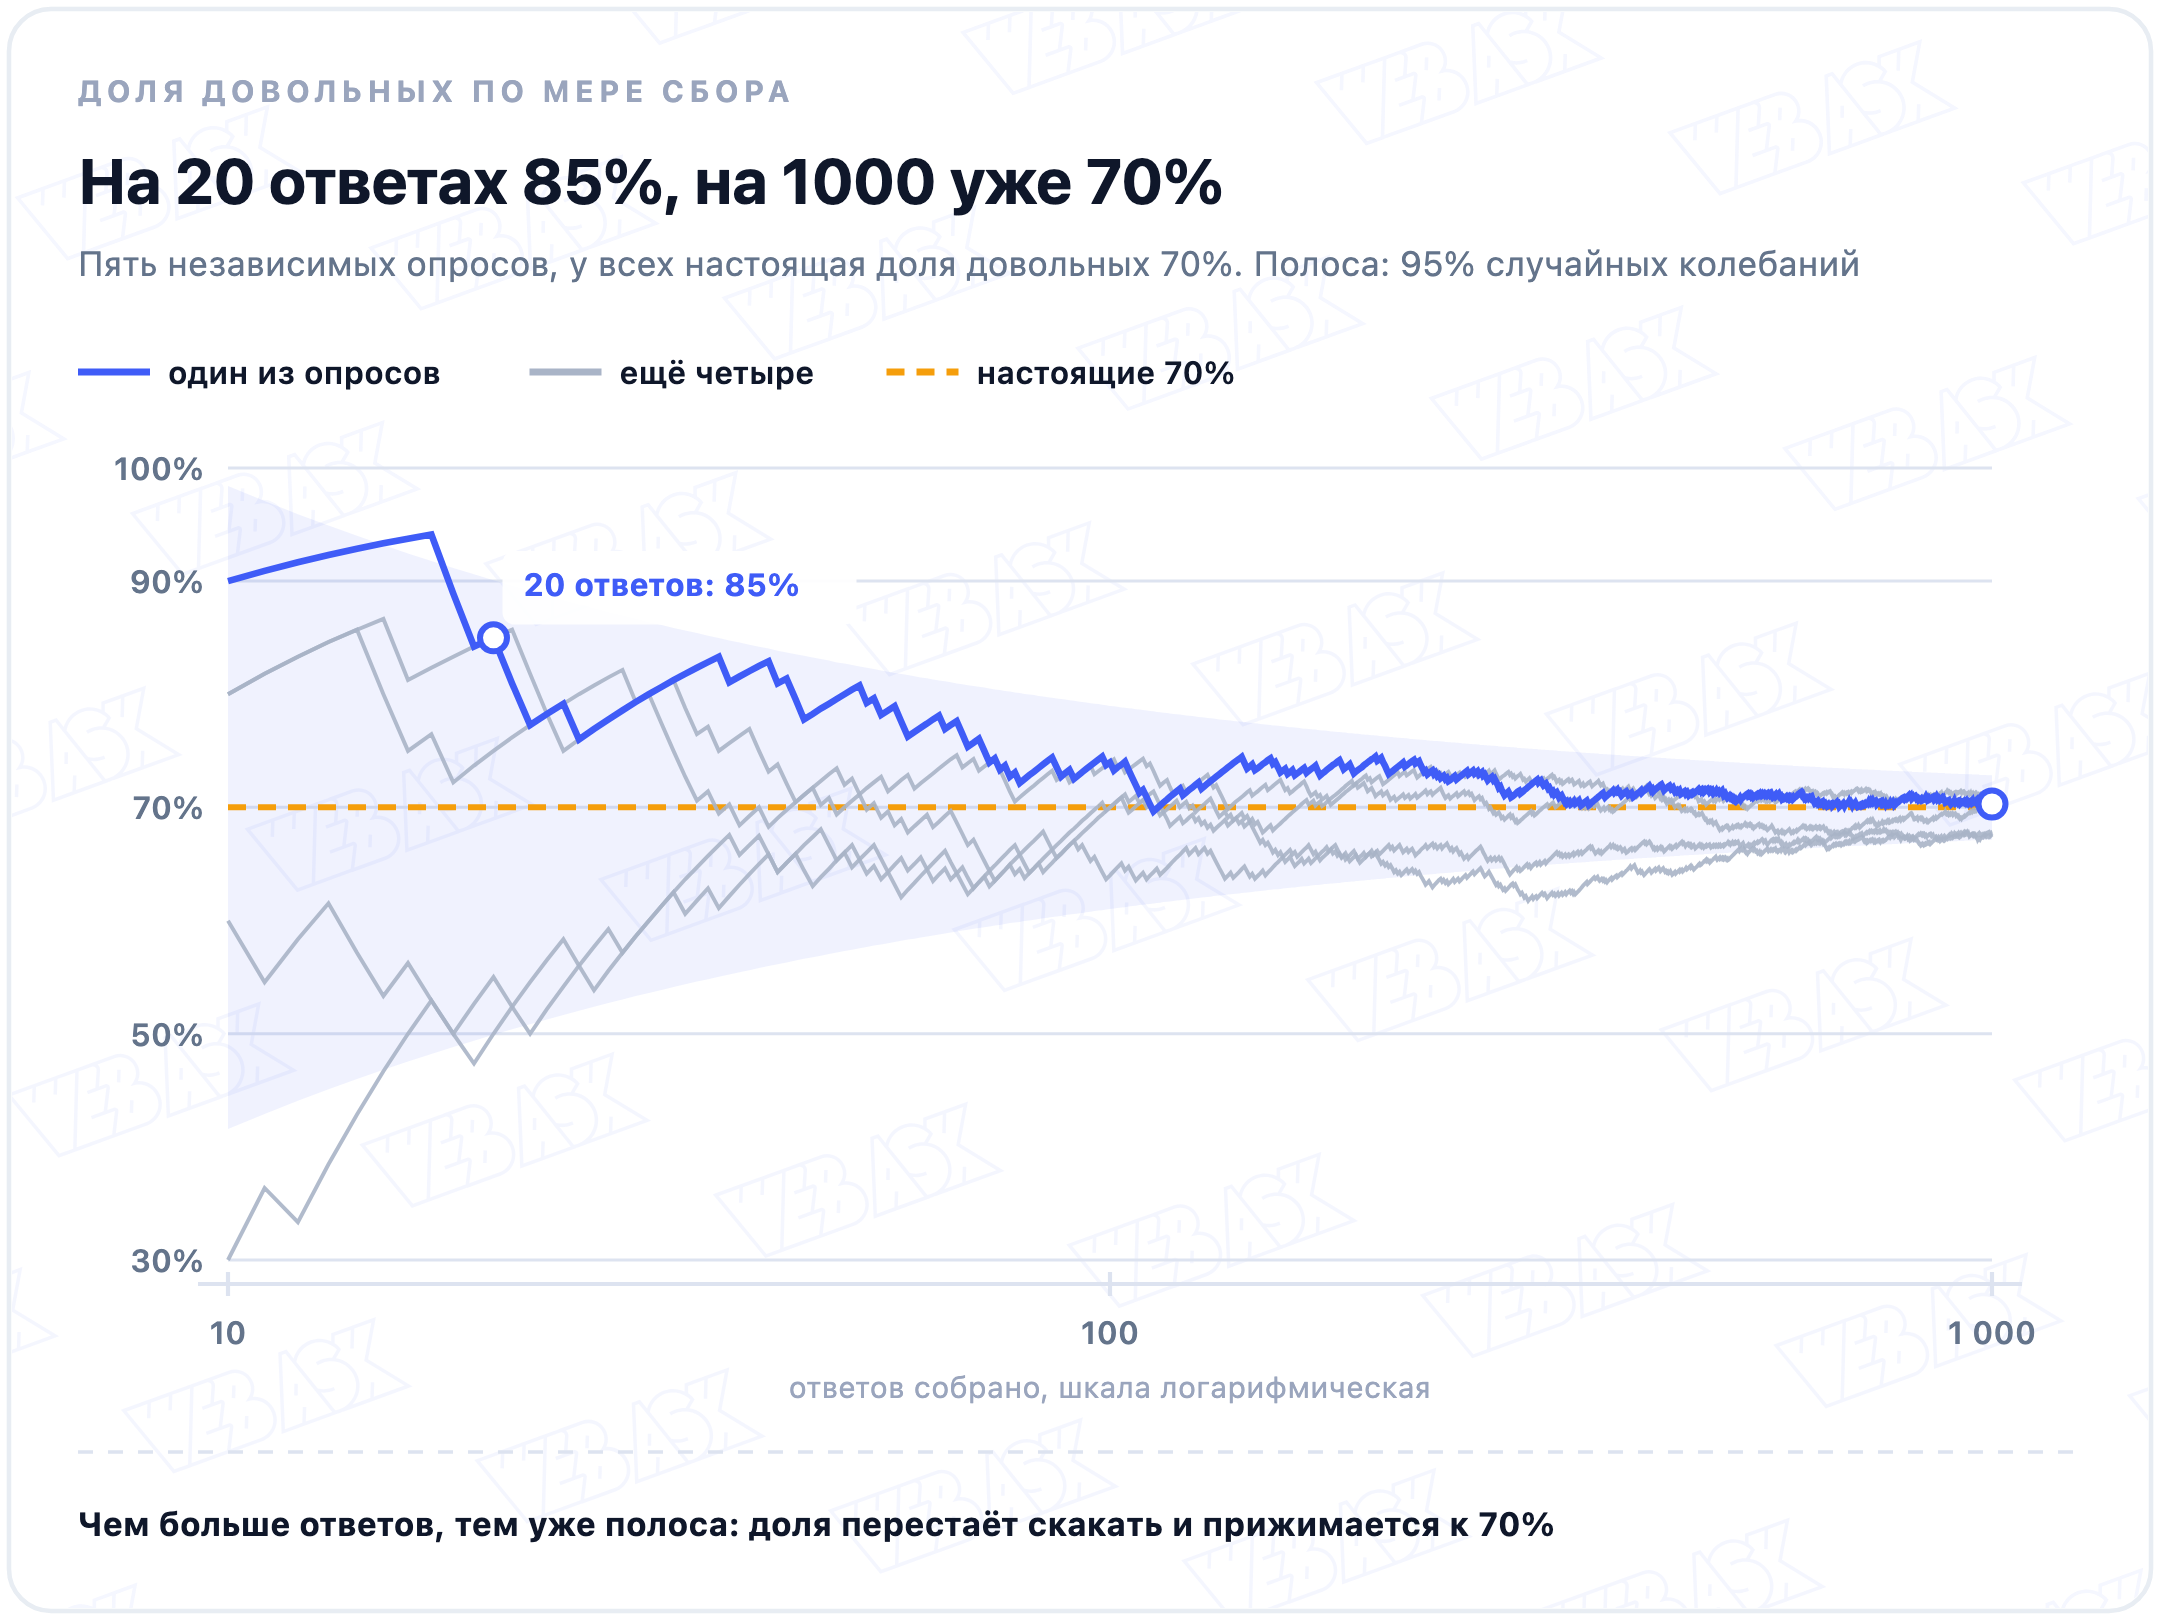
Выделенный опрос на 20 ответах показал 85%, на сотне 74%, на 400 ответах 71,5%, на тысяче 70,3%. Полоса, в которую попадают 95% случайных колебаний, на 20 ответах шириной ±20 процентных пунктов, на сотне ±9, на 400 ответах ±4,5, на тысяче ±2,8.
Отсюда правило для тех, кто смотрит на результаты по мере сбора: первые 20–30 ответов показывают скорее случай, чем мнение клиентов. Выводы делают, когда полоса сузилась до погрешности, которая вас устраивает.
Как увидеть закон в Excel
- Смоделируйте ответы. В A2 формула
=ЕСЛИ(СЛЧИС()<0,7;1;0): единица значит «доволен» и выпадает с вероятностью 70%. Протяните её до A1001. - Посчитайте бегущую долю. В B2
=СРЗНАЧ($A$2:A2), протяните до B1001: в каждой строке доля довольных среди ответов до неё. - Постройте график. Линейный график по столбцу B покажет то же, что картинка выше: скачки в начале и спокойную линию у 0,7 к концу.
- Нажмите F9. Excel заново разыграет случайные числа: начало графика каждый раз другое, хвост почти тот же.
Почему после серии орлов решка не вероятнее
Известное неверное прочтение закона называют ошибкой игрока. Раз доля орлов должна выйти к половине, после пяти орлов подряд будто бы обязана выпасть решка. Монета прошлых бросков не помнит, и вероятность решки на шестом броске та же половина.
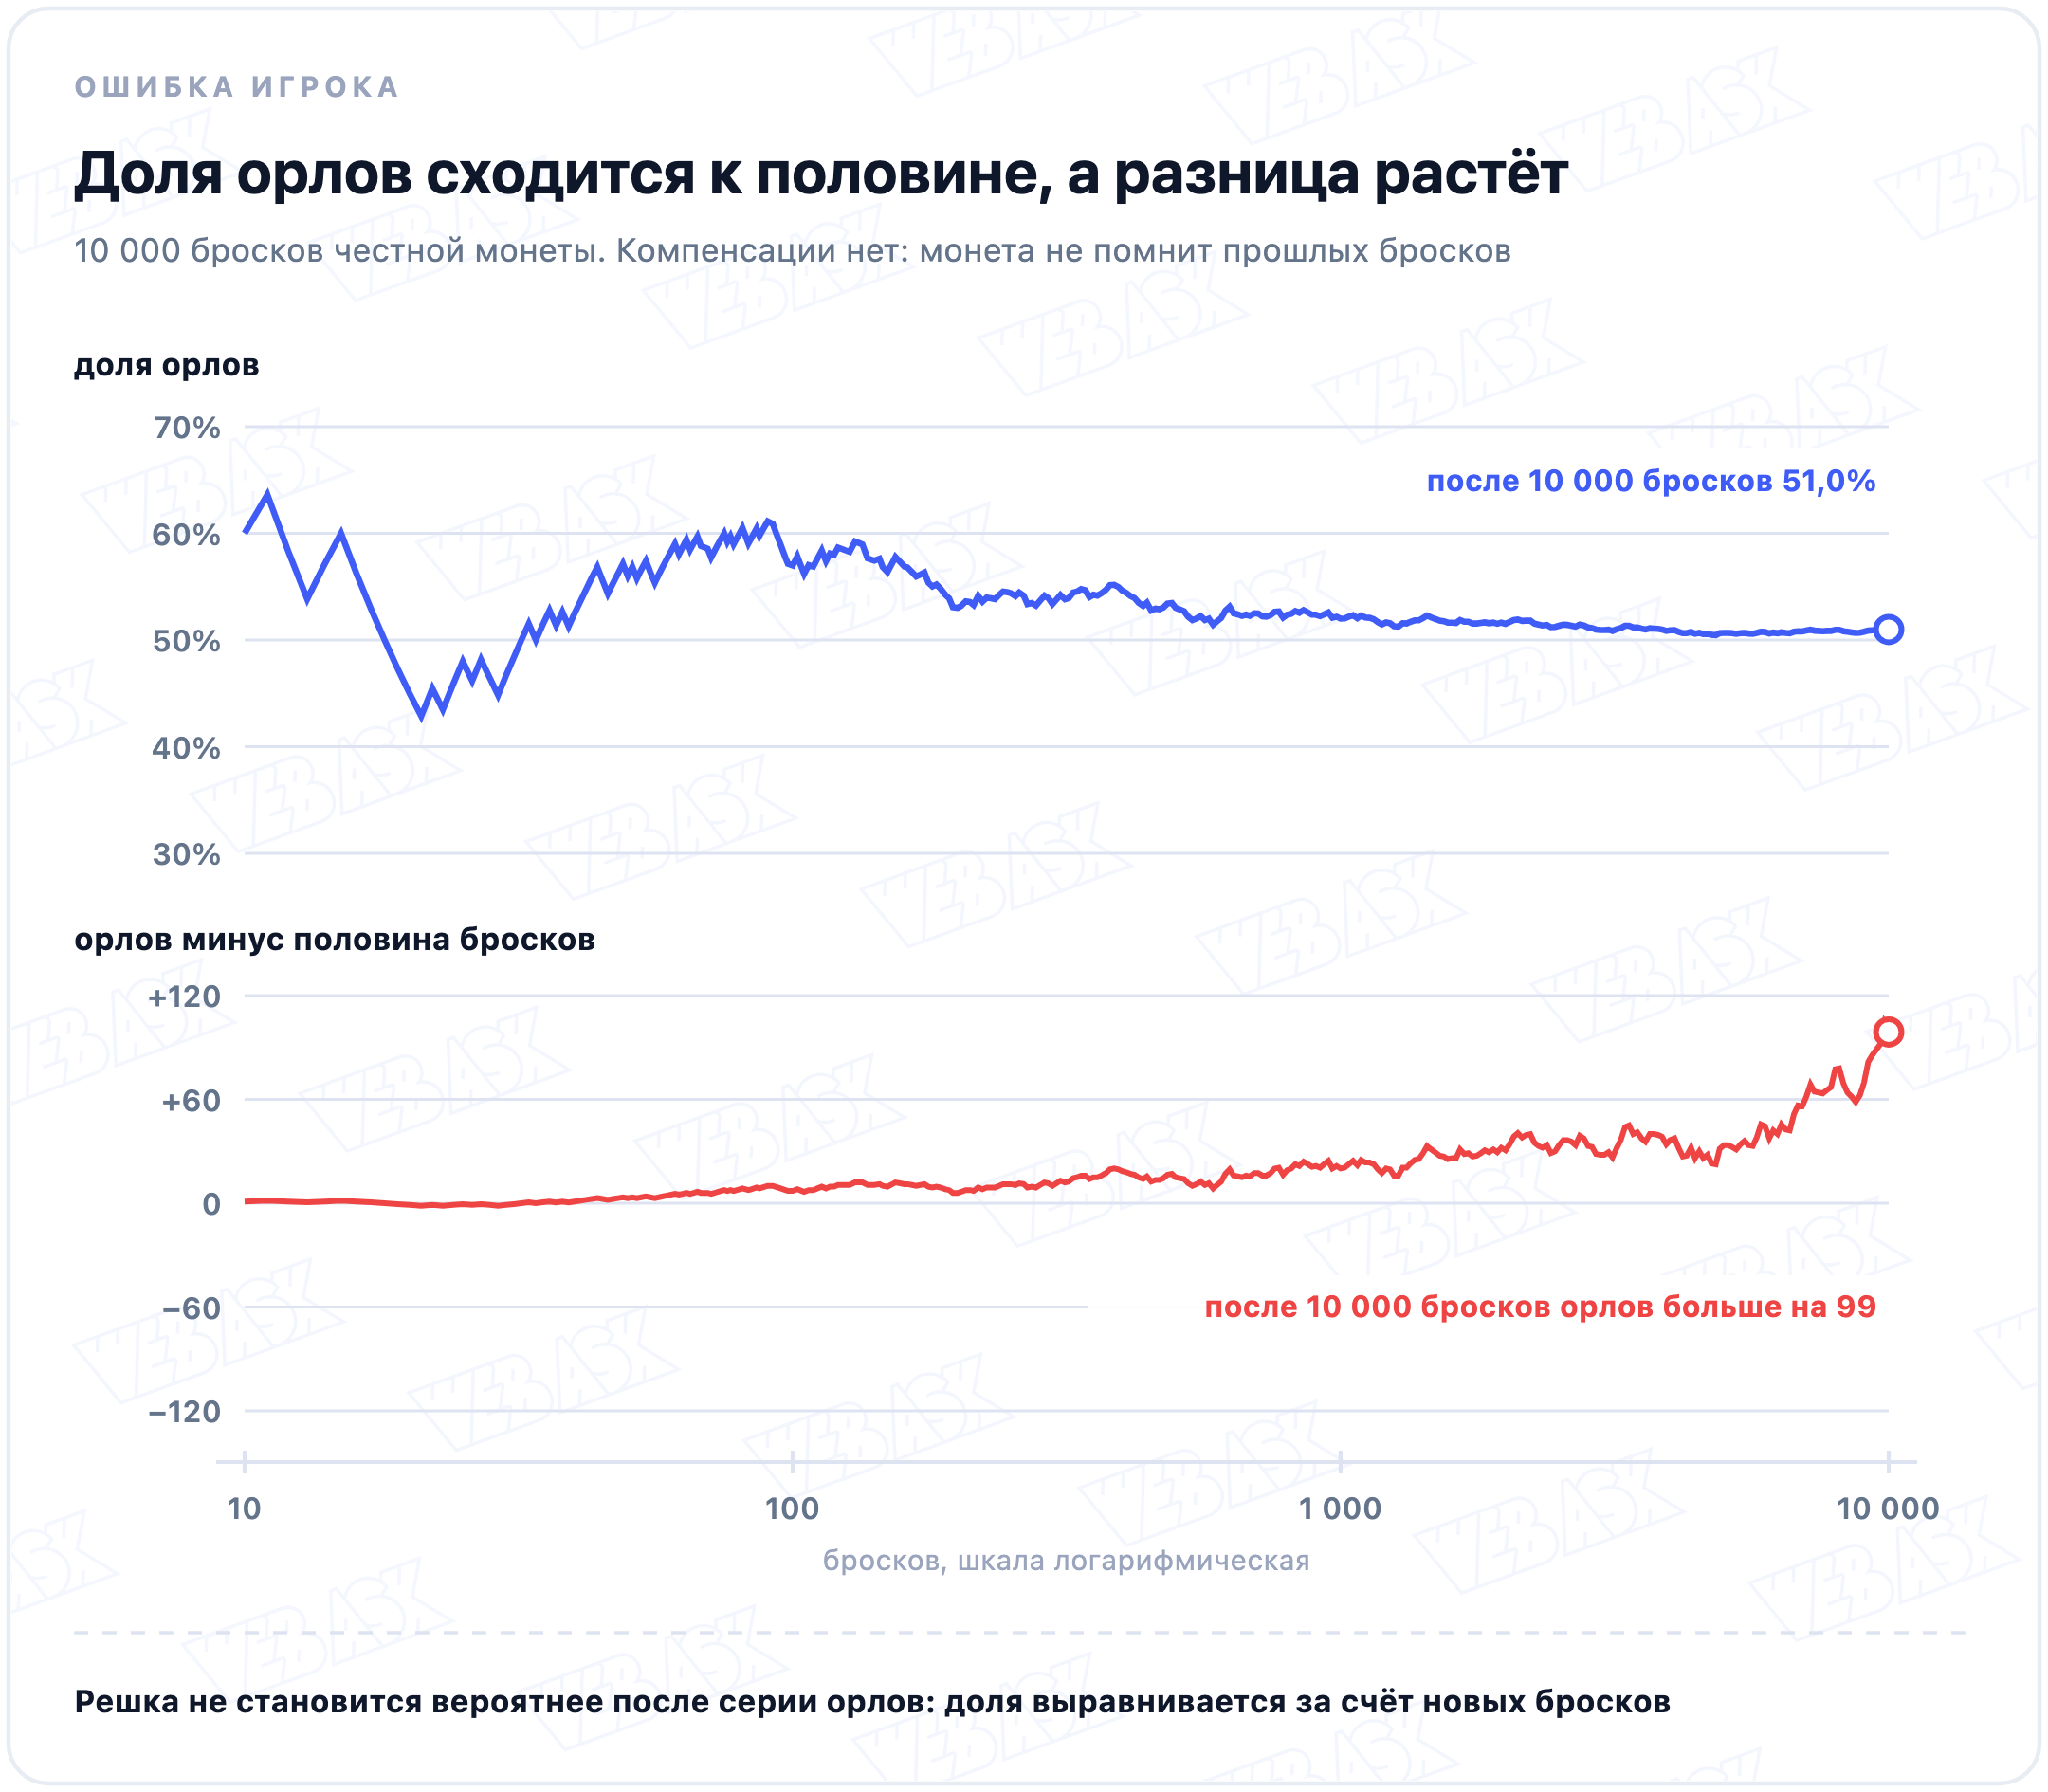
Доля выравнивается без всякой компенсации: старый перекос просто тонет в новых бросках. В нашей серии после 10 000 бросков выпало 5099 орлов, на 99 больше ровной половины, и доля при этом 51,0%. Разница в штуках выросла, а в процентах почти исчезла.
Закон в формулах: Бернулли и Чебышёв
У Бернулли закон сформулирован для частоты: если событие наступает с вероятностью p, то его доля m/n в n независимых опытах с ростом n сколь угодно близко подходит к p. Чебышёв доказал то же для среднего независимых величин с ограниченной дисперсией и дал оценку, насколько велик риск ошибиться:
P(|M − μ| ≥ ε) ≤ σ² / (n × ε²)
Здесь M среднее выборки, μ истинное среднее, σ² дисперсия одного наблюдения, ε допустимое отклонение. Для доли довольных p = 0,7 дисперсия одного ответа равна p × (1 − p) = 0,21. При 400 ответах вероятность ошибиться на 5 пунктов и больше по Чебышёву не выше 0,21 / (400 × 0,05²) = 21%. Оценка верна для любых данных, но грубая: по нормальному приближению та же вероятность около 3%. Такая же разница между гарантией для любых данных и точной долей для нормальных есть в правиле трёх сигм.
Сколько ответов нужно
Точность растёт с объёмом выборки, но медленно: погрешность доли пропорциональна 1/√n. Чтобы уменьшить её вдвое, ответов нужно вчетверо больше.
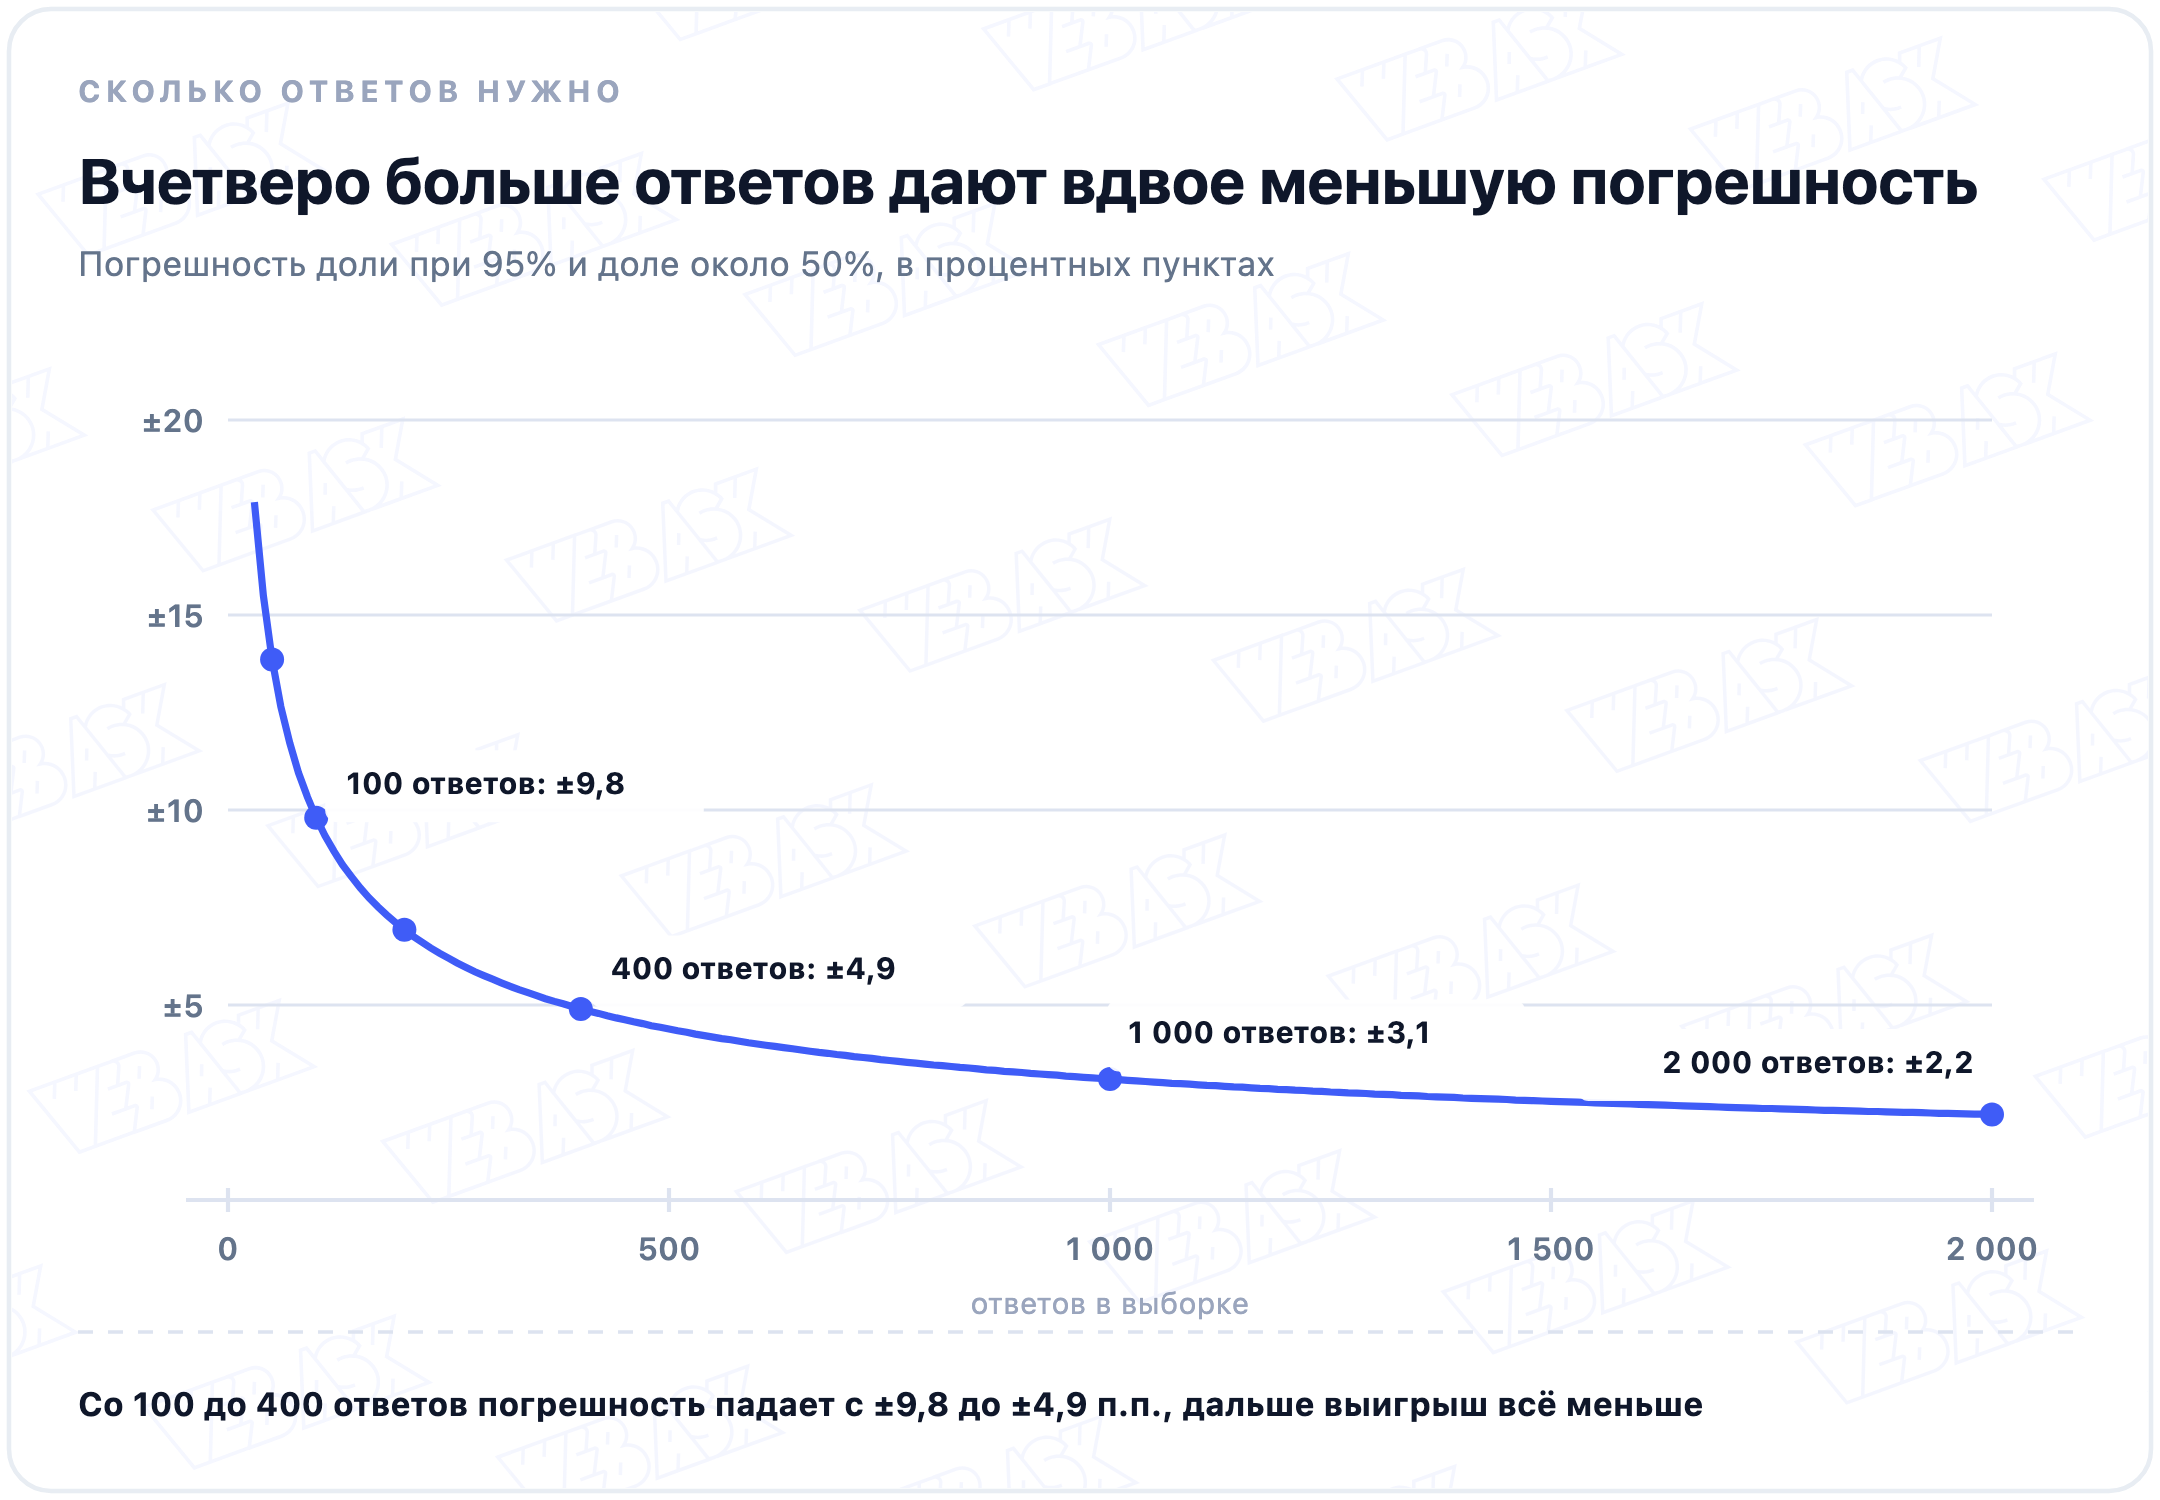
Со 100 до 400 ответов погрешность падает с ±9,8 до ±4,9 процентного пункта, а с 1000 до 2000 только с ±3,1 до ±2,2. Объём под нужную погрешность считает калькулятор размера выборки, а для среднего ту же зависимость описывает стандартная ошибка.
Чего закон не обещает
Закон обещает, что среднее выборки придёт к среднему той совокупности, из которой берут ответы. Если опрос видят и заполняют в основном самые активные клиенты, совокупностью становятся они, и тысяча анкет уверенно покажет именно их мнение.
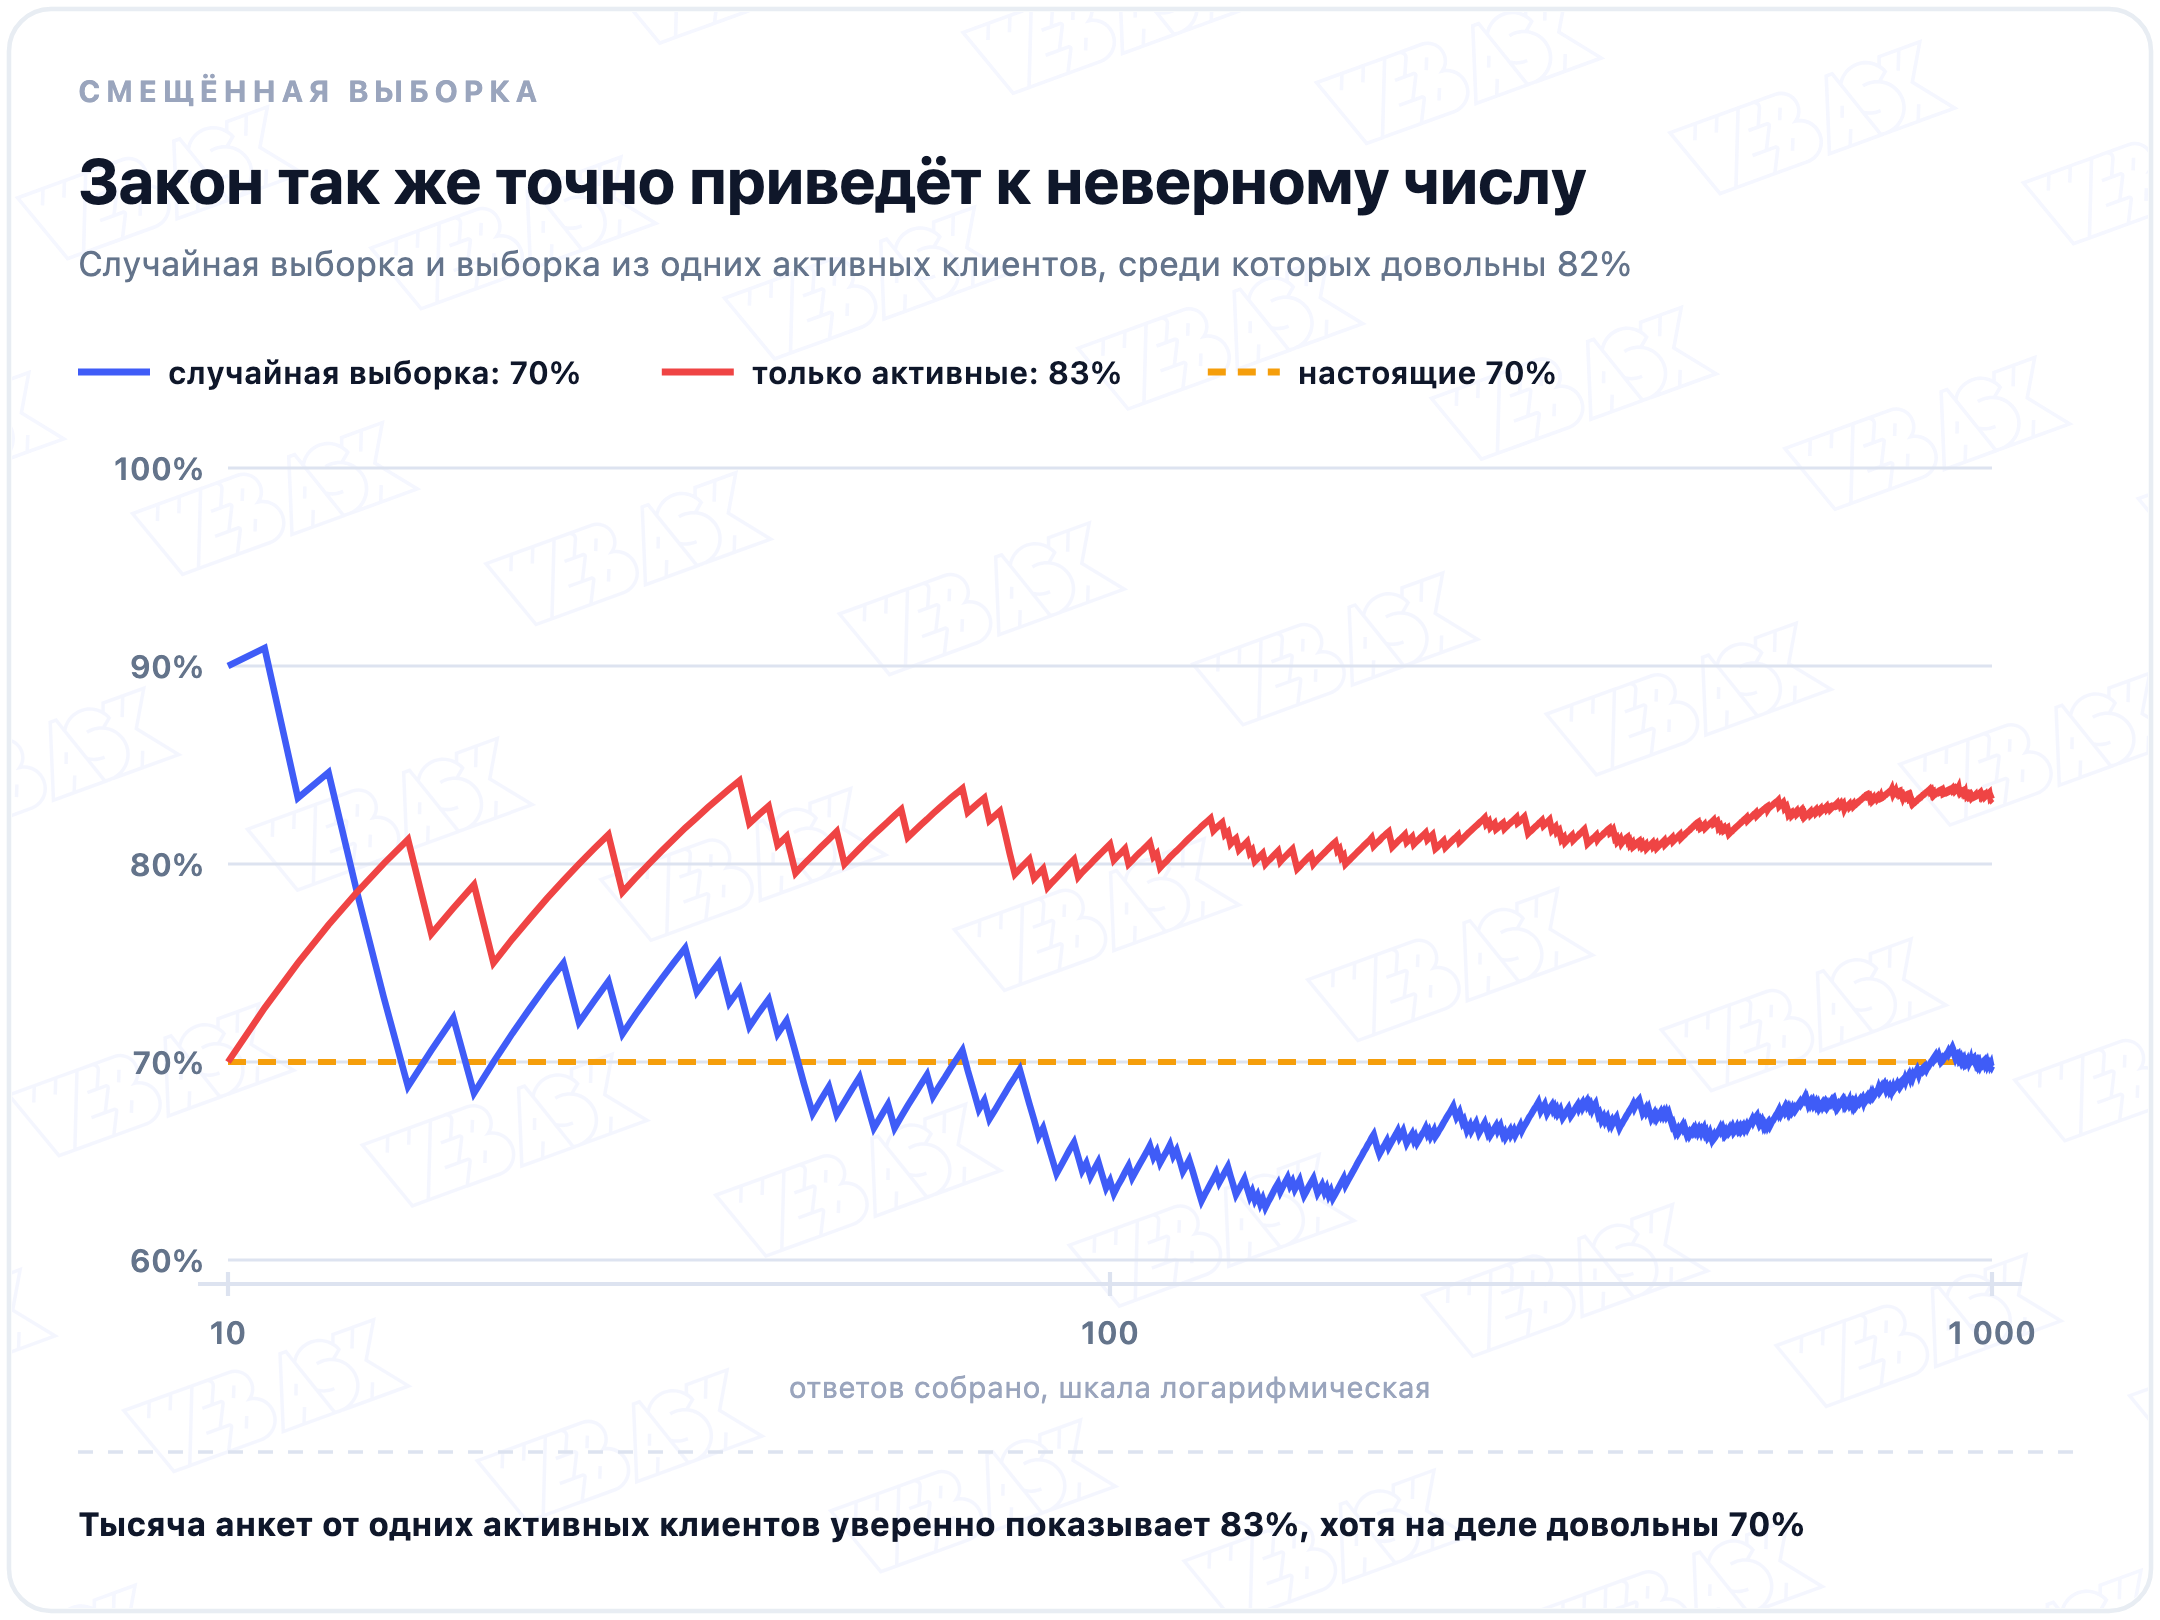
В модели среди активных клиентов довольны 82%, и их тысяча анкет показывает 83%, хотя по всем клиентам довольны 70%. Объём тут не поможет. Помогают случайный отбор, квоты и взвешивание: всё, что делает выборку похожей на всех клиентов.
Ещё закон требует независимых наблюдений. Если первыми отвечают одни клиенты, а последними другие, бегущая доля дрейфует уже не от случая, и ждать, пока она успокоится, бессмысленно: нужно смотреть, кто отвечал в начале, а кто в конце.
Частые ошибки
- Выводы по первым ответам. На 20 анкетах доля гуляет на ±20 пунктов. Сравнивать филиалы по первым десяткам ответов значит сравнивать случай.
- Ожидание компенсации. После серии плохих оценок хорошие не обязаны пойти. Выравнивается только доля, и только за счёт новых ответов.
- Надежда, что объём лечит всё. Тысяча анкет от смещённой выборки покажет неверную цифру так же уверенно, как случайная выборка покажет верную.
- Путаница с ЦПТ. Ширину и форму разброса средних закон не описывает, это работа центральной предельной теоремы.
Как это сделано в WebAsk
Отчёт по опросу можно открывать в любой момент сбора и смотреть, как доля успокаивается, а сводка показывает, сколько ответов пришло по дням. Насколько точна доля на уже собранных ответах, покажет калькулятор погрешности. Чтобы в выборку не попали одни активные клиенты, заранее задают квоты, их рассчитывает планировщик квот. Если ответов пока мало, а решение нужно сейчас, честнее показать долю вместе с погрешностью, чем одну цифру.
Коротко
- С каждой сотней ответов доля в опросе гуляет всё меньше и прижимается к настоящей.
- На 20 ответах случайный разброс доли около ±20 пунктов, на 400 около ±4,5.
- Компенсации нет: после серии орлов решка не вероятнее, доля выравнивается за счёт новых бросков.
- Погрешность падает как 1/√n: вчетверо больше ответов дают вдвое меньшую погрешность.
- Смещённую выборку закон не исправляет, он только точнее показывает её мнение.
Вопросы и ответы
Что такое закон больших чисел простыми словами?
Чем больше раз повторить случайный опыт, тем ближе средний результат к ожидаемому. На 10 бросках монета легко даст 70% орлов, на 10 000 почти ровно половину.
Кто открыл закон больших чисел?
Первым его доказал Якоб Бернулли для частоты событий, книга вышла в 1713 году. Название дал Симеон Пуассон в 1837 году, а общую форму для средних в 1867 году доказал Пафнутий Чебышёв.
Чем закон больших чисел отличается от центральной предельной теоремы?
Закон больших чисел говорит, к чему приходит среднее при росте выборки. ЦПТ описывает, как распределены отклонения среднего: по нормальному закону с разбросом σ/√n. Первый отвечает на вопрос «куда», вторая на вопрос «насколько и в какой форме».
Что такое ошибка игрока?
Ожидание, что после серии одинаковых исходов противоположный станет вероятнее. У независимых событий так не бывает: монета не помнит прошлых бросков, а доля выравнивается только потому, что новые броски разбавляют старый перекос.
Сколько ответов нужно, чтобы закон больших чисел сработал?
Точного порога нет, есть погрешность. Для доли около 50% при 95% она составляет ±9,8 процентного пункта на 100 ответах, ±4,9 на 400 и ±3,1 на 1000. Нужный объём считают от погрешности, которая устраивает.
Работает ли закон больших чисел для любой выборки?
Он гарантирует приближение к среднему той совокупности, из которой берутся ответы. Если отвечают в основном активные клиенты, тысяча анкет точно покажет мнение активных. Чтобы выйти на всех клиентов, нужны случайный отбор, квоты или взвешивание.
Где применяется закон больших чисел?
В страховании тарифы считают по доле страховых случаев среди тысяч договоров. В опросах по сотням ответов оценивают мнение всех клиентов, а в контроле качества по выборке изделий судят о доле брака во всей партии. Везде одна логика: про отдельный случай закон ничего не говорит, про долю среди многих говорит уверенно.
Опубликовано 16 октября 2026