
 Анкетолог
 Typeform
 Тестограф
 Яндекс Формы
 Google Forms
 SurveyMonkey
 Microsoft Forms
 Online Test Pad
 Oprosso
 Simpoll


 Алексей Логинов
Десять человек из продуктовой команды расставили по местам восемь функций, которые можно сделать в следующем квартале. Прежде чем строить план по средним местам, стоит проверить, сошлись ли они вообще или каждый тянет в свою сторону.
Что такое коэффициент конкордации Кендалла
Коэффициент конкордации Кендалла (Kendall’s W) — это мера того, насколько согласованно несколько экспертов ранжировали один и тот же набор объектов.
Коэффициент конкордации считают по суммам мест каждого объекта: W равен 1, когда все эксперты расставили объекты одинаково, и близок к 0, когда общего порядка нет.
Предложили его Морис Кендалл и Бернард Бабингтон Смит в статье 1939 года о задаче m ранжирований. Таблица та же, что у критерия Фридмана, описанного двумя годами раньше, и одно число пересчитывается в другое. Но W читать удобнее: он лежит между 0 и 1 при любом числе экспертов и объектов.
Считают W там, где несколько человек расставляют по местам одно и то же:
- Экспертная оценка. Специалисты ранжируют риски, критерии выбора поставщика, компетенции для модели руководителя.
- Метод Дельфи. W считают после каждого раунда опроса методом Дельфи и смотрят, сходятся ли мнения.
- Приоритеты продукта. Команда или клиенты расставляют функции по важности, как в примере ниже.
Для двух экспертов есть корреляция Спирмена. Если эксперты относят ответы к категориям, согласие меряют каппой Коэна, о ней карточка про межэкспертную надёжность.
Как считается W
Как провести опрос методом ДельфиНужна таблица, где строки это эксперты, а столбцы объекты. В каждой строке стоят места от 1 до n, без пропусков.
- Места каждого объекта складывают по всем экспертам.
- Находят среднюю сумму: m(n + 1) / 2, где m число экспертов, n число объектов. Для 10 экспертов и 8 объектов это 45.
- Считают S, сумму квадратов отклонений каждой суммы от средней.
- Подставляют в формулу.
W = 12S / (m² × (n³ − n))
Если эксперты полностью согласны, суммы разбегаются до предела: у одного объекта 10, у следующего 20 и так далее до 80. Если порядок у каждого свой, все суммы жмутся к 45. W показывает, где между этими крайностями оказались данные.
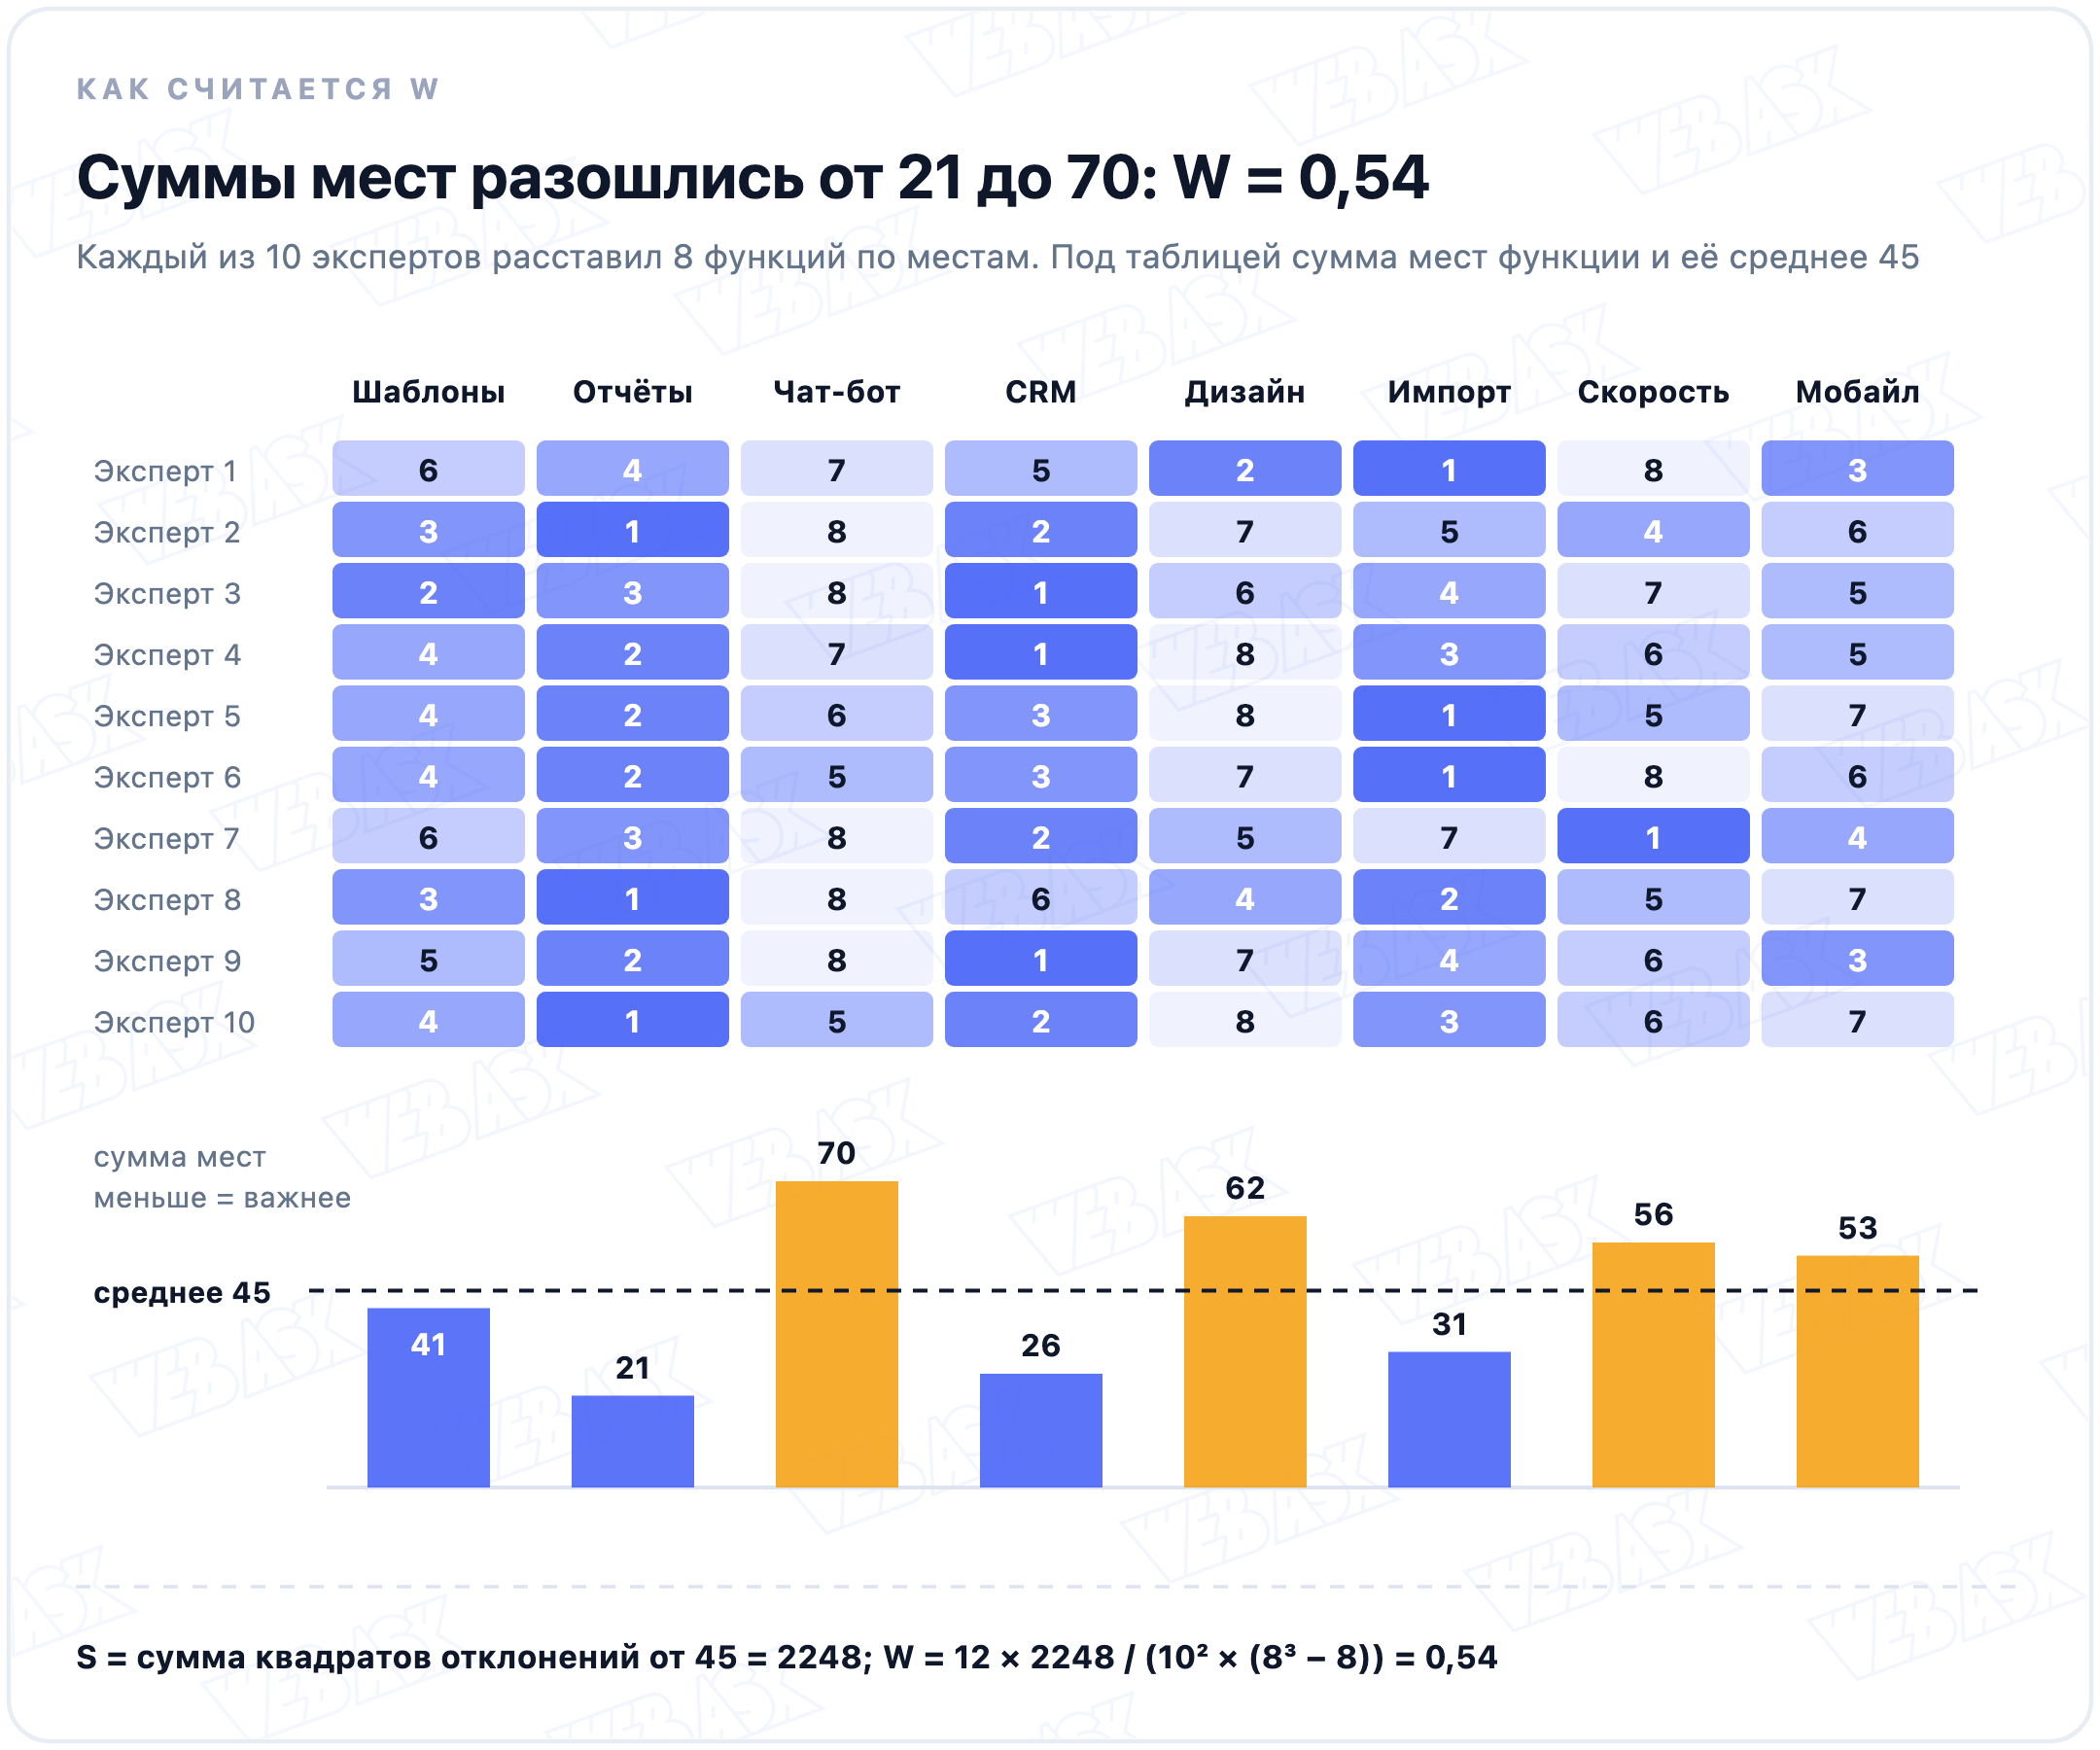
В примере суммы разошлись от 21 у отчётов до 70 у чат-бота, S = 2248, а W = 12 × 2248 / (100 × 504) = 0,54. Лидер ясен: отчёты девять экспертов из десяти поставили в первую тройку. С последним местом тоже почти договорились, чат-бот у семерых на седьмом или восьмом месте. А скорость одни ставили первой, другие последней, и её среднее место ничего не говорит о мнении команды.
W связан и с попарными корреляциями: средняя корреляция Спирмена между всеми парами экспертов равна (mW − 1) / (m − 1). В примере это 0,48, порядок у двух случайно выбранных экспертов связан умеренно.
Как проверить значимость
Значимость отвечает на вопрос, мог ли такой уровень согласия получиться случайно. W переводят в хи-квадрат с n − 1 степенями свободы:
χ² = m × (n − 1) × W
В примере χ² = 10 × 7 × 0,535 = 37,5 при 7 степенях свободы, p-value меньше 0,001. Приближение грубое на маленьких таблицах: в документации R прямо сказано, что этот тест годится только для больших выборок. Мы сравнили его с моделью на случайных ранжированиях: для 8 объектов и трёх экспертов приближение требует W от 0,67, модель от 0,61. При пяти экспертах уже 0,40 против 0,38, а с десяти расхождение меньше 0,01.
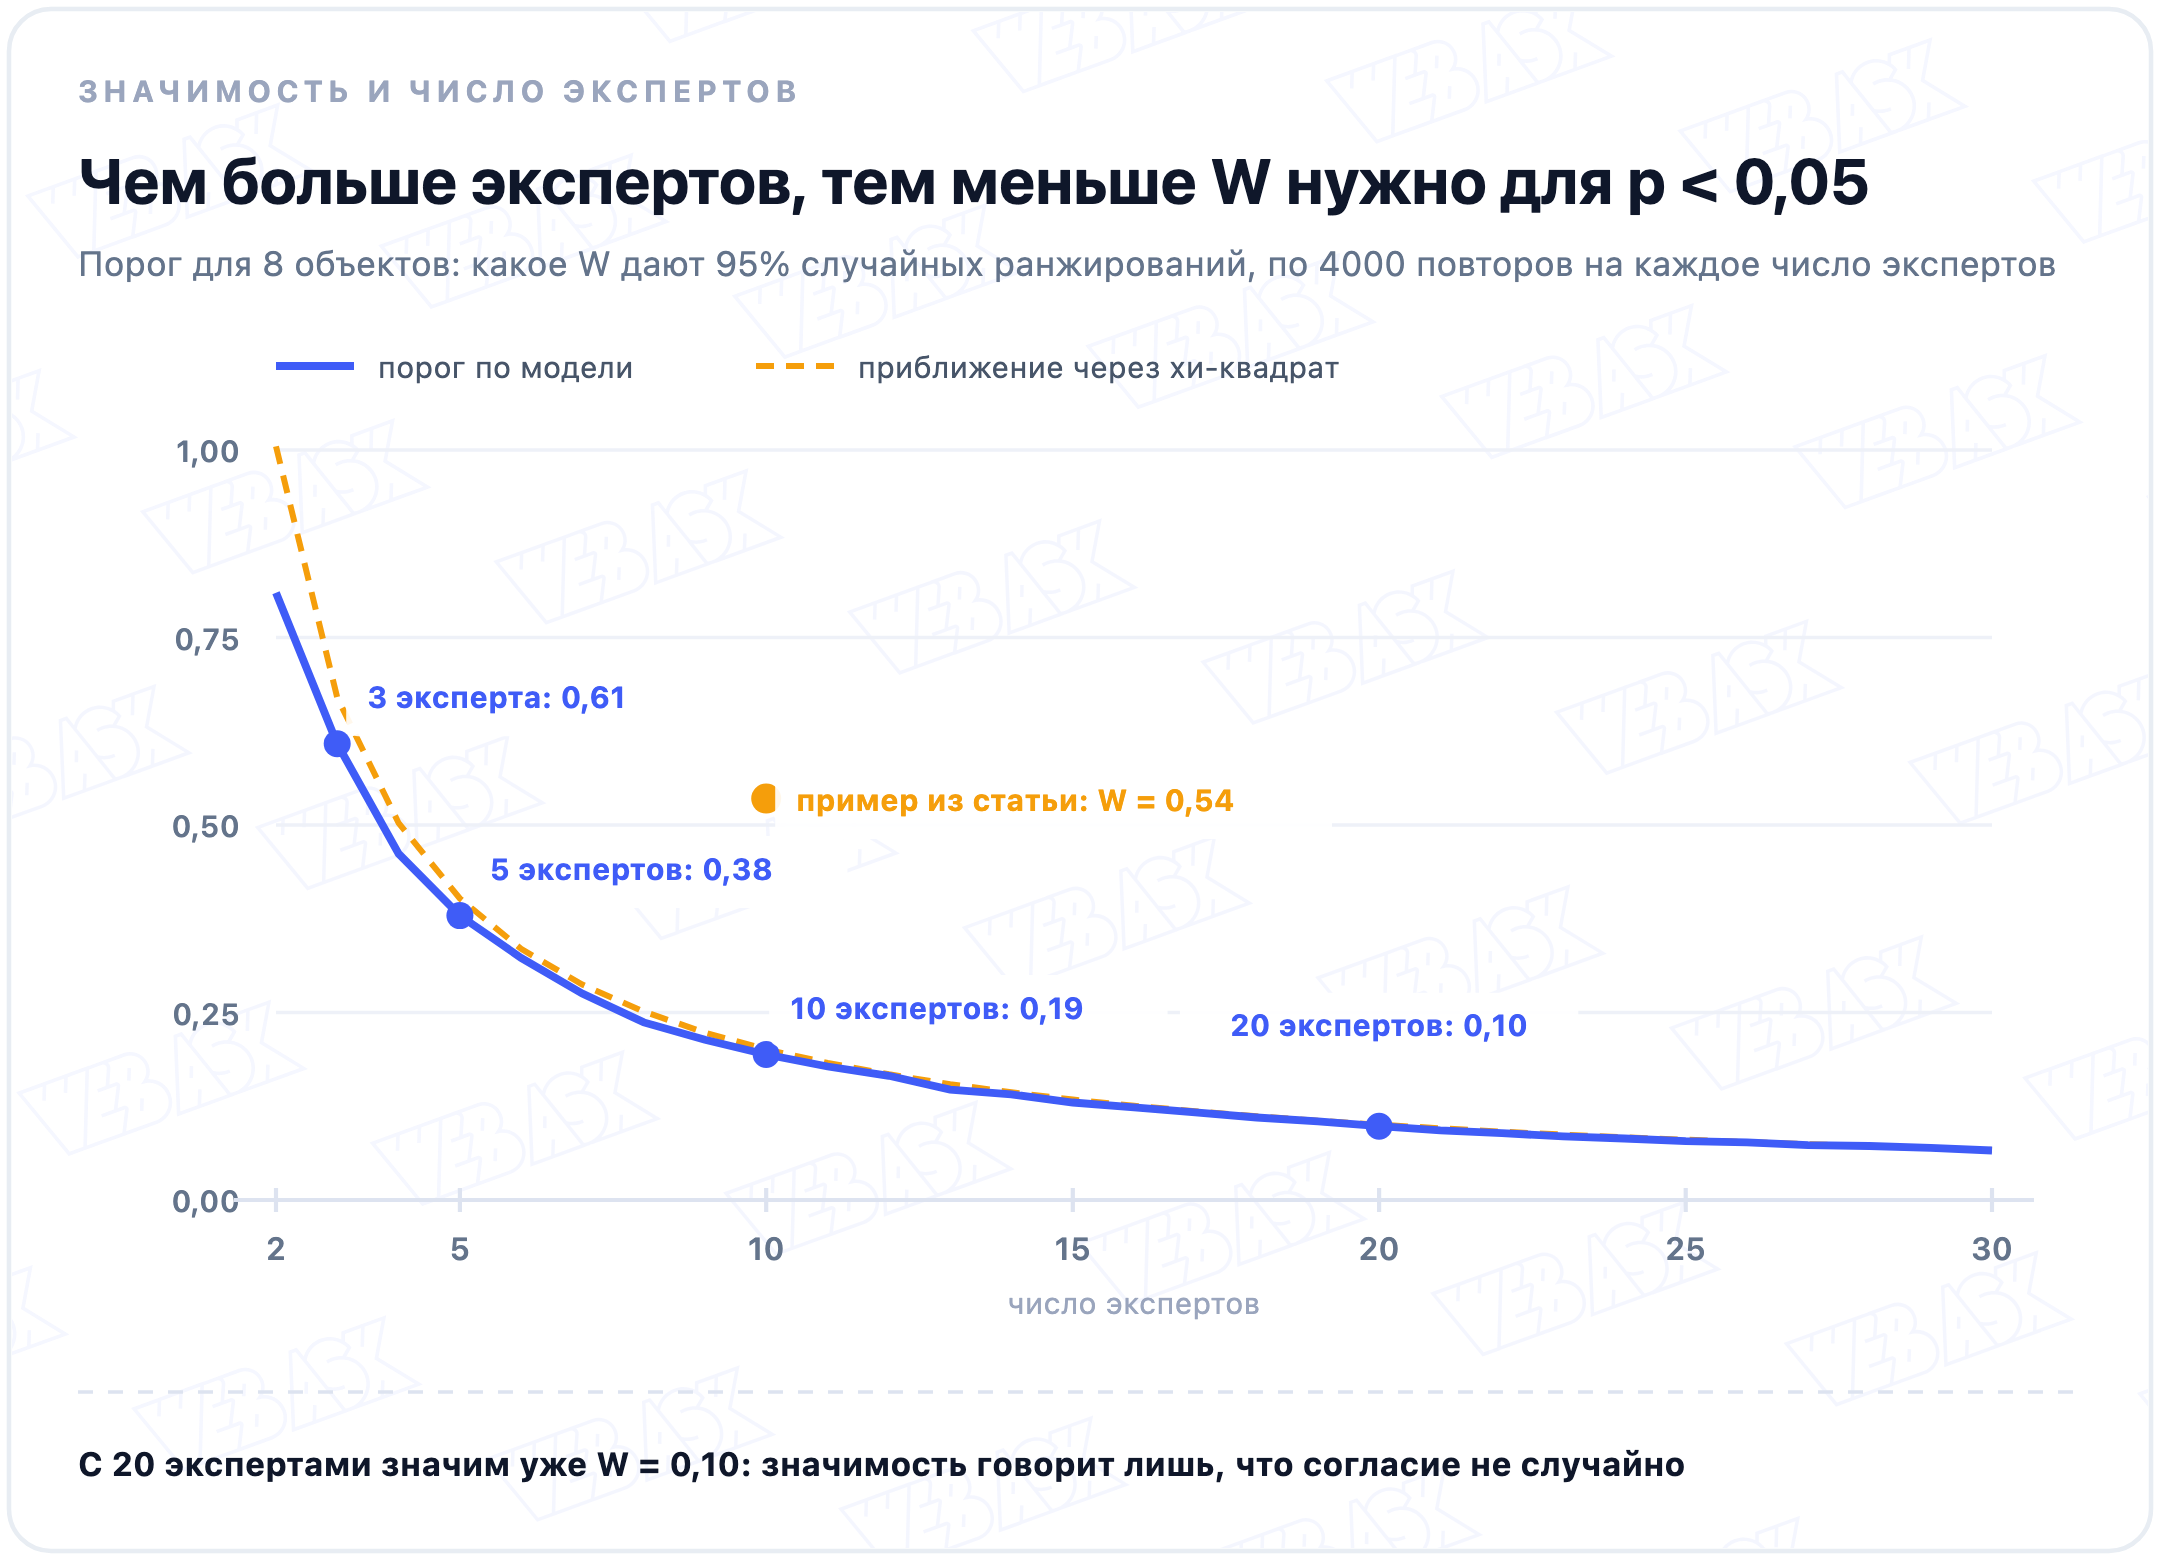
Главная ловушка на этом графике. При пяти экспертах значимым выходит W от 0,38, при десяти от 0,19, а при двадцати хватает 0,10. Значит, большая панель экспертов почти всегда даёт p меньше 0,05, даже когда согласие слабое. p говорит только, что порядок не случайный. Насколько он общий, показывает сам W.
Общепринятой шкалы для W нет. В исследованиях методом Дельфи часто опираются на ориентиры Роя Шмидта из статьи 1997 года: около 0,1 очень слабое согласие, 0,3 слабое, 0,5 умеренное, 0,7 сильное, 0,9 необычно сильное. Наш пример с W = 0,54 попадает в умеренное.
Связанные ранги
Иногда эксперт ставит два объекта на одно место. Тогда оба получают средний ранг: если поделили третье и четвёртое места, у каждого 3,5. Такие связки уменьшают разброс сумм, поэтому знаменатель правят: из m² × (n³ − n) вычитают m × ΣT, где для каждого эксперта T = Σ(t³ − t), а t число объектов в группе с одинаковым местом.
В вопросе «Ранжирование» связок не бывает, каждый вариант получает своё место. Они появляются, когда места выводят из оценок, например из баллов от 1 до 10: два одинаковых балла у одного эксперта дают связку.
Чего W не показывает
Ноль у W выходит в двух совсем разных ситуациях: когда у каждого эксперта свой порядок и когда эксперты разделились на лагеря с противоположными мнениями. В модели ниже пять экспертов ставят функции в одном порядке, пять в обратном. Внутри каждой пятёрки W = 0,89, а у всех десяти 0,03.
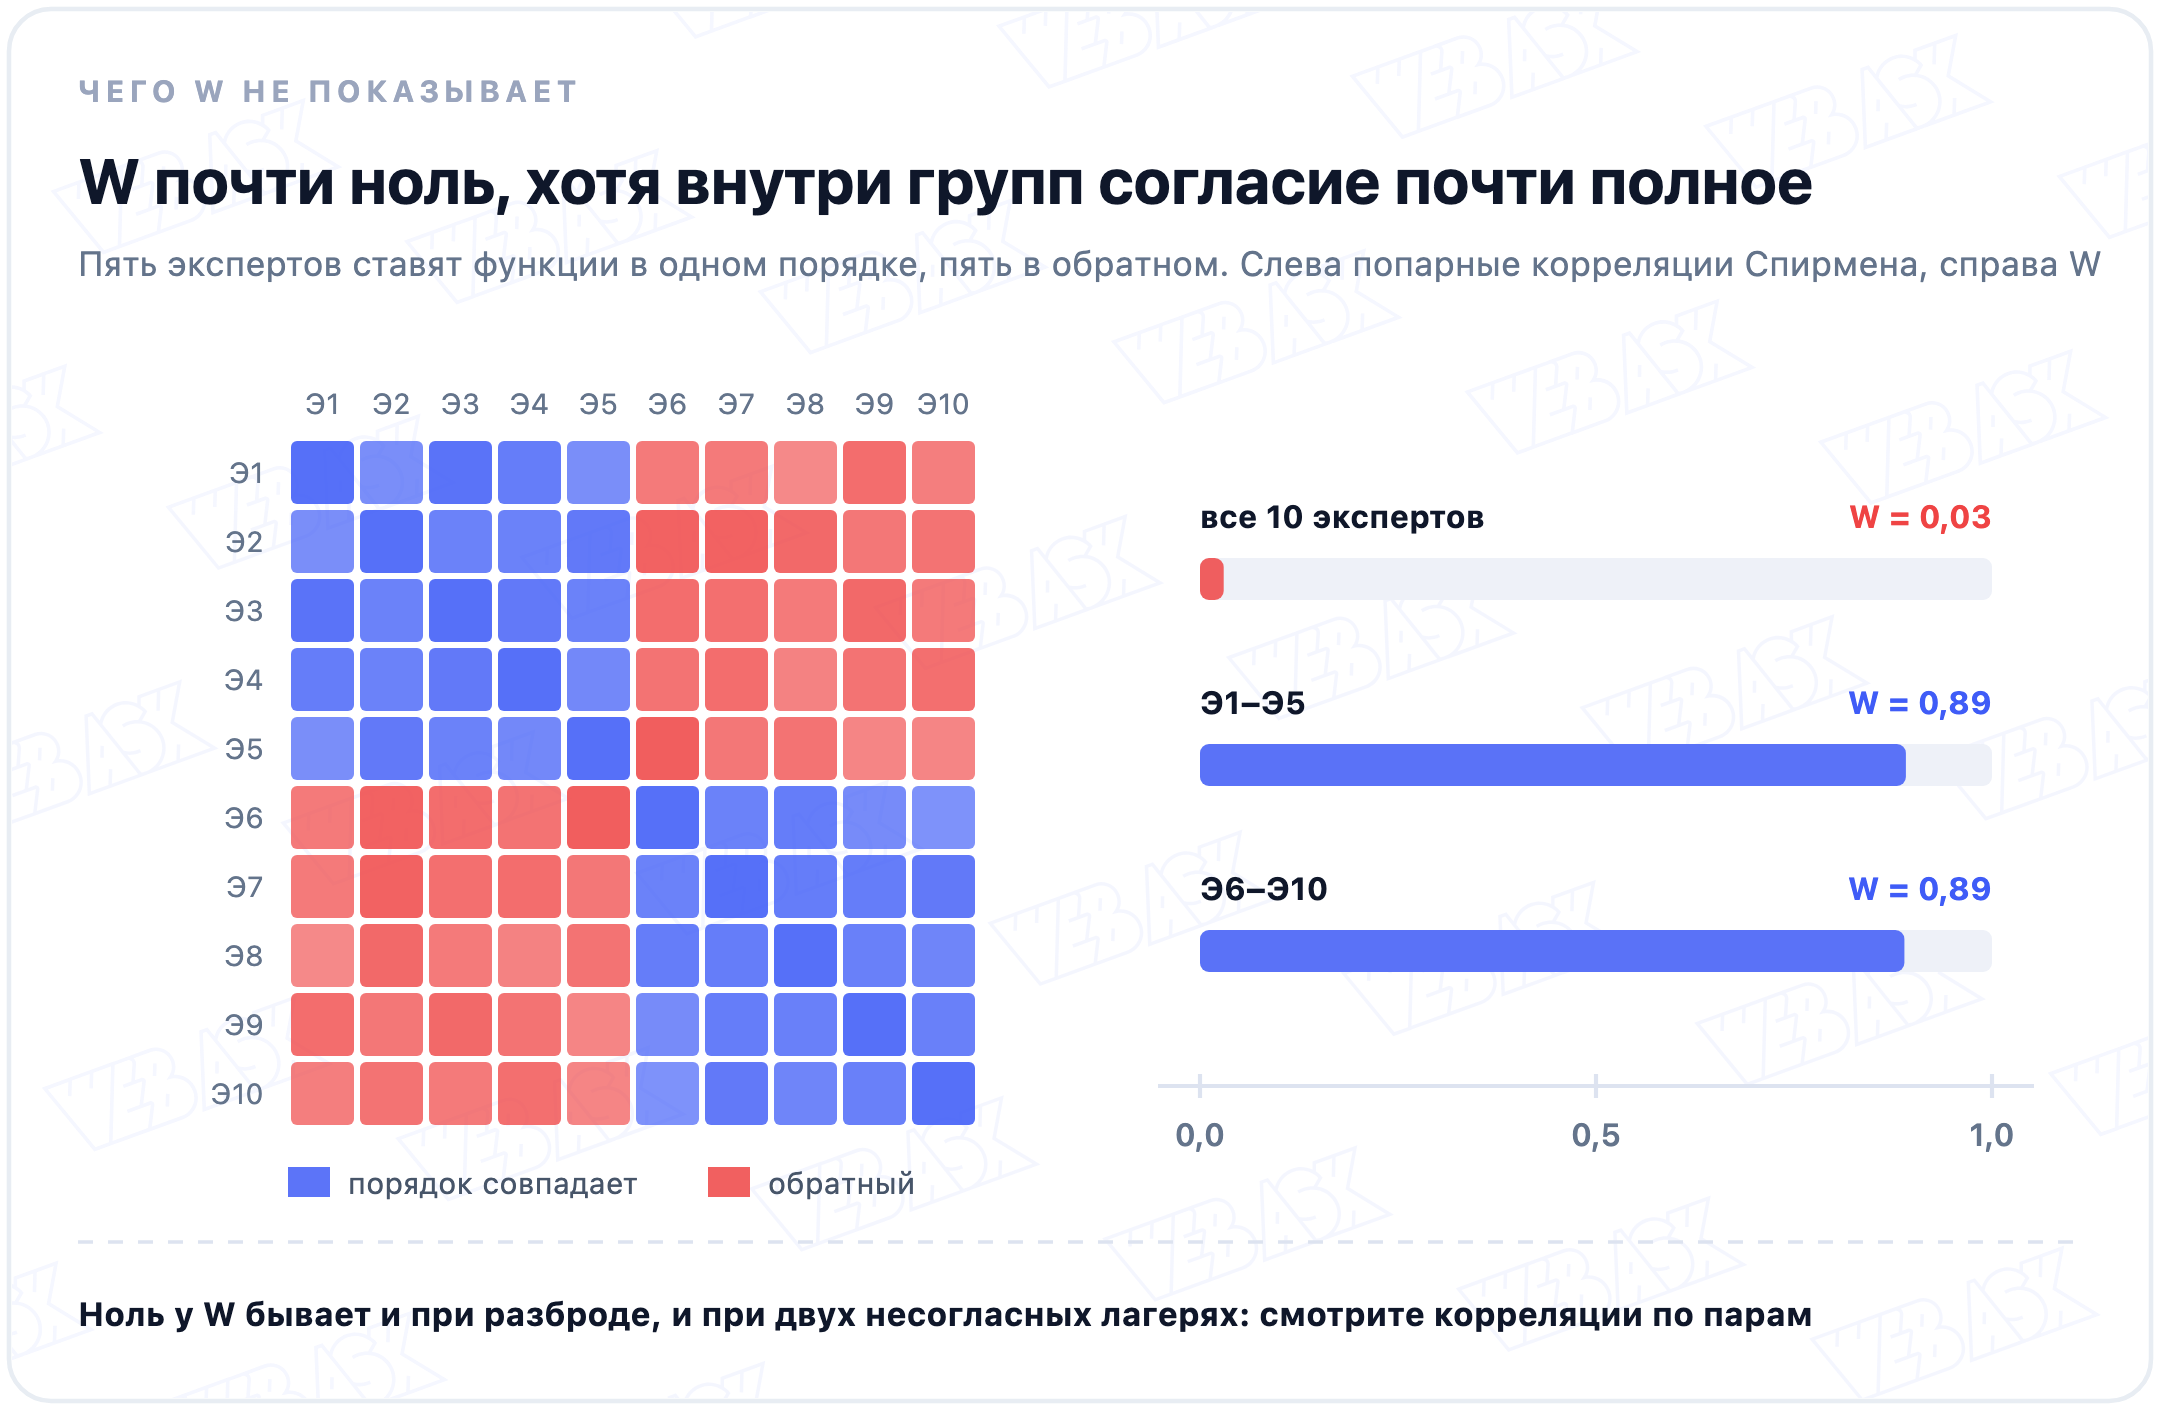
Раскол как раз виден в таблице попарных корреляций Спирмена: внутри групп они от 0,76 до 0,98, между группами от −0,98 до −0,69. Поэтому при низком W стоит посмотреть на эту таблицу, прежде чем писать в отчёт «мнения разошлись».
- По каким объектам согласие. W один на весь список. У нас бесспорны лидер и аутсайдер, а скорость и шаблоны спорные. Это видно по разбросу мест каждого объекта.
- Правы ли эксперты. Десять человек могут дружно ошибаться, особенно если обсудили ответы до ранжирования. W меряет согласие, а точность прогноза проверяют потом по фактам.
- Насколько важна разница между местами. Ранги не говорят, сильно ли первое место оторвалось от второго. Если нужны расстояния между объектами, подойдёт MaxDiff.
Частые ошибки
- W считают по баллам. Оценки от 1 до 10 сначала переводят в места внутри каждого эксперта, одинаковым баллам дают средний ранг. Если важны сами баллы и расстояния между ними, нужна внутриклассовая корреляция.
- W для пары экспертов. Для двоих он просто пересчёт корреляции Спирмена: W = (ρ + 1) / 2. Нагляднее сразу дать ρ.
- Тау Кендалла вместо W. Тау сравнивает два ранжирования по парам объектов, а W сводит согласие многих экспертов в одно число. Фамилия в названии одна, задачи разные.
- Эксперты обсудили места заранее. Тогда W меряет, как группа подстроилась под самого громкого. В методе Дельфи эксперты отвечают анонимно и видят только сводку прошлого раунда.
Как посчитать в Excel, R и Python
В Excel хватает четырёх формул. Пусть места 10 экспертов по 8 функциям стоят в B2:I11, по строке на эксперта.
- Суммы мест. В B12 формула
=СУММ(B2:B11), её протягивают до I12. - Сумма квадратов отклонений. В B13
=КВАДРОТКЛ(B12:I12), это S. - Сам W. В B14
=12*B13/(10^2*(8^3-8)). - Значимость. В B15 хи-квадрат
=10*7*B14, в B16 p-value=ХИ2.РАСП.ПХ(B15;7).
- R. Функция
kendall(ranks, correct = TRUE)из пакета irr, объекты по строкам, эксперты по столбцам. Она сразу даёт хи-квадрат и p. - Python. Функция
friedmanchisquare(*ranks.T)из scipy.stats возвращает хи-квадрат Фридмана, если в ranks эксперты стоят по строкам. W = χ² / (m × (n − 1)). - SPSS. Analyze → Nonparametric Tests → Legacy Dialogs → K Related Samples, отметка Kendall’s W. Объекты в столбцах, эксперты в строках.
Как это сделано в WebAsk
Как расставить приоритеты по RICEМеста удобно собирать вопросом «Ранжирование»: эксперт расставляет варианты по порядку, и каждый получает своё место. В настройках стоит включить случайный порядок вариантов, чтобы первые пункты списка не получали лишних голосов, и сделать вопрос обязательным. Через API ответ приходит списком вариантов в том порядке, который выбрал эксперт: позиция в списке и есть место. Ответы выгружаются в XLSX, CSV или SPSS.
Для метода Дельфи второй раунд собирают копией того же опроса, а в описание добавляют суммы мест первого раунда. После каждого раунда считают W. Если он растёт, мнения сходятся. Если стоит на месте, гонять тот же список по кругу бесполезно: спорные объекты лучше обсудить отдельно.
Коротко
- Чем дальше суммы мест от средней m(n + 1) / 2, тем выше W. Формула: W = 12S / (m² × (n³ − n)).
- Значимость проверяют через χ² = m × (n − 1) × W, но при 20 экспертах значимым выходит уже W = 0,10.
- Силу согласия читают по самому W: в Дельфи часто ориентируются на 0,5 как умеренное и 0,7 как сильное.
- W около нуля бывает и при разброде, и при двух противоположных лагерях: проверяйте попарные корреляции.
- В вопросе «Ранжирование» связанных мест нет, поправка нужна, когда места получены из баллов.
Вопросы и ответы
Что показывает коэффициент конкордации Кендалла?
Похожи ли места, которые разные эксперты дали одним вариантам. W = 1 при полном совпадении порядка, около 0, когда общего порядка нет. Правы ли эксперты и по каким вариантам они расходятся, W не говорит.
Как рассчитать коэффициент конкордации Кендалла?
Сложите места каждого объекта по всем экспертам, найдите сумму квадратов отклонений этих сумм от среднего m(n + 1) / 2 и подставьте её в формулу W = 12S / (m² × (n³ − n)), где m число экспертов, n число объектов. В Excel хватает функций СУММ и КВАДРОТКЛ.
Как проверить значимость коэффициента конкордации?
Через хи-квадрат: χ² = m × (n − 1) × W с n − 1 степенями свободы. При p меньше 0,05 согласие считают неслучайным. На маленьких таблицах приближение грубое, и p лучше считать перестановками или по точным таблицам.
Какое значение W считается хорошим?
Единого порога нет. В исследованиях методом Дельфи часто берут ориентиры Роя Шмидта: 0,5 умеренное согласие, 0,7 сильное, 0,9 необычно сильное. Значимость при этом проверяют отдельно: при большом числе экспертов значимым выходит и слабое согласие.
Чем коэффициент конкордации отличается от корреляции Кендалла?
Тау Кендалла сравнивает два ранжирования, например мнения двух экспертов. Коэффициент конкордации сводит в одно число согласие трёх экспертов и больше. Для пары экспертов удобнее корреляция Спирмена или тау.
Можно ли посчитать W для двух экспертов?
Можно, но смысла мало: для двух экспертов W = (ρ + 1) / 2, где ρ корреляция Спирмена между их местами. Читать ρ привычнее, у неё есть знак и понятный ноль.
Опубликовано 14 октября 2026