
 Анкетолог
 Typeform
 Тестограф
 Яндекс Формы
 Google Forms
 SurveyMonkey
 Microsoft Forms
 Online Test Pad
 Oprosso
 Simpoll


 Алексей Логинов
Пришедшие по письму и из соцсетей проходят анкету почти за одно и то же время: медианы 4,3 и 4,6 минуты, и критерий Манна–Уитни разницы не находит. Критерий Колмогорова–Смирнова на тех же ответах даёт p меньше 0,001, потому что около трети пришедших из соцсетей тратит на анкету меньше двух с половиной минут.
Что такое критерий Колмогорова–Смирнова
Критерий Колмогорова–Смирнова (Kolmogorov–Smirnov test) — это тест, который сравнивает распределение выборки с эталоном или с другой выборкой.
Критерий Колмогорова–Смирнова строит по данным кривые накопленных долей и берёт самое большое расстояние между ними, статистику D от 0 до 1.
Вариант для одной выборки описал Андрей Колмогоров в 1933 году, для двух Николай Смирнов в 1939-м. В 1948 году в журнале Annals of Mathematical Statistics вышла таблица Смирнова для оценки согласия эмпирических распределений.
- Одна выборка против эталона. Эталон задают заранее и полностью: вид распределения и все его параметры, например по результатам прошлых лет.
- Две выборки. Проверяют, взяты ли обе из одного распределения: ответы двух каналов или двух волн опроса.
Нулевая гипотеза в обоих случаях одна: различия нет. Если p-value меньше 0,05, её отвергают.
Как считается D
Значения сортируют по возрастанию и для каждого считают, какая доля ответов не больше него. Получается лесенка: она начинается с нуля, на каждом ответе поднимается на 1/n и доходит до единицы. У эталона та же доля берётся из его функции распределения, у второй выборки из её собственной лесенки.
D = max |Fn(x) − F(x)|, где Fn(x) доля ответов не больше x, а F(x) такая же доля у эталона или у второй выборки.
Учебный пример. Компания много лет проводит для новых сотрудников один и тот же тест по продукту, и результаты прошлых лет хорошо описывает нормальное распределение со средним 62 балла и SD 12. Новая группа из 30 человек набрала в среднем 68. Повезло с группой или это обычный разброс?
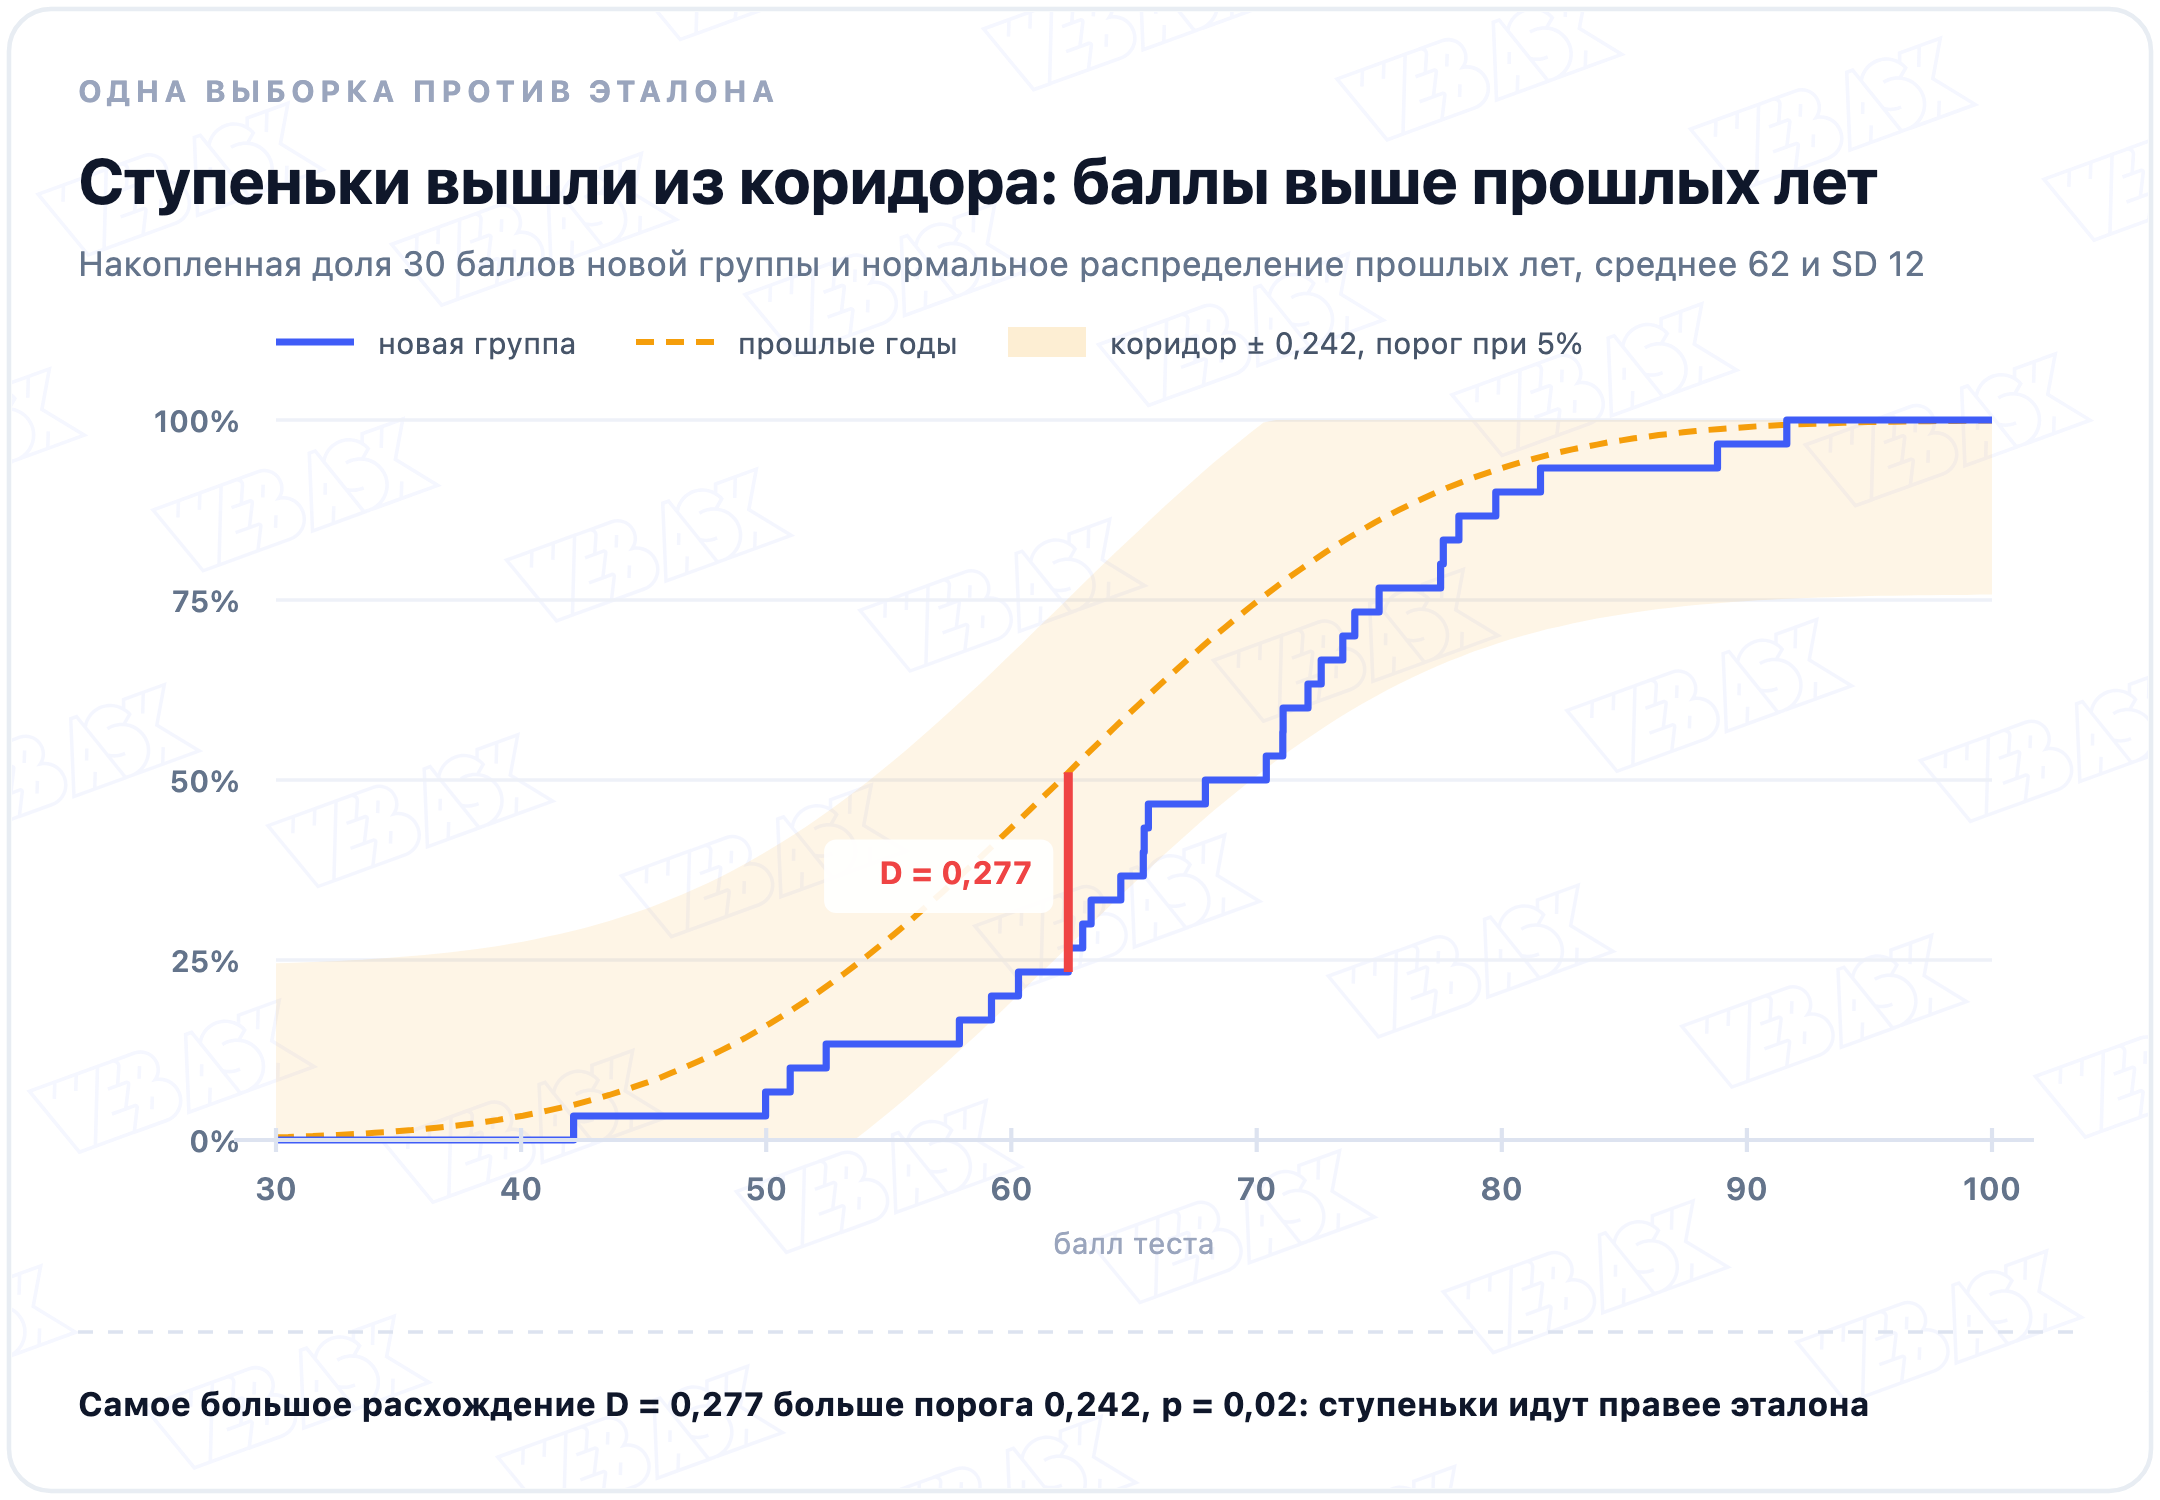
Сильнее всего кривые расходятся около 62 баллов. По эталону ниже этой отметки должна оказаться половина результатов, точнее 51%, а в новой группе там 7 человек из 30, то есть 23%. Разница между этими долями и есть D = 0,277.
Дальше D сравнивают с порогом. Для 30 наблюдений и уровня значимости 5% порог равен 0,242, на графике это коридор вокруг эталона. Пока лесенка не выходит из коридора, данные с эталоном согласуются. Здесь она выходит, p = 0,016: группа написала тест лучше прошлых групп, и случайностью это объяснить трудно. Для выборок больше 35 наблюдений порог считают приближённо как 1,36 / √n, по таблице Фрэнка Мэсси 1951 года.
Две выборки: медианы равны, распределения разные
Вернёмся к примеру из начала: время прохождения анкеты у 150 человек, пришедших по ссылке из письма, и у 150 из соцсетей. Данные смоделированы так: по письму люди отвечают в своём темпе, а в соцсетях около трети анкету пролистывает.
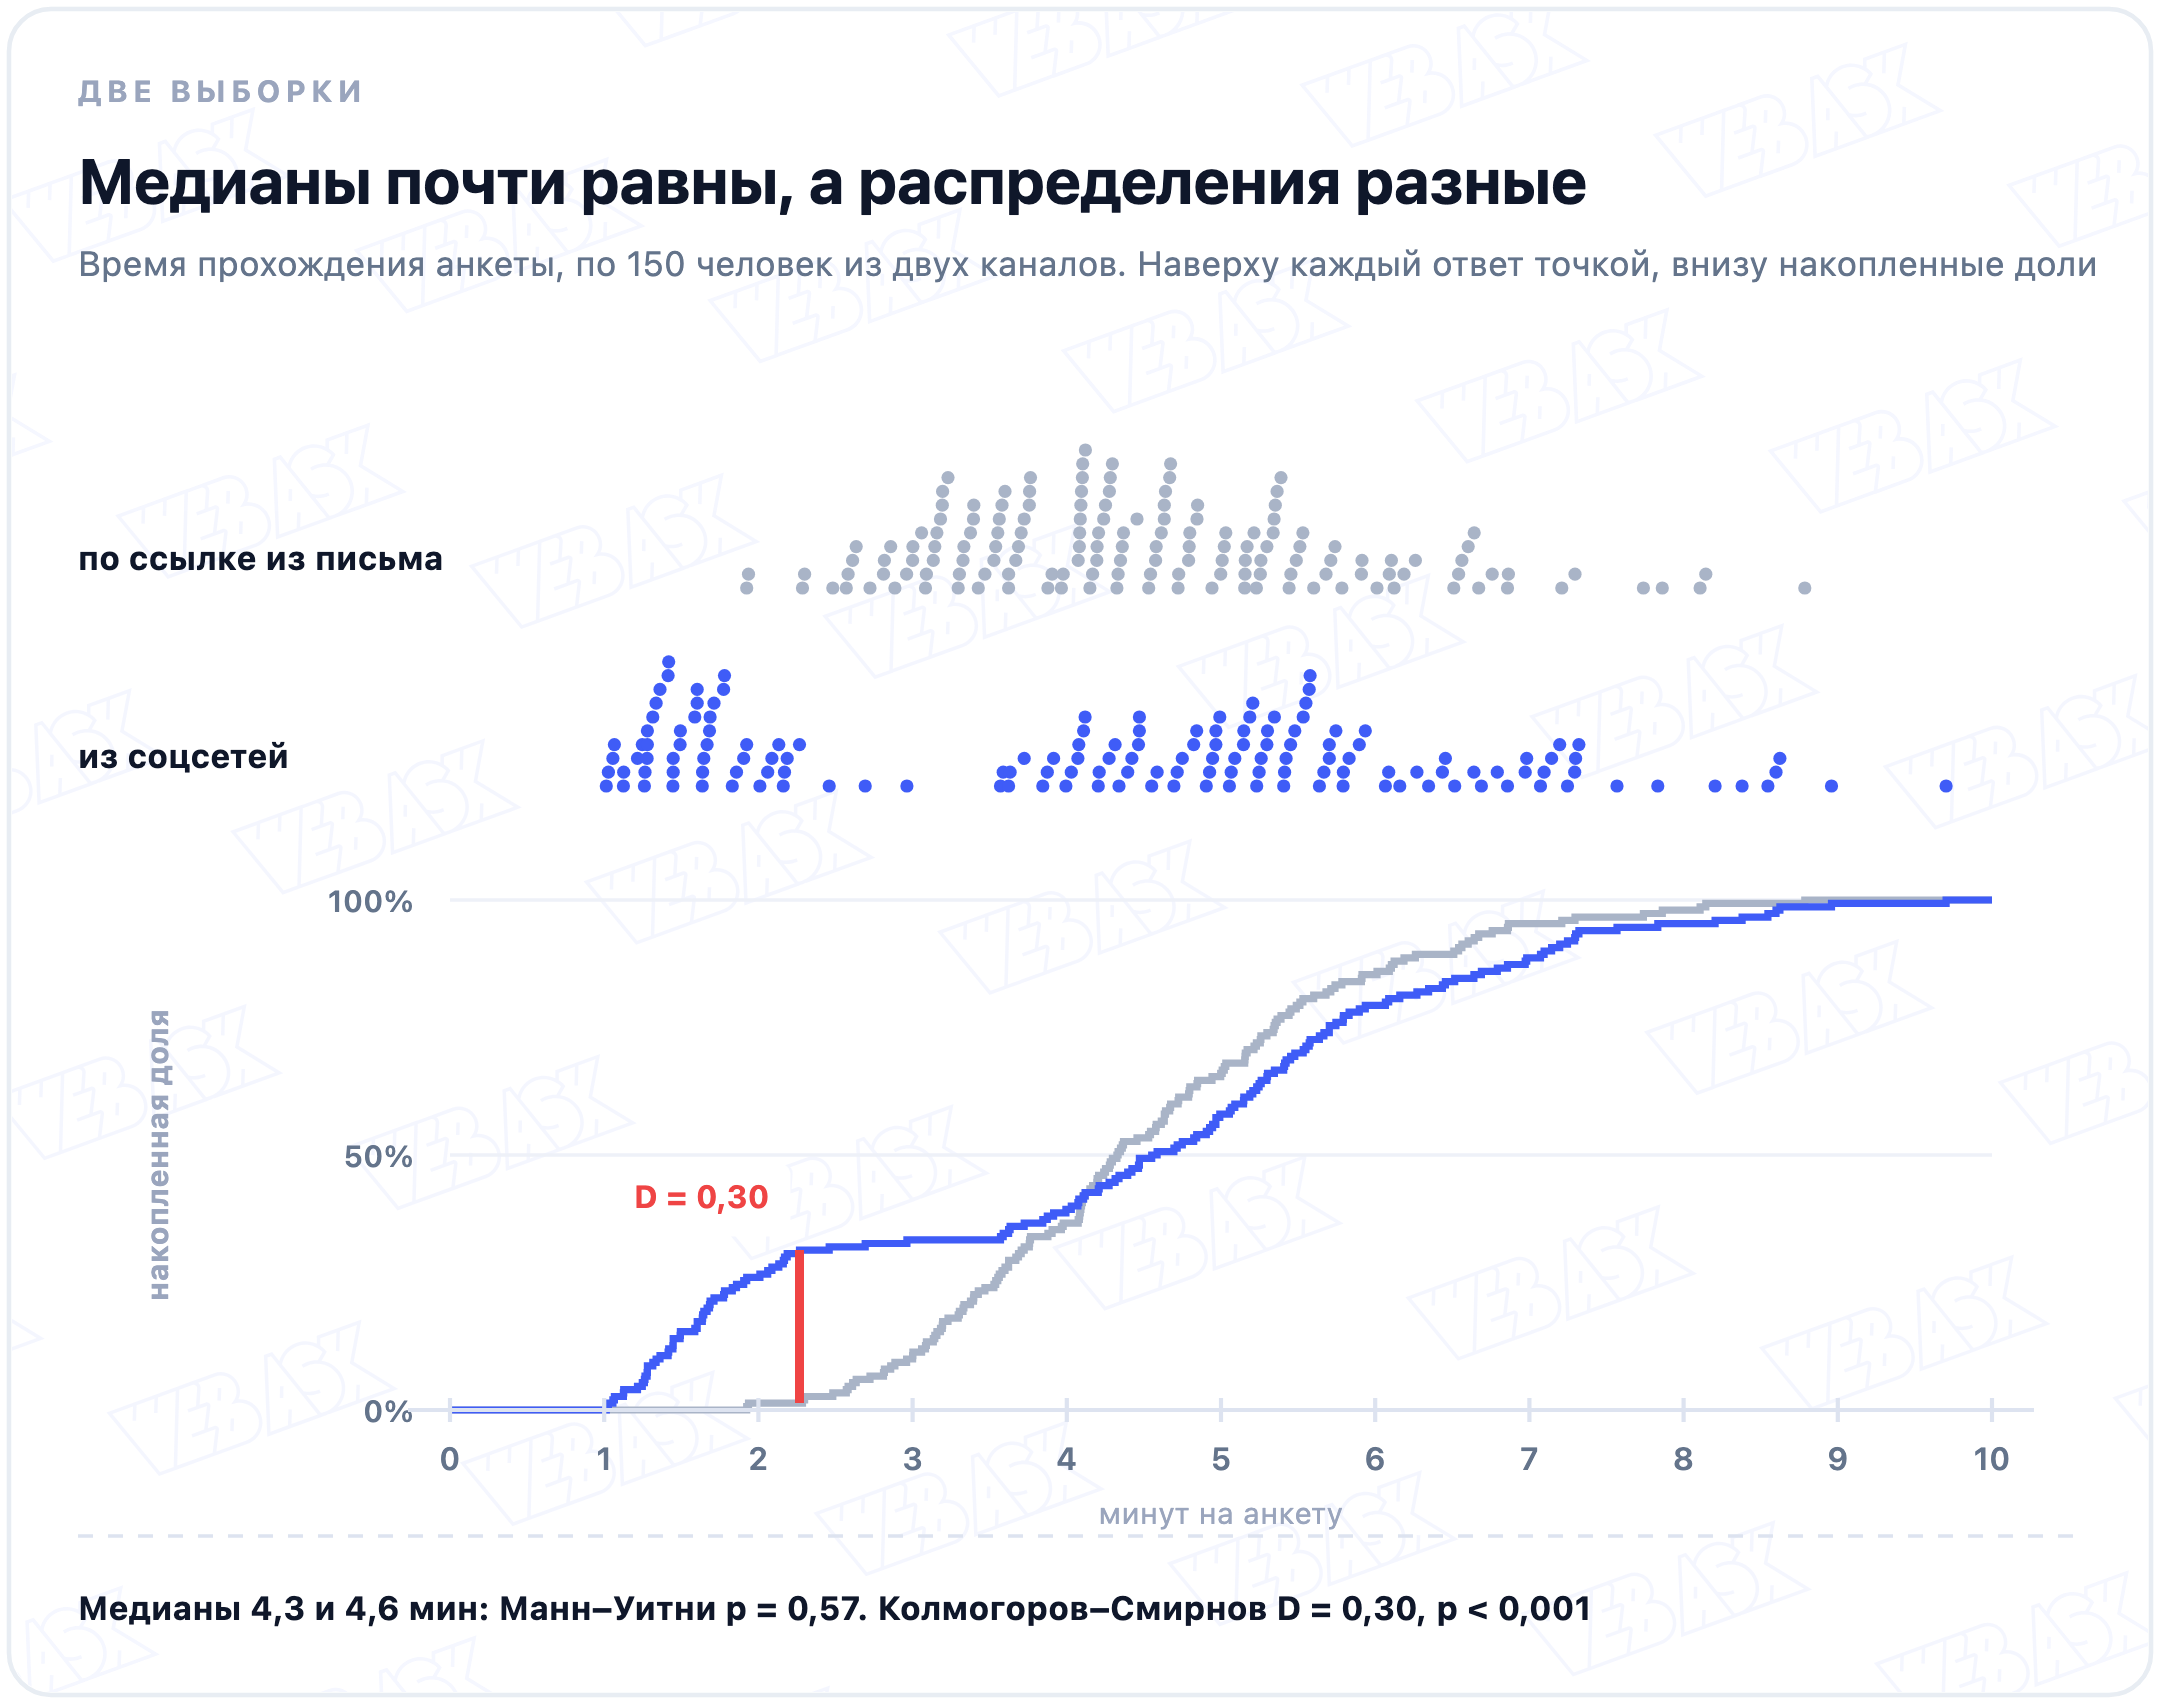
Самый большой разрыв приходится на отметку около 2,3 минуты: к ней из соцсетей анкету закончили 47 человек из 150, по письму двое. D = 0,30, p меньше 0,001. Порог для двух выборок считают как 1,36 × √((n + m) / (n × m)), где n и m размеры выборок, для 150 и 150 он около 0,157.
Манн–Уитни на тех же данных даёт p = 0,57. Он проверяет, кто в целом быстрее, а быструю треть из соцсетей уравновешивают остальные: им нужно около 5,3 минуты против 4,3 у письма. Колмогоров–Смирнов реагирует на любую разницу в форме, и второй горб для него такое же различие, как сдвиг.
Поэтому на вопрос «у какой группы ответы выше» отвечает критерий Манна–Уитни, к сдвигу он чувствительнее. А одинаково ли устроены ответы, покажет Колмогоров–Смирнов. Для времени прохождения важнее как раз второй вопрос: слишком быстрые анкеты разбирают отдельно, это часть поиска недобросовестных ответов.
Проверка нормальности и поправка Лиллиефорса
Чаще всего критерий запускают, чтобы проверить нормальность перед t-тестом. Среднего и SD генеральной совокупности обычно никто не знает, и их берут из той же выборки. Кривая с такими параметрами подстраивается под данные, D выходит меньше, и обычный порог перестаёт работать.
Мы проверили это на 4000 выборок по 40 наблюдений из настоящего нормального распределения. Когда параметры известны заранее, обычный порог 0,210 срабатывает в 5% выборок, как и положено. Когда среднее и SD взяли из самой выборки, порог сработал ровно один раз из 4000.
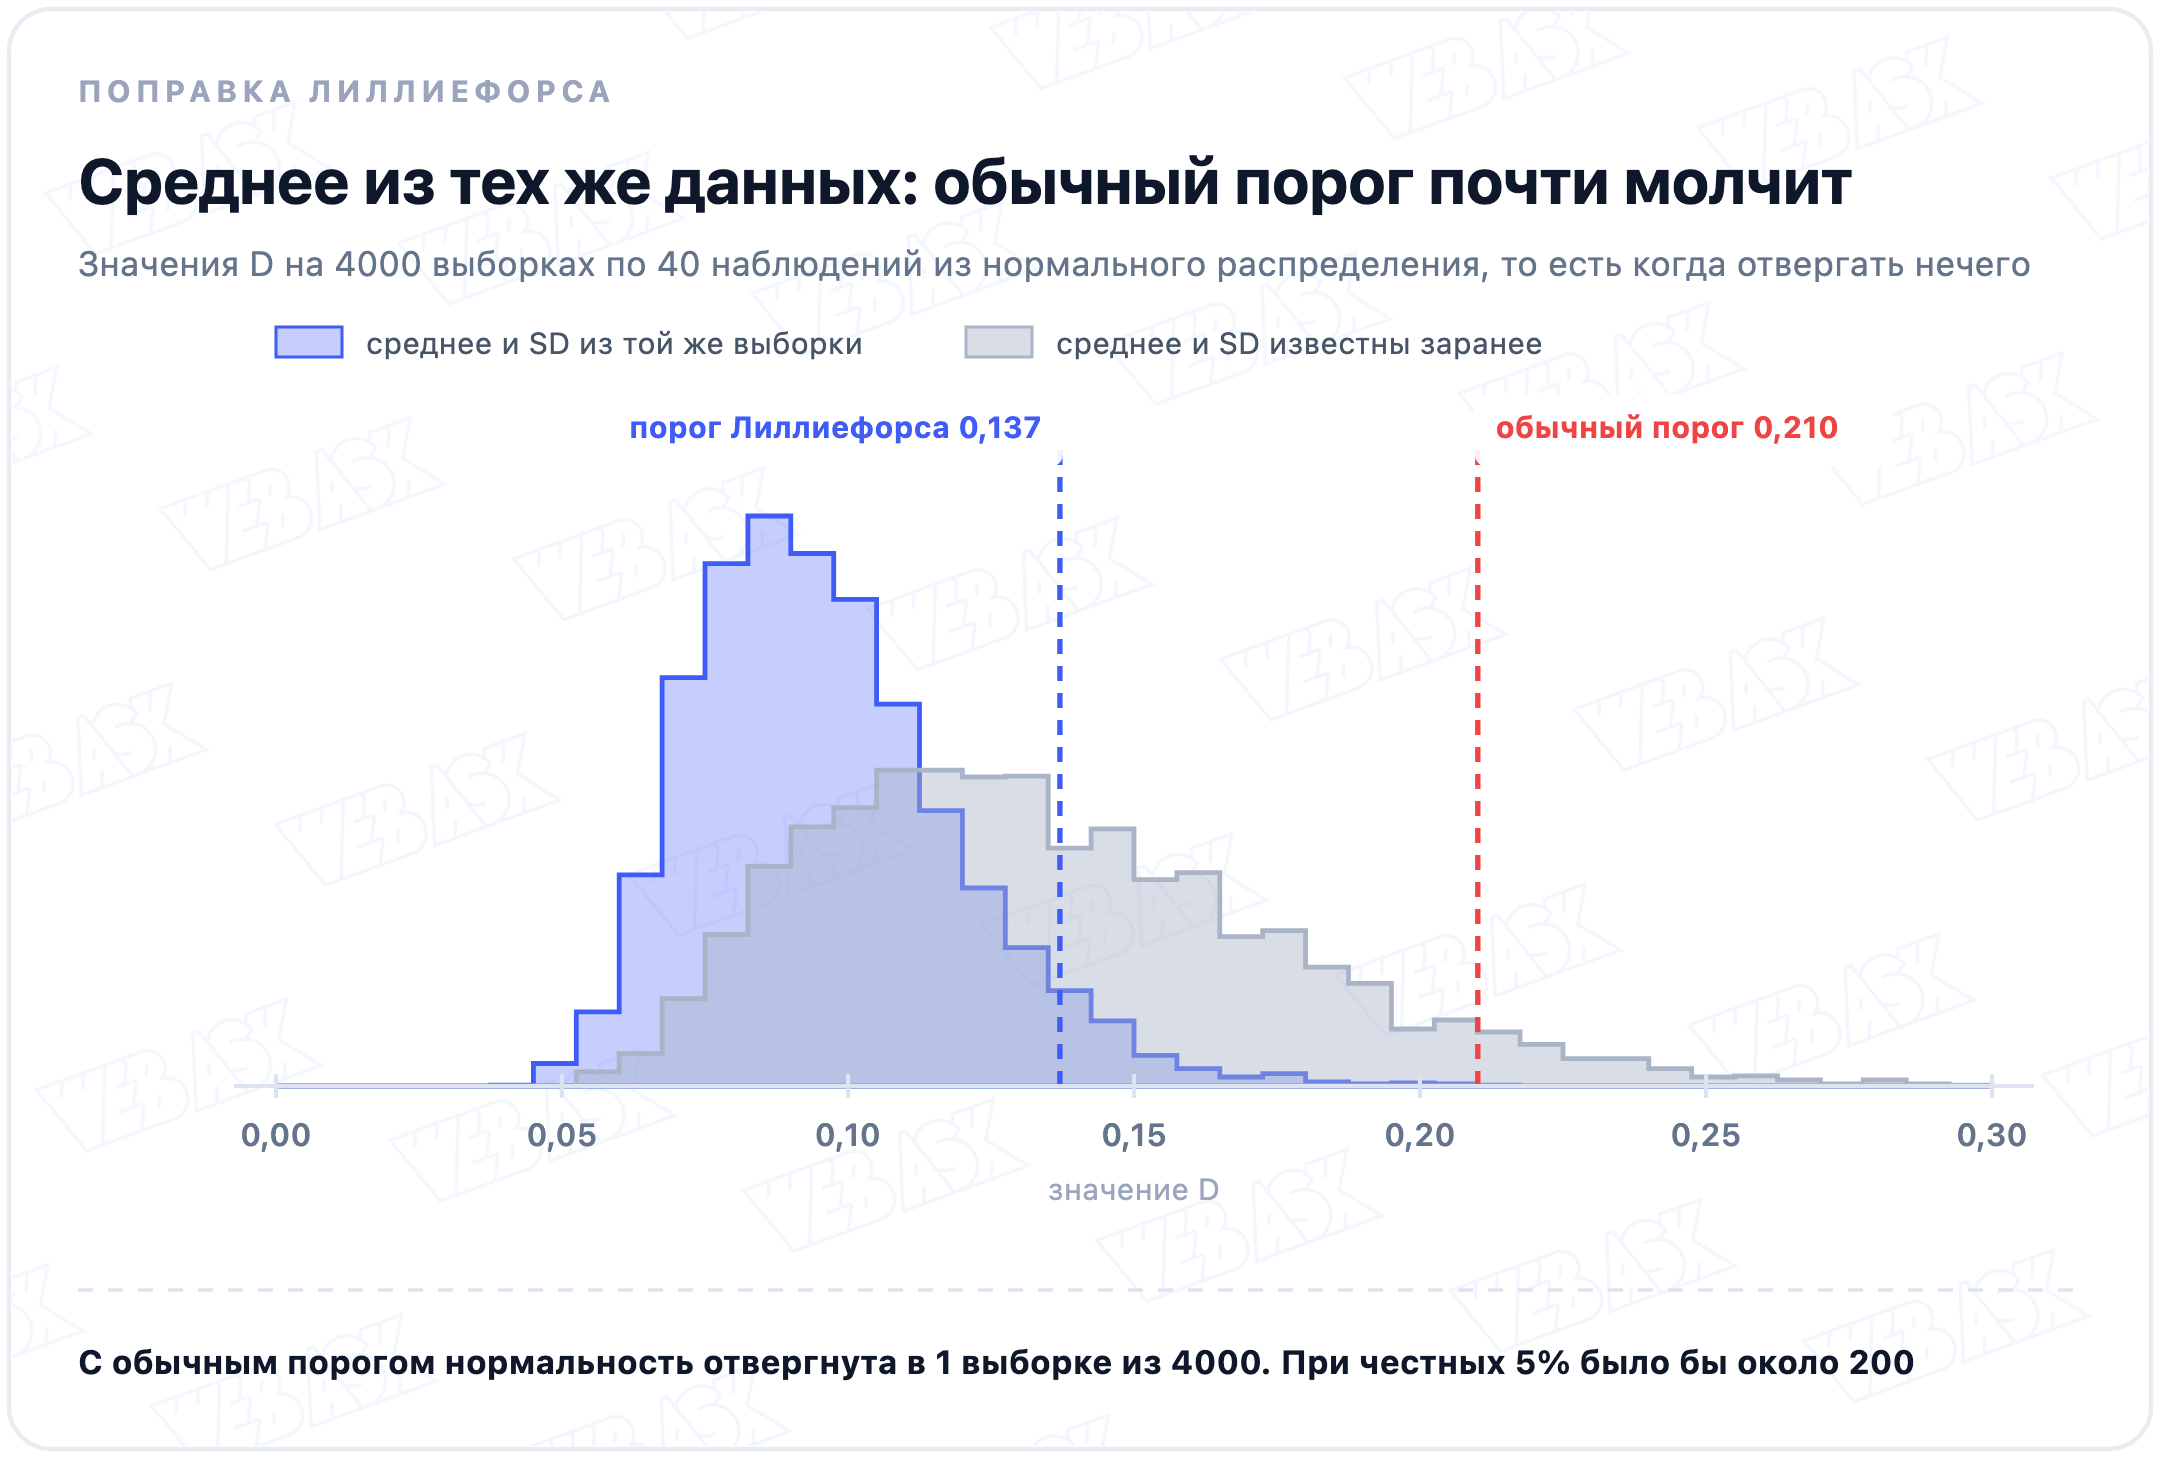
Хьюберт Лиллиефорс в статье 1967 года рассчитал для этого случая свои пороги методом Монте-Карло. Для 40 наблюдений его порог около 0,14, в полтора раза ниже обычного, в нашей модели вышло 0,137.
Если данные на самом деле не нормальные, выбор порога решает всё. Мы взяли скошенные выборки по 40 наблюдений, похожие на время прохождения анкеты (асимметрия около 1). Обычный порог заметил отклонение от нормальности в 1% выборок, порог Лиллиефорса в 36%, критерий Шапиро–Уилка в 55%. Поэтому нормальность обычно проверяют Шапиро–Уилком, а Колмогорова–Смирнова берут только с поправкой. SPSS в окне Explore так его и показывает, с пометкой Lilliefors Significance Correction.
Чего критерий не показывает
- Чем различаются распределения. Сдвиг, разный разброс, второй горб и длинный хвост дают один ответ: различие есть. Выше ли одна группа и что вообще случилось, видно только на графике и на самих точках.
- Расхождения на краях. Критерий чувствительнее в середине распределения, чем в хвостах, это ограничение отмечает и справочник NIST. Если важны редкие крайние значения, например очень долгие анкеты, берут критерий Андерсона–Дарлинга, он внимательнее к хвостам.
- Что распределения одинаковы. p от 0,05 и выше значит только, что различие не доказано. У двух групп по 30 человек значимым выходит D от 0,37, и расхождение долей почти на треть тест пропустит.
- Важно ли различие. На двух группах по 5000 ответов значимым выходит уже D = 0,03. Сам D удобно читать как размер эффекта: на сколько процентных пунктов расходятся доли в точке наибольшего расхождения. Три пункта обычно ничего не меняют, тридцать меняют многое.
Частые ошибки
- Среднее и SD из той же выборки при обычном пороге. Тест тогда почти никогда не отвергает нормальность, в нашей модели один раз из 4000. Нужна поправка Лиллиефорса: в R функция
lillie.testиз пакета nortest, в Pythonlillieforsиз библиотеки statsmodels. - Эталон по умолчанию в Python. Вызов
scipy.stats.kstest(x, 'norm')без параметров сравнивает данные со стандартным нормальным распределением, где среднее 0, а SD 1. Баллы теста на него не похожи совсем: на нашем примере D = 1 и p = 0. Параметры передают явно:kstest(x, 'norm', args=(62, 12)). - Шкала от 1 до 5. Критерий рассчитан на непрерывные данные без совпадений. У пятибалльной шкалы всего пять значений и десятки одинаковых ответов на каждом, и p по обычным формулам выходит завышенным: тест осторожничает и пропускает различия. R при проверке одной выборки прямо предупреждает о совпадающих значениях. Две группы с ответами по шкале сравнивают Манном–Уитни или хи-квадратом по таблице ответов.
Как посчитать в Excel, R и Python
В Excel готовой функции нет, но для двух выборок хватает четырёх формул. Допустим, время из письма лежит в A2:A151, из соцсетей в B2:B151.
- Соберите значения в один столбец. Скопируйте оба столбца друг под другом в C, получится 300 значений в C2:C301.
- Посчитайте доли первой выборки. В D2 формула
=СЧЁТЕСЛИ(A:A;"<="&C2)/150даёт долю ответов из письма не больше значения в C2. - Повторите для второй выборки. В E2 та же формула для столбца B, в F2 модуль разницы
=ABS(D2-E2). Протяните формулы до строки 301. - Найдите D и сравните с порогом. D равна
=МАКС(F2:F301), порог при 5% для двух выборок по 150 человек=1,36*КОРЕНЬ(2/150), около 0,157. Если D больше порога, распределения различаются.
Для одной выборки значения сортируют, для i-го считают долю эталона, например =НОРМ.РАСП(A2;62;12;ИСТИНА), и сравнивают её с i/n и (i − 1)/n. Наибольшее из этих расхождений и есть D.
- R.
ks.test(a, b)для двух выборок,ks.test(x, "pnorm", 62, 12)для сравнения с эталоном. - Python.
scipy.stats.ks_2samp(a, b)для двух выборок,scipy.stats.kstest(x, 'norm', args=(62, 12))для одной. - SPSS. Analyze → Nonparametric Tests → Legacy Dialogs → 2 Independent Samples, отметка Kolmogorov-Smirnov Z.
Как это сделано в WebAsk
Как найти выбросы в ответах опросаОтдельного расчёта Колмогорова–Смирнова в WebAsk нет, но данные для него собираются по ходу опроса. Время прохождения каждой анкеты видно в разделе «Ответы», там же баллы, если опрос устроен как тест с подсчётом баллов. Фильтр «Время прохождения» показывает анкеты, заполненные быстрее минуты, за одну-две минуты и так далее, и быструю группу видно ещё до расчёта. Через API время приходит полем filling_time_seconds, в секундах, так его удобно забрать в таблицу целиком.
Чтобы сравнить каналы, каждому дают свою ссылку со скрытой переменной, например ?source=email и ?source=social. Такие ссылки собирает конструктор ссылок со скрытыми переменными, а фильтр по переменной в «Ответах» разводит анкеты по каналам. Сами ответы выгружаются в XLSX, CSV или SPSS.
Коротко
- У критерия два варианта: выборка против эталона, заданного заранее, и две выборки между собой.
- Статистика D равна самому большому расхождению накопленных долей, порог зависит от размера выборки: для 30 наблюдений 0,242.
- Две выборки он различает по любой разнице в форме и замечает быструю треть там, где медианы равны и Манн–Уитни молчит.
- Если среднее и SD взяты из тех же данных, нужен порог Лиллиефорса. Но для нормальности сильнее Шапиро–Уилк.
- Шкалу от 1 до 5 этим критерием не проверяют: в ней слишком много одинаковых ответов.
Вопросы и ответы
Что такое критерий Колмогорова–Смирнова простыми словами?
Это проверка, одинаково ли распределены данные: в двух выборках или в выборке и заранее заданном эталоне. Мерой разницы берут D, наибольший разрыв между накопленными долями ответов. При p меньше 0,05 распределения считают разными.
Как интерпретировать результат критерия Колмогорова–Смирнова?
Смотрят на p: меньше 0,05 значит, что различие в распределениях есть и случайностью его объяснить трудно. D показывает, насколько расходятся доли в точке наибольшего расхождения: D = 0,30 значит 30 процентных пунктов. Сдвиг это или другая форма, видно только на графике.
Что такое поправка Лиллиефорса?
Это свои пороги критерия для проверки нормальности, когда среднее и стандартное отклонение оценены по той же выборке. Без поправки тест почти никогда не отвергает нормальность: на 40 наблюдениях обычный порог 0,210, а нужный около 0,14. Таблицу порогов Лиллиефорс опубликовал в 1967 году.
Как проверить нормальность распределения критерием Колмогорова–Смирнова?
Если параметры нормального распределения известны заранее, подойдёт обычный тест. Если их считают по тем же данным, нужна поправка Лиллиефорса: lillie.test в R, lilliefors в Python, Explore в SPSS. Но для нормальности сильнее Шапиро–Уилк: на скошенных данных в нашей модели он замечал отклонение в 55% выборок, Колмогоров–Смирнов с поправкой в 36%.
Чем критерий Колмогорова–Смирнова отличается от Манна–Уитни?
Манн–Уитни проверяет, у какой группы значения в целом выше, и к такому сдвигу он чувствительнее. Колмогоров–Смирнов замечает любую разницу в распределениях, в том числе при равных медианах: другой разброс или группу слишком быстрых ответов.
Как посчитать критерий Колмогорова–Смирнова в Excel?
Готовой функции нет. Для двух выборок все значения собирают в один столбец, для каждого функцией СЧЁТЕСЛИ считают долю каждой выборки не больше него и берут модуль разницы. Максимум этих модулей и есть D, порог при 5% равен 1,36 × √((n + m) / (n × m)).
Опубликовано 14 октября 2026