
 Анкетолог
 Typeform
 Тестограф
 Яндекс Формы
 Google Forms
 SurveyMonkey
 Microsoft Forms
 Online Test Pad
 Oprosso
 Simpoll


 Алексей Логинов
Средняя оценка сервиса 7,9, а медиана 9: больше половины клиентов поставили 9 или 10, и среднее вниз тянут немногие низкие оценки. Насколько перекошены ответы, Excel скажет одним числом.
Что такое асимметрия и эксцесс
Асимметрия и эксцесс (skewness, kurtosis) — это меры формы распределения: в какую сторону вытянут хвост и как часто встречаются крайние значения.
Калькулятор медианы и перцентилей Введите выборку чисел — получите медиану, квартили Q1/Q3 и перцентили ПосчитатьАсимметрию считают по кубам отклонений от среднего, а эксцесс по четвёртым степеням, поэтому он так сильно зависит от далёких значений.
Знак асимметрии показывает сторону хвоста. Плюс значит длинный хвост вправо: так устроены время заполнения анкеты, доход, сумма чека, где большинство значений скромные, а редкие большие тянут среднее вверх. Минус значит хвост влево, как у оценок с потолком: почти все ставят высокие баллы, а редкие единицы и двойки уводят среднее вниз.
Эксцесс как отдельное число определил Карл Пирсон в 1905 году, он же назвал распределения с положительным эксцессом лептокуртическими, а с отрицательным платикуртическими. Excel и SPSS считают эксцесс с вычетом тройки, чтобы у нормального распределения выходил ноль. В учебниках встречаются оба варианта, так что, прежде чем сравнивать с чужими порогами, проверьте, о каком эксцессе речь.
Как читать знак и величину
Как провести дескриптивный анализНа картинке три опроса с разной формой ответов. Сплошная черта отмечает медиану, пунктир среднее, и по тому, как черты разошлись, видно, куда тянет хвост.
Насколько вероятно, что вы порекомендуете нас коллеге?
Вот и всё — такой опрос собирается за пару минут, а индекс WebAsk считает сам.
Выбрать шаблон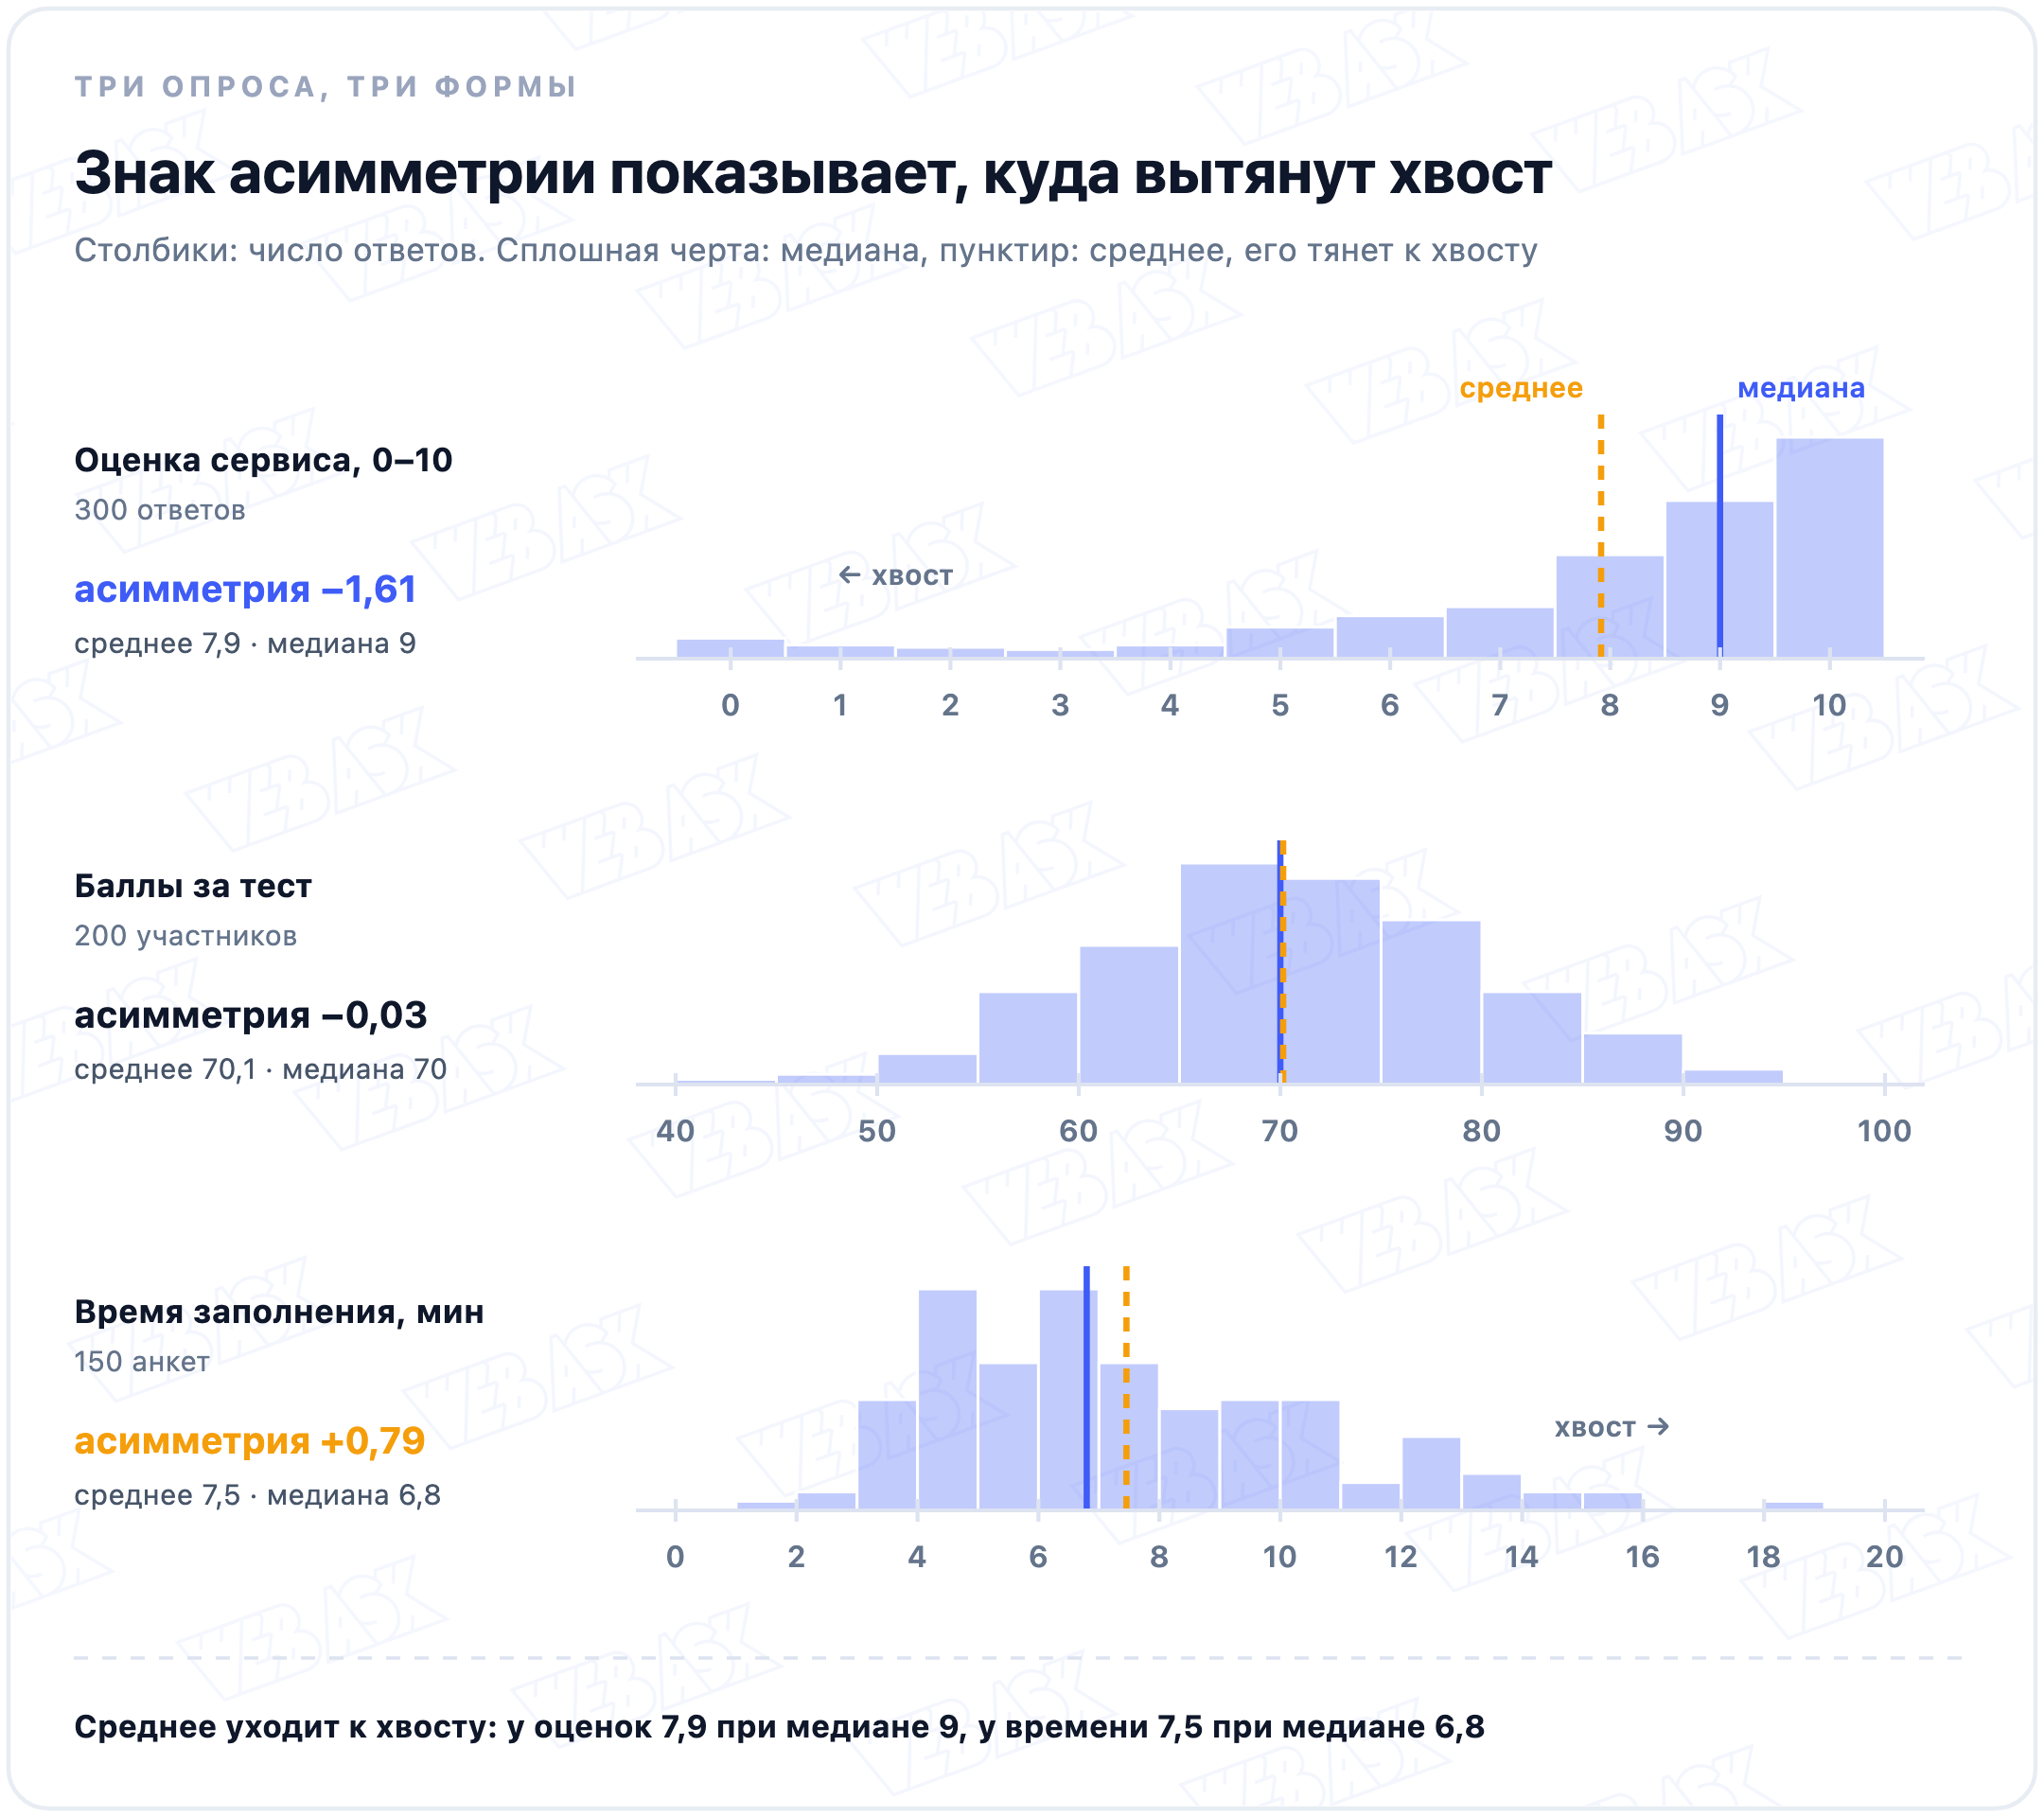
У оценок сервиса асимметрия −1,61: девятку или десятку дали 56% клиентов, медиана 9, а среднее 7,9, его опускают 10% оценок от 0 до 4. Баллы теста симметричны: −0,03, среднее с медианой совпали. У времени заполнения +0,79: медиана 6,8 минуты, среднее 7,5, хвост доходит до 18,7 минуты.
Чем дальше число от нуля, тем сильнее перекос. Пороги вроде «до 0,5 почти симметрично» встречаются в учебниках, но на 20–30 ответах они обманывают: там случайный перекос сам доходит до ±1. Для быстрой проверки без СКОС подходит коэффициент Пирсона: 3 × (среднее − медиана) / SD. У оценок он −1,28, у времени +0,63.
Без среднего и SD обходится квартильный коэффициент Боули: (Q3 + Q1 − 2 × медиана) / (Q3 − Q1). Он лежит от −1 до 1 и почти не реагирует на выбросы, потому что берёт только квартили. Для времени заполнения Q1 4,9 минуты, медиана 6,8, Q3 9,5, и коэффициент выходит +0,17.
Как посчитать в Excel и SPSS
- Асимметрия. Под столбцом ответов формула
=СКОС(A2:A301). Функция СКОС считает выборочную асимметрию, для всей совокупности есть СКОС.Г, но на 300 ответах разница в сотых: −1,61 против −1,60. - Эксцесс.
=ЭКСЦЕСС(A2:A301)возвращает эксцесс уже с вычетом тройки: у нормальных данных он около нуля. У оценок сервиса выходит +2,06. - SPSS. Меню Analyze → Descriptive Statistics → Explore выводит асимметрию и эксцесс вместе со стандартными ошибками в столбце Std. Error.
- Проверка на случайность. Разделите асимметрию на её стандартную ошибку. Для 300 ответов ошибка 0,141, и у оценок z = −1,61 / 0,141 ≈ −11,4: перекос настоящий.
Сколько ответов нужно, чтобы верить асимметрии
Перекос получается и у идеально нормальных данных, просто по случаю. В модели взяли по 200 выборок из нормальной совокупности на 20, 50, 100 и 300 ответов и у каждой посчитали асимметрию.
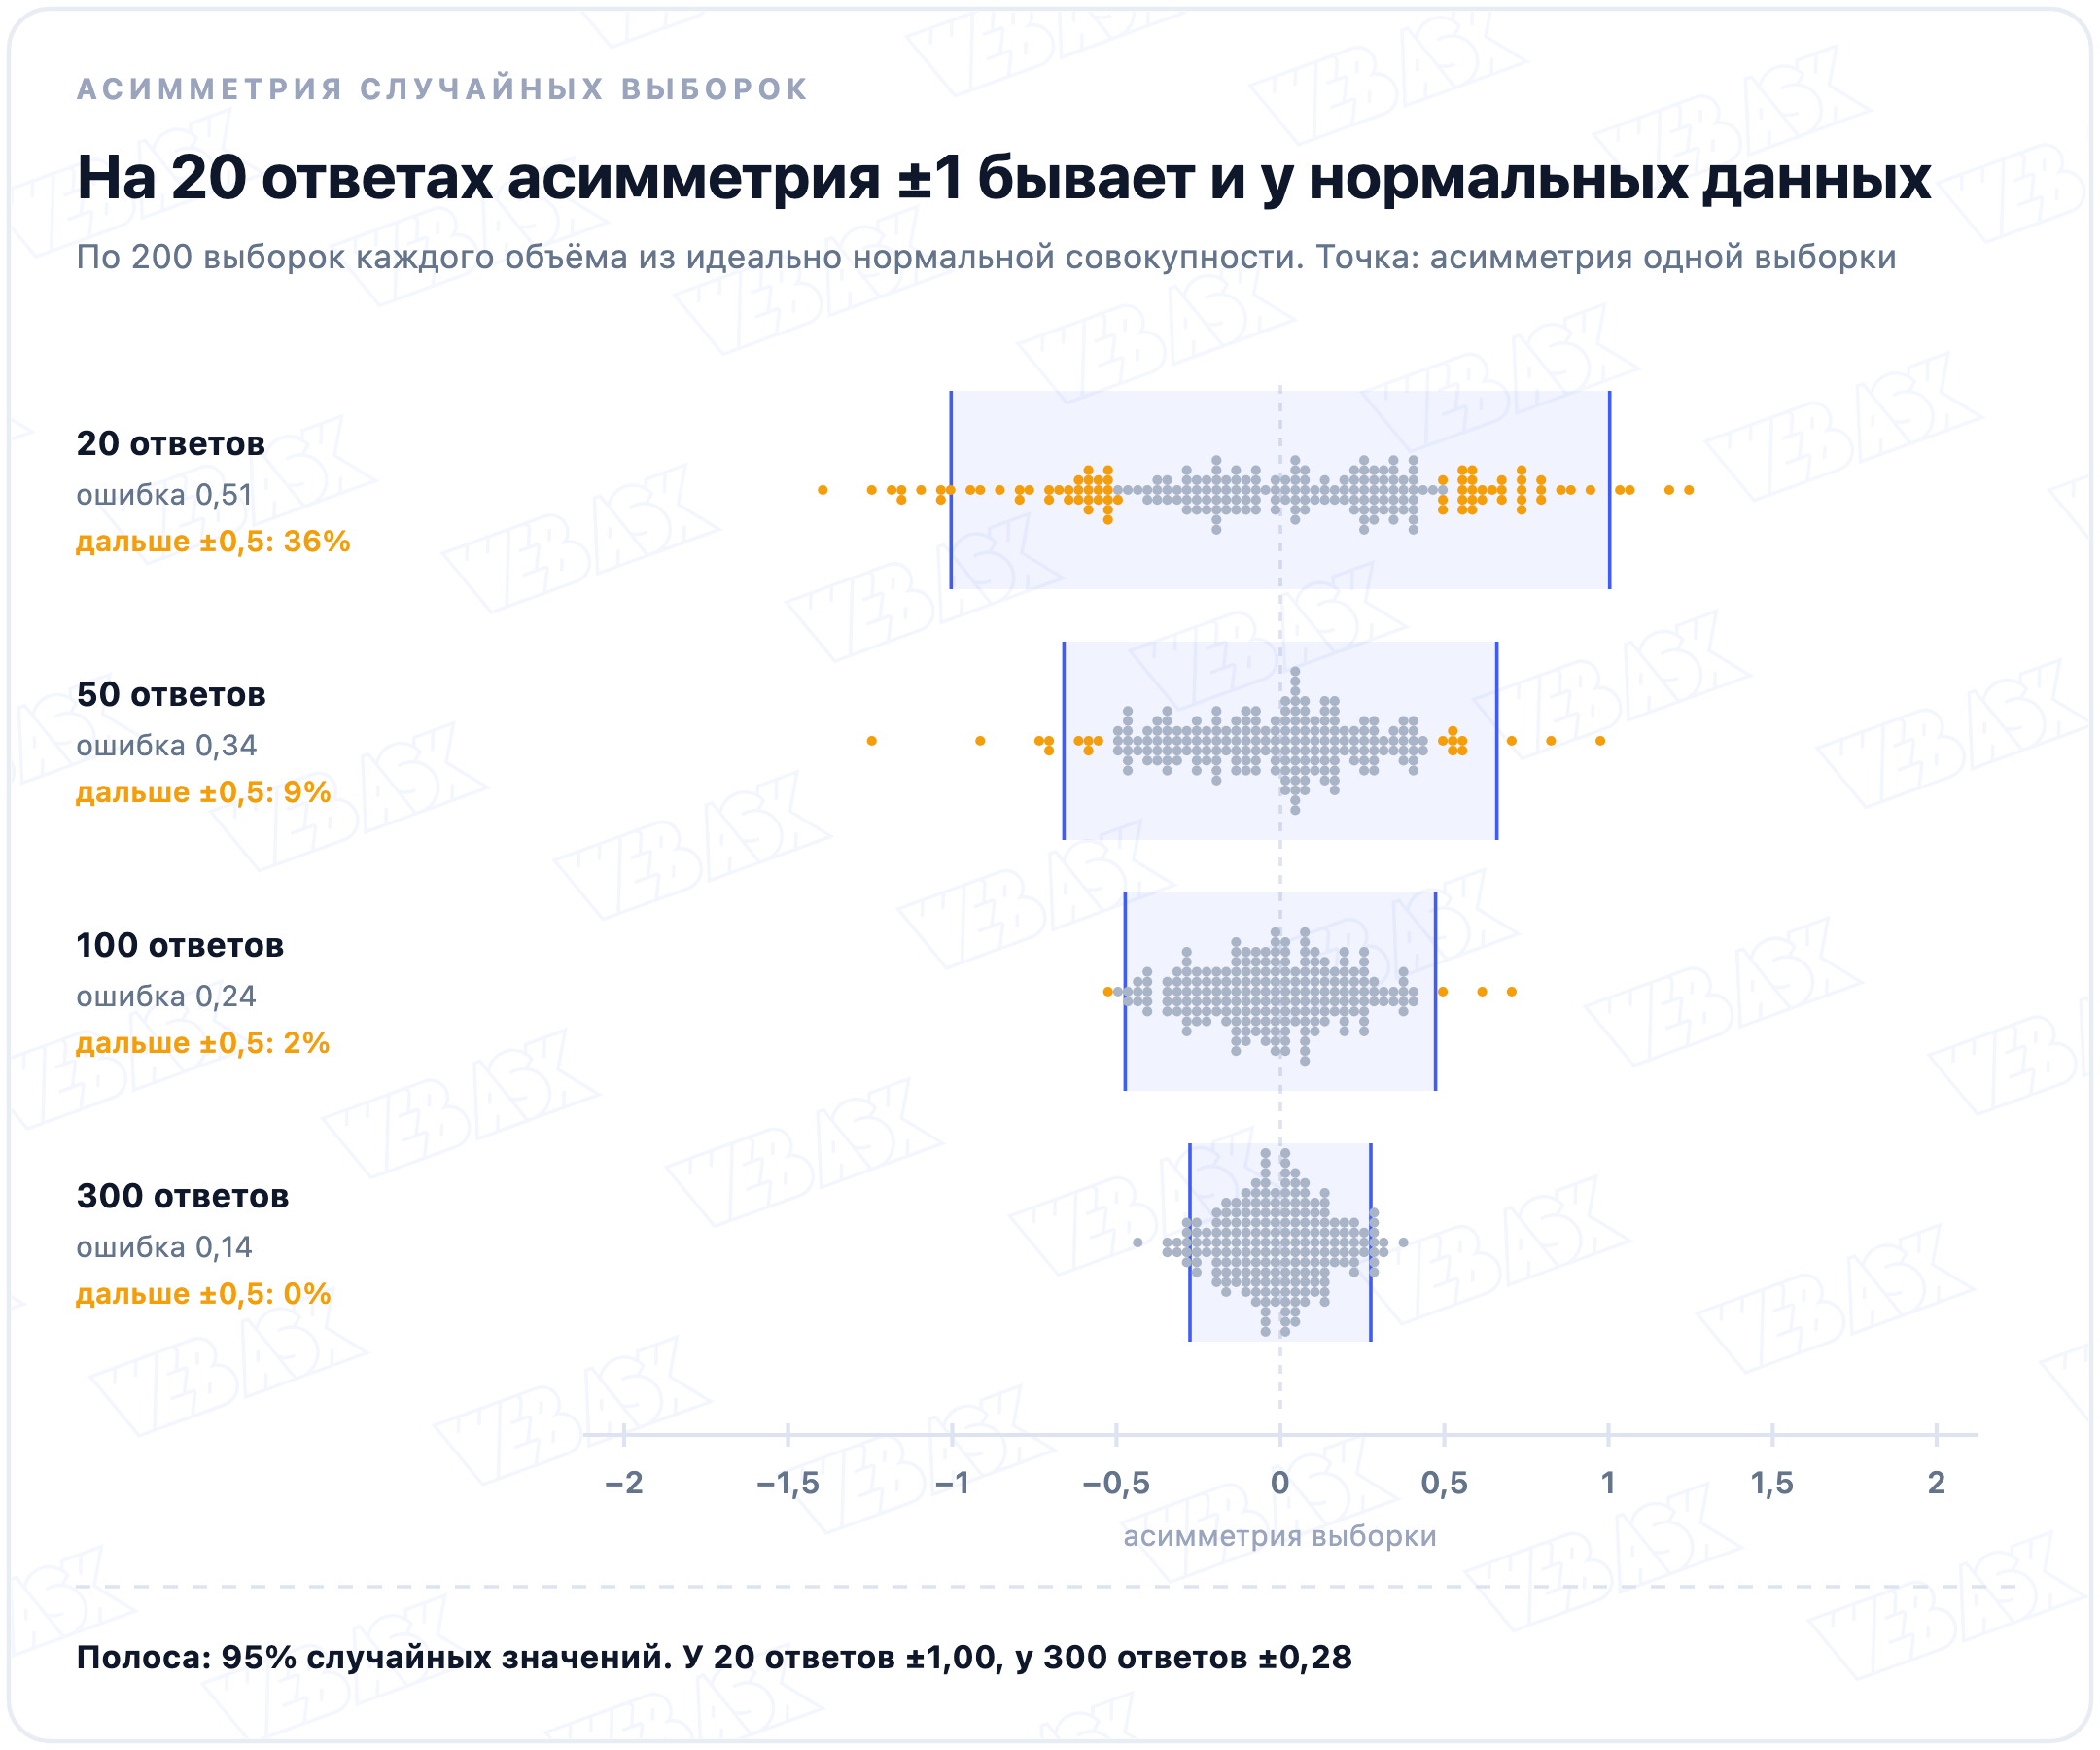
На 20 ответах асимметрия дальше ±0,5 вышла у 36% выборок, на 50 у 9%, на 100 у 2%, на 300 ни у одной. Разброс измеряет стандартная ошибка: SPSS выводит её сама, вручную её считают по формуле √(6n(n − 1) / ((n − 2)(n + 1)(n + 3))). Для прикидки хватит √(6/n).
| Ответов | Ошибка асимметрии | Ошибка эксцесса |
|---|---|---|
| 20 | 0,51 | 0,99 |
| 30 | 0,43 | 0,83 |
| 50 | 0,34 | 0,66 |
| 100 | 0,24 | 0,48 |
| 300 | 0,14 | 0,28 |
| 1000 | 0,08 | 0,15 |
Пороги для отношения z = асимметрия / ошибка предложил корейский статистик Хэ-Ён Ким в заметке 2013 года. До 50 ответов перекос считают настоящим при |z| больше 1,96, от 50 до 300 при |z| больше 3,29, и те же пороги работают для эксцесса, делённого на его ошибку. На больших выборках ошибка так мала, что значимым выходит любой пустяк, поэтому там смотрят на сами числа: асимметрия по модулю больше 2 или эксцесс больше 7 без вычета тройки, то есть больше 4 в Excel, говорят о сильном отклонении от нормального распределения.
Эксцесс говорит о крайних значениях
В справке Excel сказано, что эксцесс характеризует «относительную остроконечность или сглаженность распределения». Это толкование кочует по учебникам и даже журнальным статьям. Статистик Питер Уэстфолл разобрал его в статье 2014 года: от формы вершины эксцесс почти не зависит.
Дело в формуле. Каждое отклонение выражают в сигмах и возводят в четвёртую степень: ответ в пределах одной сигмы даёт меньше единицы, ответ на трёх сигмах даёт 81, на шести 1296. Вершина почти ничего не весит, всё решают несколько далёких ответов.
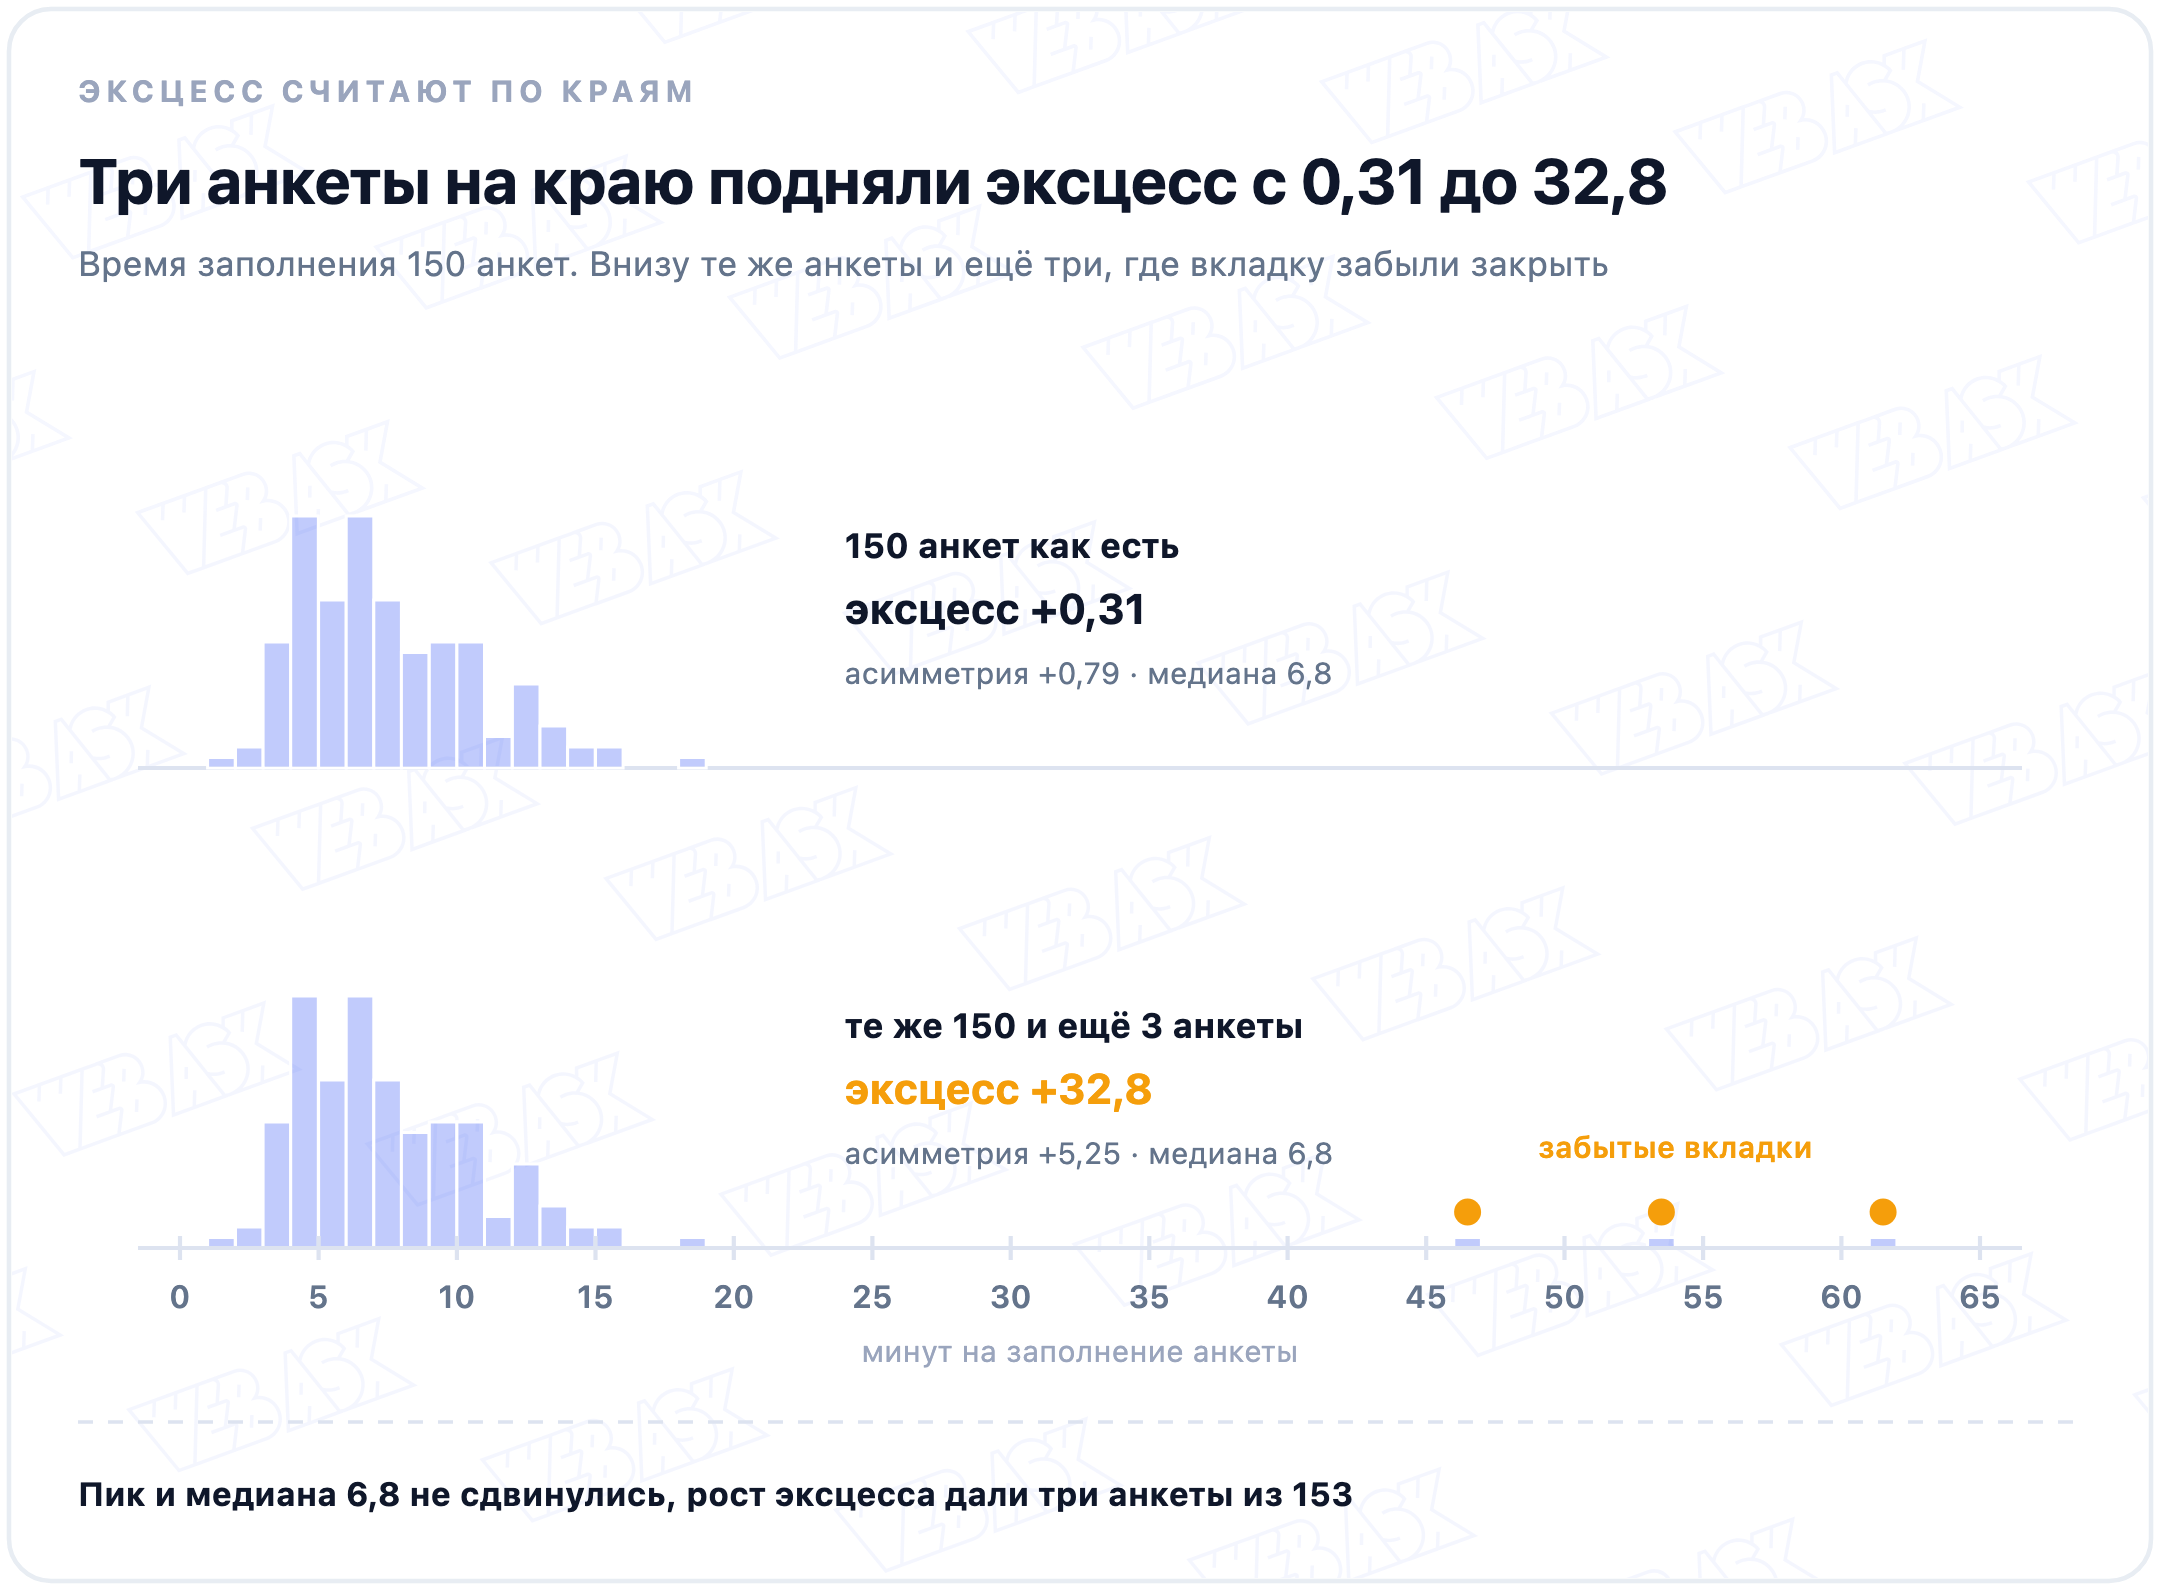
К тем же 150 анкетам добавили три, где вкладку открыли и забыли: 46, 53 и 61 минута. Пик и медиана 6,8 остались на месте, эксцесс вырос с 0,31 до 32,8, асимметрия с 0,79 до 5,25. На три анкеты из 153 пришлось 99,7% суммы четвёртых степеней, на всё, что лежит в пределах одной сигмы, 0,2%.
Обратный пример: у треугольного распределения острый пик, а эксцесс −0,6. Так что большой положительный эксцесс в опросе подсказывает одно: ищите крайние ответы. Забытые вкладки, лишний ноль в сумме, возраст 150 вместо 50.
Чего асимметрия и эксцесс не видят
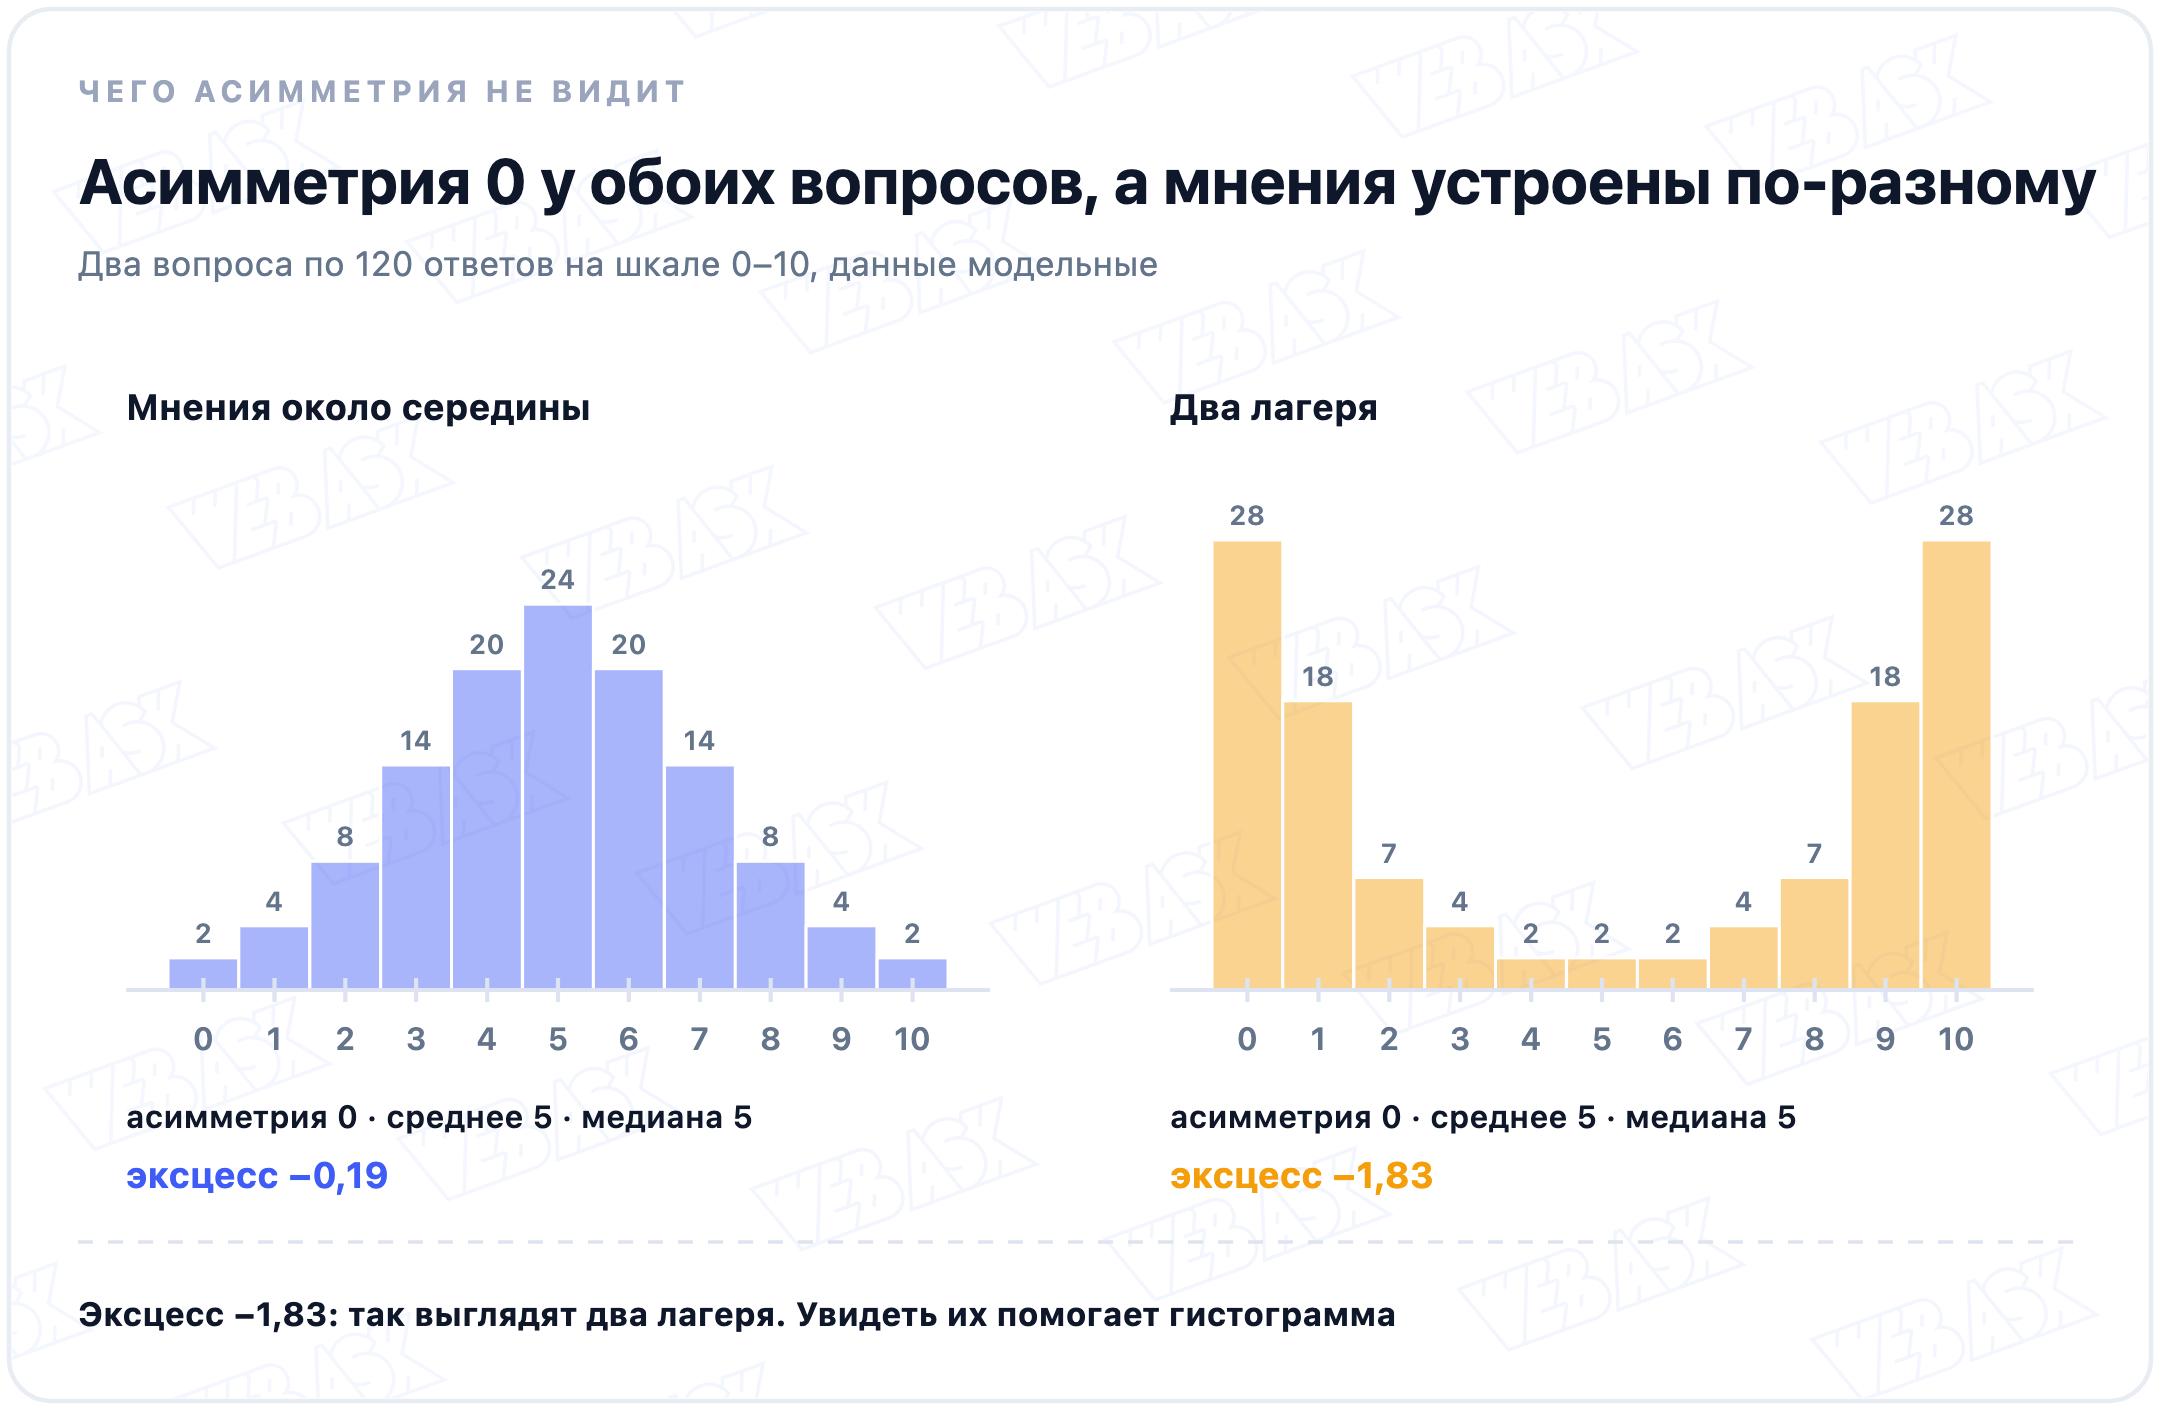
Оба вопроса симметричны: асимметрия 0, среднее и медиана 5. В первом мнения собрались у середины, во втором разошлись к краям, и ответ 5 там выбрали двое из 120. Различает их эксцесс: −0,19 против −1,83. Ниже −2 он не опускается, этот предел получается, когда ответы делятся поровну между двумя значениями.
На коротких шкалах число ещё беднее картинки: ответ на шкале 1–5 принимает пять значений, и одна и та же асимметрия выходит из очень разных распределений. Поэтому сначала смотрят на гистограмму, а потом на коэффициенты. И сами коэффициенты боятся опечаток: одно значение 600 вместо 6 минут перевернёт оба, тогда как медиана и межквартильный размах сдвинутся на волосок.
Что делать со скошенными данными
- Медиана и квартили вместо среднего. Среднее и SD на скошенных данных плохо описывают типичный ответ, а ящик с усами показывает и середину, и хвост.
- Сравнивать ранговыми критериями. На малых выборках вместо t-теста берут критерий Манна–Уитни. На сотнях ответов t-тест переносит умеренную асимметрию, это следствие центральной предельной теоремы.
- Время и деньги логарифмируют. После
=LN(A2)такие данные часто становятся почти симметричными, так в правиле трёх сигм ловят быстрые анкеты. - Формальный ответ даёт тест. Критерий Шапиро–Уилка отвечает «да или нет», а асимметрия и эксцесс показывают, в чём именно отклонение.
Частые ошибки
- Эксцесс как острота пика. Острый треугольник даёт −0,6, а три забытые вкладки 32,8.
- Забыть про тройку. ЭКСЦЕСС в Excel у нормальных данных около 0, без вычета тройки нормальное распределение даёт 3. Порог «больше 7» у Кима как раз для эксцесса без вычета.
- Уверенный вывод по 20 ответам. Случайный разброс асимметрии там ±1, у трети нормальных выборок она уходит дальше ±0,5.
- Форма без гистограммы. Нулевая асимметрия бывает и у двух лагерей.
- Попытка «починить» честно скошенную шкалу. Оценки 0–10 с потолком скошены влево, потому что клиенты довольны. Их описывают долями и медианой, подгонять под нормальное распределение незачем.
Как это сделано в WebAsk
В WebAsk числа удобнее собирать вопросом «Числовой ответ»: туда не впишешь «минут десять», только цифру. Время заполнения каждой анкеты видно в разделе «Ответы» и в поле filling_time_seconds через API, так что забытые вкладки можно найти ещё до расчёта. Ответы выгружаются в XLSX, CSV или SPSS, где дальше работают СКОС, ЭКСЦЕСС и меню Explore.
Квартили для коэффициента Боули сразу посчитает калькулятор медианы и перцентилей, среднее и SD для коэффициента Пирсона выдаст калькулятор стандартного отклонения.
Коротко
- Асимметрия показывает сторону хвоста: плюс у времени и денег, минус у оценок с потолком.
- Большой эксцесс значит тяжёлые края: ищите далёкие значения.
- В Excel их считают СКОС и ЭКСЦЕСС, у нормальных данных оба около нуля.
- На 20 ответах асимметрия ±1 бывает случайно, верить ей можно после деления на стандартную ошибку.
- Оба числа не заменяют гистограмму: два лагеря дают асимметрию 0.
Вопросы и ответы
Что такое асимметрия простыми словами?
Это число говорит, куда вытянут хвост ответов. Положительная асимметрия бывает у времени заполнения анкеты: большинство справляется быстро, единицы сидят долго. Отрицательная у оценок, где почти все довольны.
Что показывает эксцесс?
Насколько часто в данных встречаются крайние значения по сравнению с нормальным распределением. Большой плюс значит несколько далёких выбросов, минус значит лёгкие края, например два лагеря на шкале.
Как посчитать асимметрию и эксцесс в Excel?
Формулой =СКОС(диапазон) для асимметрии и =ЭКСЦЕСС(диапазон) для эксцесса. Excel уже вычитает из эксцесса тройку, поэтому у нормальных данных оба числа около нуля.
Какое значение асимметрии считается большим?
Зависит от числа ответов. Асимметрию делят на её стандартную ошибку: до 50 ответов перекос настоящий при |z| больше 1,96, от 50 до 300 при |z| больше 3,29. На больших выборках смотрят на саму асимметрию, по модулю больше 2 значит сильный перекос.
Почему асимметрия отрицательная?
Хвост ответов уходит к малым значениям: большинство ответов высокие, и несколько низких опускают среднее ниже медианы. Так часто выглядят оценки сервиса, когда клиенты в целом довольны.
Чем асимметрия отличается от эксцесса?
Асимметрия говорит, с какой стороны хвост длиннее. Эксцесс отвечает на другой вопрос: насколько тяжёлые оба края вместе. У двух симметричных лагерей асимметрия 0, а эксцесс близок к −2.
Что делать, если данные скошены?
Описывать их медианой и квартилями, сравнивать группы ранговыми критериями вроде Манна–Уитни, а время и деньги можно прологарифмировать. Но сначала проверьте крайние значения: несколько ошибочных ответов дают и асимметрию, и эксцесс.
Опубликовано 16 октября 2026