
 Анкетолог
 Typeform
 Тестограф
 Яндекс Формы
 Google Forms
 SurveyMonkey
 Microsoft Forms
 Online Test Pad
 Oprosso
 Simpoll


 Алексей Логинов
В анкете вовлечённости семь вопросов, а пар между ними двадцать одна. Рассматривать двадцать одну диаграмму долго, и все эти связи обычно сводят в одну таблицу.
Что такое корреляционная матрица
Корреляционная матрица (correlation matrix) — это таблица, где на пересечении строки и столбца стоит коэффициент корреляции между двумя переменными.
Driver Analysis Что чинить первым: ранжирование драйверов по влиянию на NPS/CSAT. ПосчитатьКорреляционная матрица симметрична: над диагональю повторяются числа из-под неё, а на самой диагонали стоят единицы, поэтому обычно показывают один треугольник.
Для k вопросов в матрице k(k − 1)/2 разных пар: у семи их 21, у двадцати уже 190. Чаще всего в клетках коэффициент Пирсона, тот же, что даёт корреляционный анализ для одной пары. Для порядковых шкал и перекошенных ответов честнее коэффициент Спирмена, матрица от этого не меняет вида. Зато по ней видно то, чего нет в отчёте по отдельным вопросам: какие вопросы дублируют друг друга и какой из них можно убрать из следующей волны.
Как читать матрицу
Корреляция Пирсона простыми словамиНиже матрица модельного опроса 300 сотрудников: семь вопросов по шкале от 1 до 5. Три вопроса о руководителе связаны между собой на уровне 0,48–0,50, два вопроса об условиях на 0,53, а между блоками корреляции от 0,00 до 0,23.
Насколько вероятно, что вы порекомендуете нас коллеге?
Вот и всё — такой опрос собирается за пару минут, а индекс WebAsk считает сам.
Создать свой опрос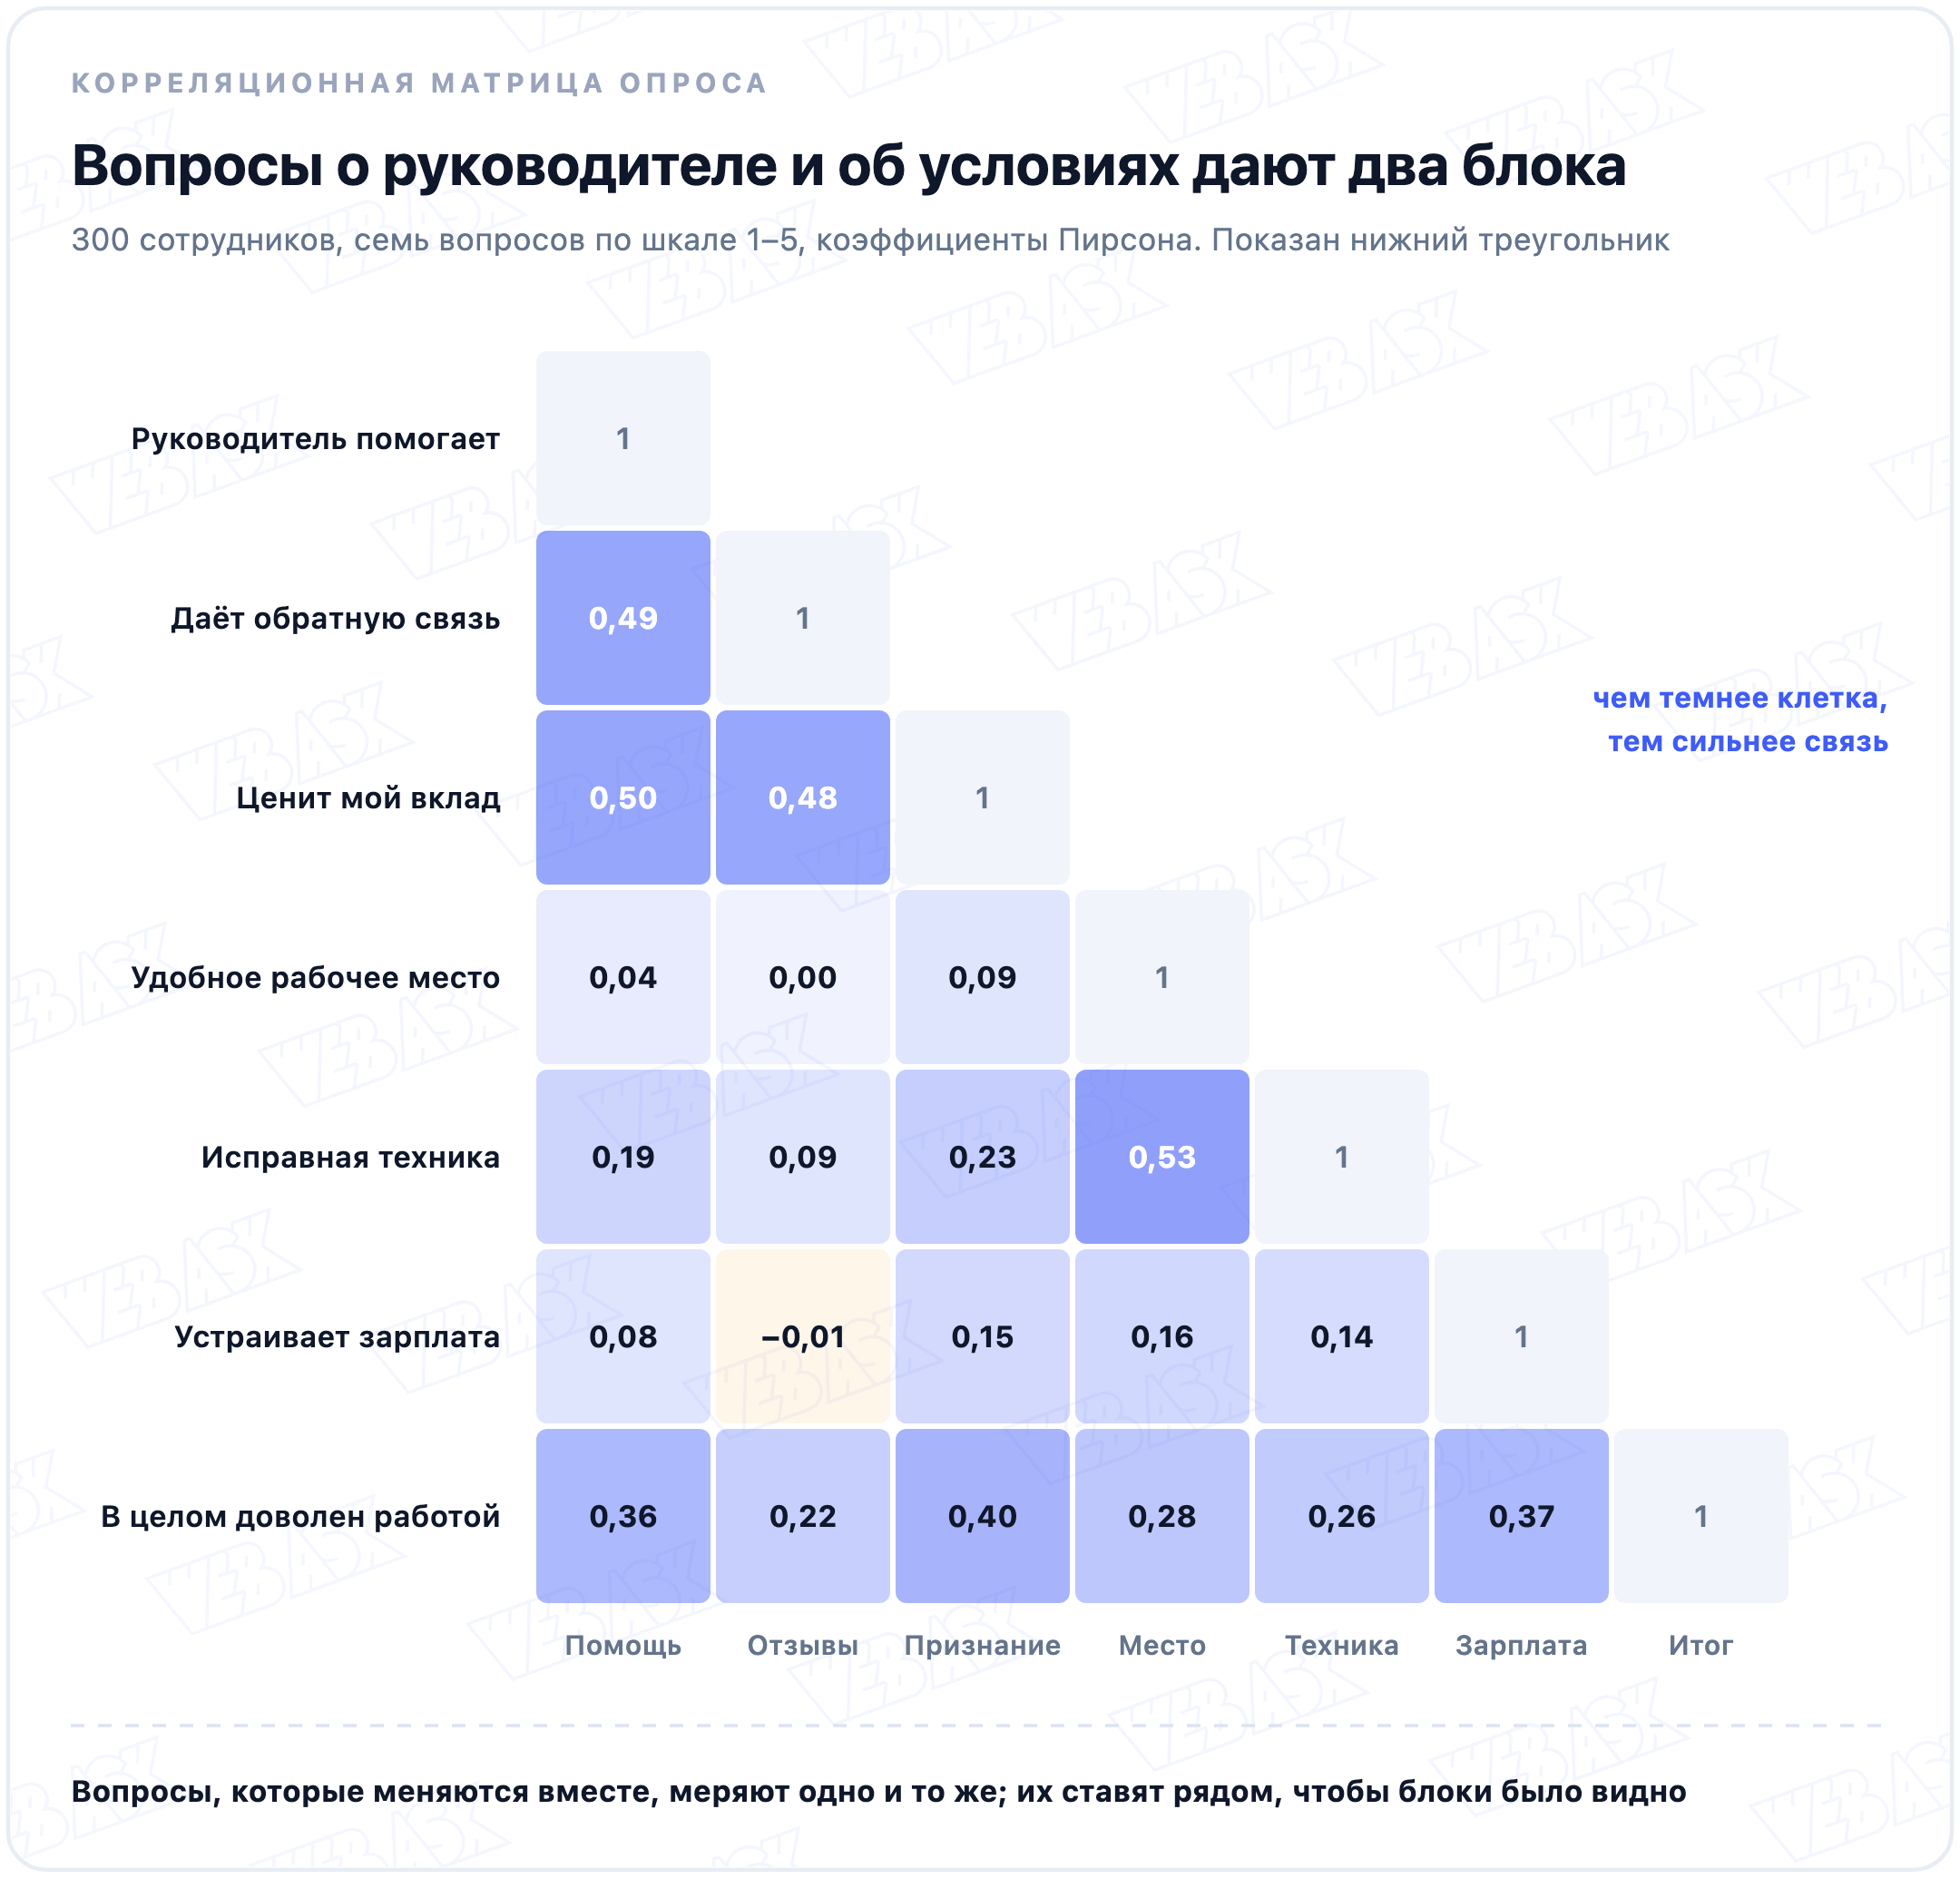
Матрицу читают пятнами. Тёмный квадрат из нескольких клеток значит, что вопросы меряют одно и то же. Такие вопросы можно сложить в индекс, проверив его согласованность альфой Кронбаха, или сократить анкету. Когда блоков много и они размыты, их ищут уже факторным анализом.
Блоки видно, только если связанные вопросы стоят рядом. В порядке анкеты они бывают разбросаны, и матрица выглядит пёстрой без всякого рисунка. Поэтому строки переставляют по темам или по смыслу, а цвет делают по величине: тёмный для сильной связи, светлый для слабой, другой оттенок для отрицательной.
Отрицательная клетка среди положительных чаще всего означает обратную формулировку. Вопрос «Мне не хватает времени на задачи» связан с остальными со знаком минус, хотя меряет то же отношение к работе. Такие вопросы перекодируют до того, как складывать в индекс, и после этого блок в матрице становится однотонным.
Одна клетка не показывает формы связи. Коэффициент 0,4 бывает и у ровного облака точек, и у дуги, и у пары выбросов, поэтому сильные клетки проверяют диаграммой рассеяния.
Почему на малой выборке матрица шумит
Коэффициент корреляции, посчитанный на тридцати анкетах, гуляет сильно. На картинке те же 21 пара: по горизонтали r на всех 300 анкетах, по вертикали на первых 30.
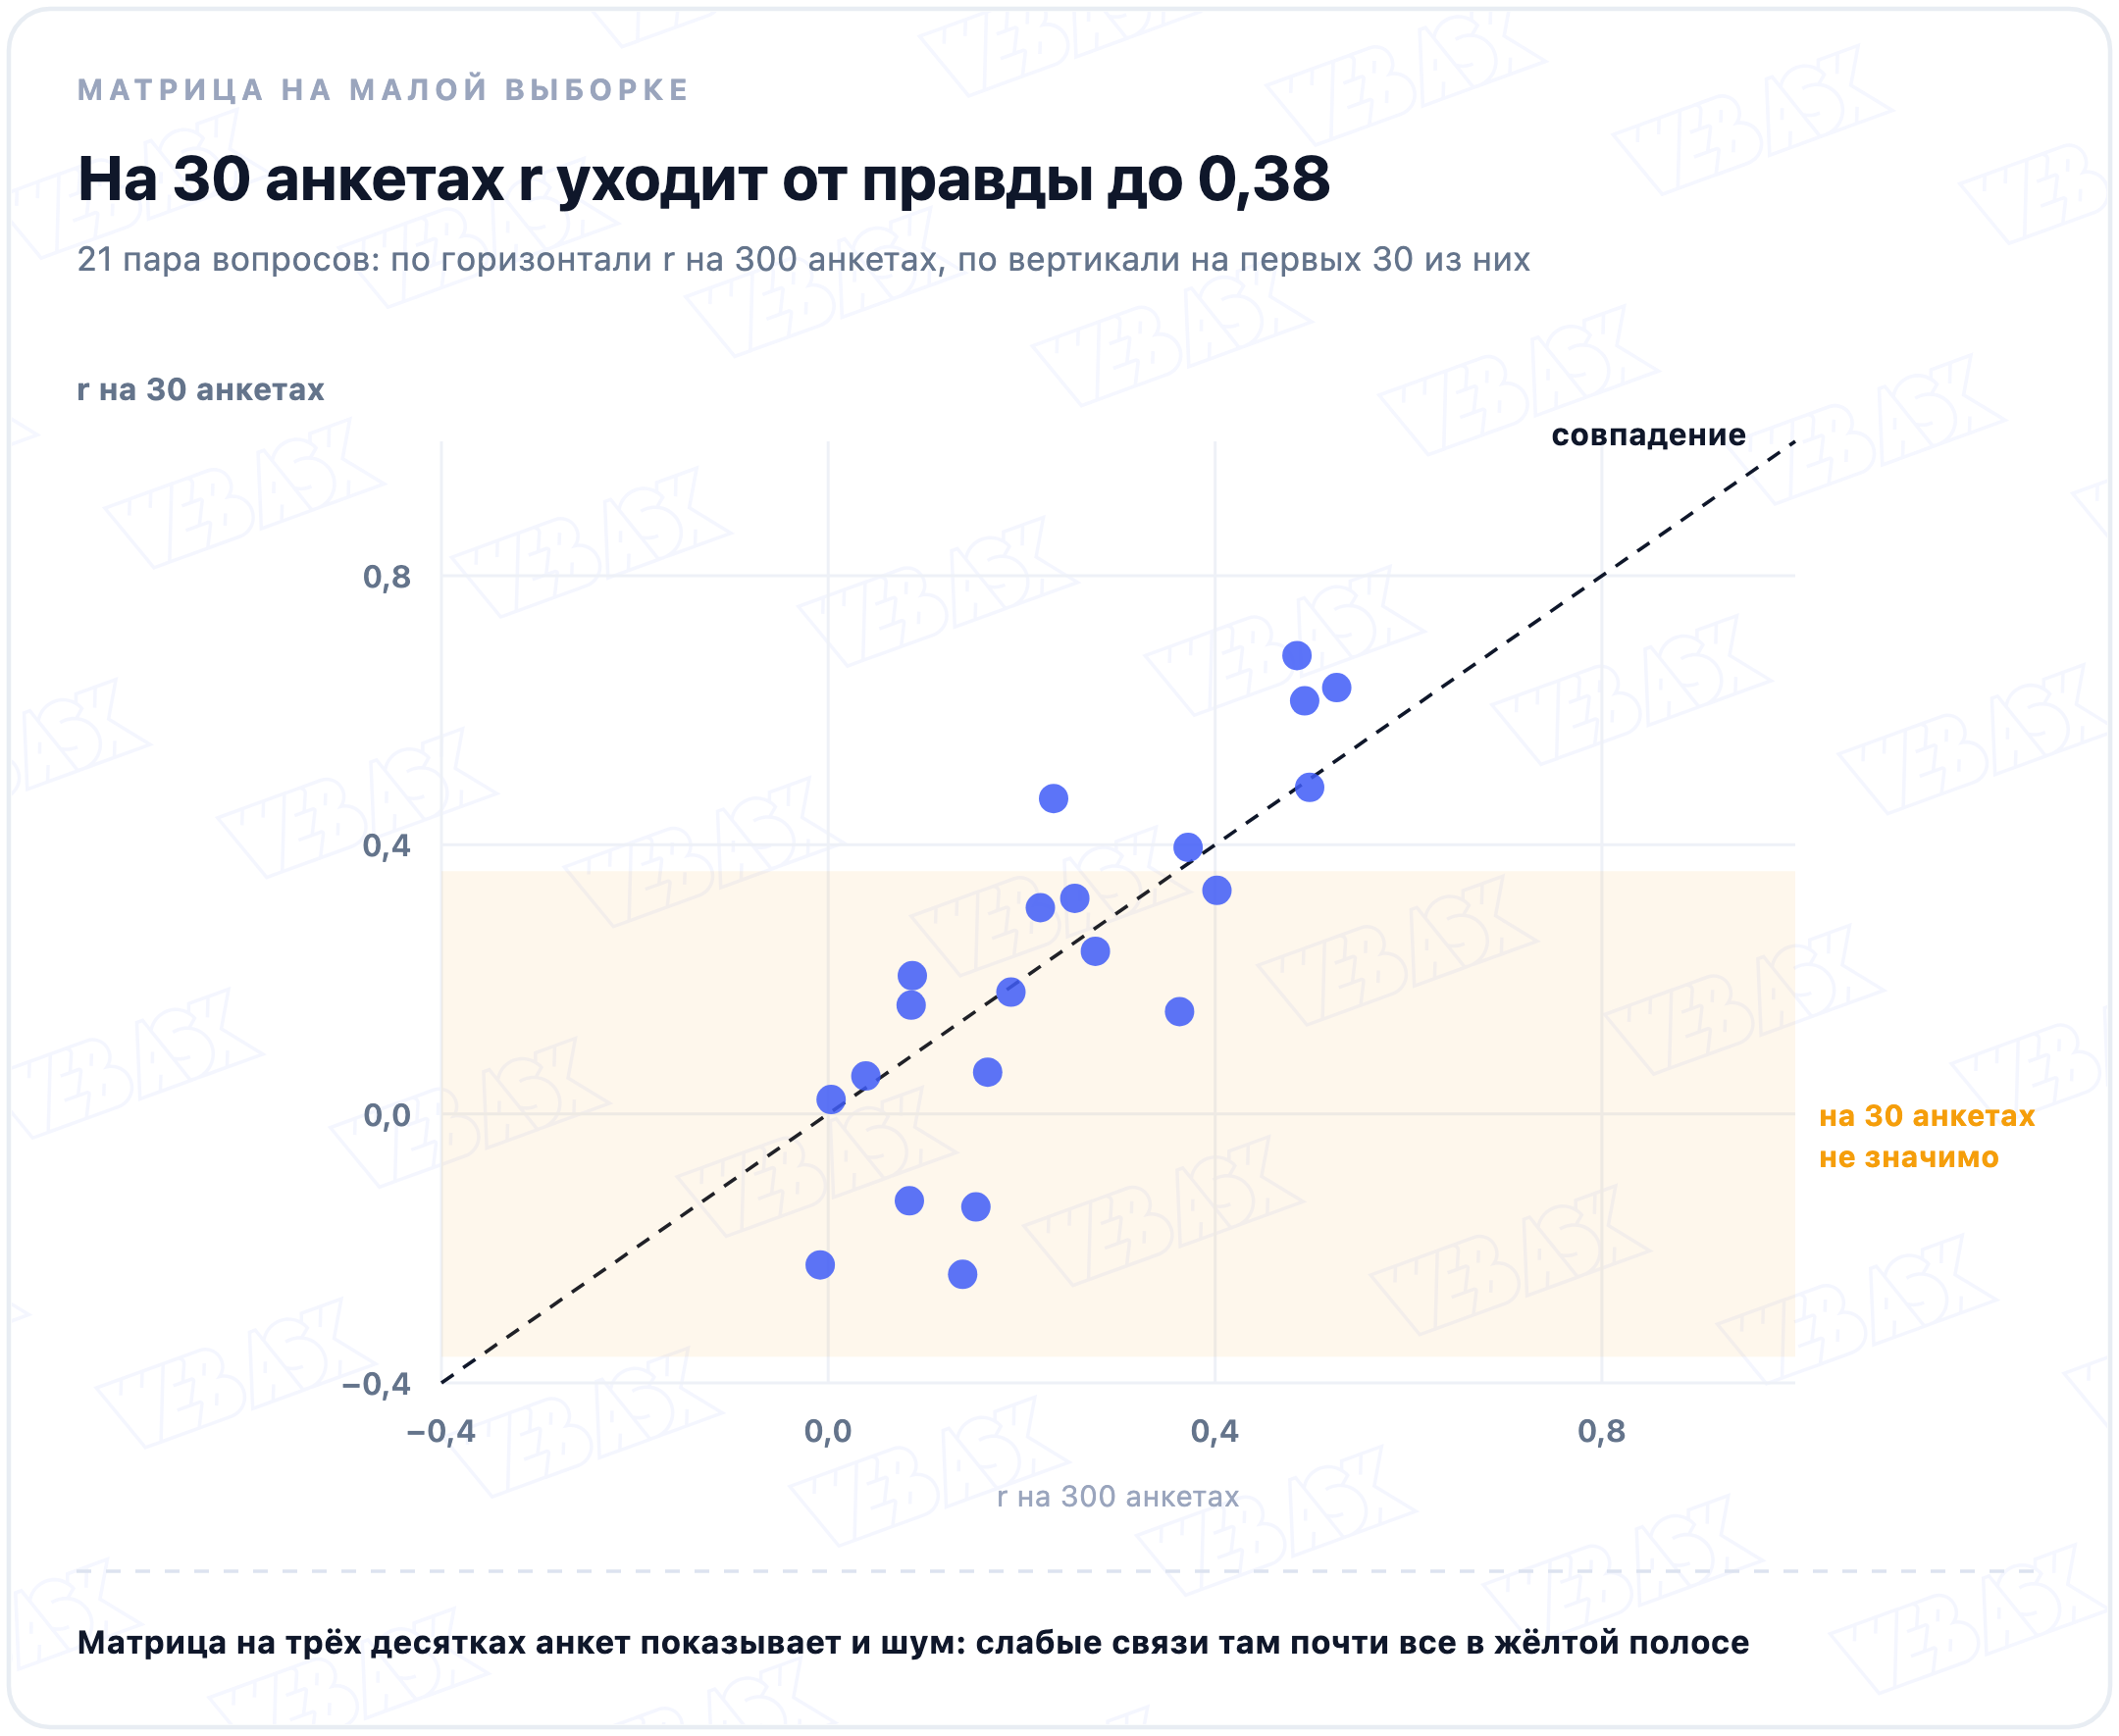
Самое большое расхождение 0,38: на всей выборке связь слабая, на тридцати анкетах она выглядит заметной. При тридцати ответах значимой считается корреляция больше 0,36 по модулю, при трёхстах уже больше 0,11. На малой выборке 15 пар из 21 неотличимы от нуля, хотя 9 из них на полной выборке значимы.
Второй источник шума в числе клеток. В матрице на 21 пару при пороге 0,05 одна «значимая» связь в среднем найдётся и без всякой причины. Если по матрице делают выводы о конкретных парах, порог правят поправкой Бонферрони. А если анкет всего несколько десятков, всерьёз принимают только связи заметно выше порога, остальное проверяют на следующей волне опроса.
Строка итоговой оценки и анализ драйверов
Если в анкете есть общий вопрос вроде «В целом доволен работой», его строка в матрице превращается в черновой рейтинг: какие частные вопросы сильнее связаны с итогом.
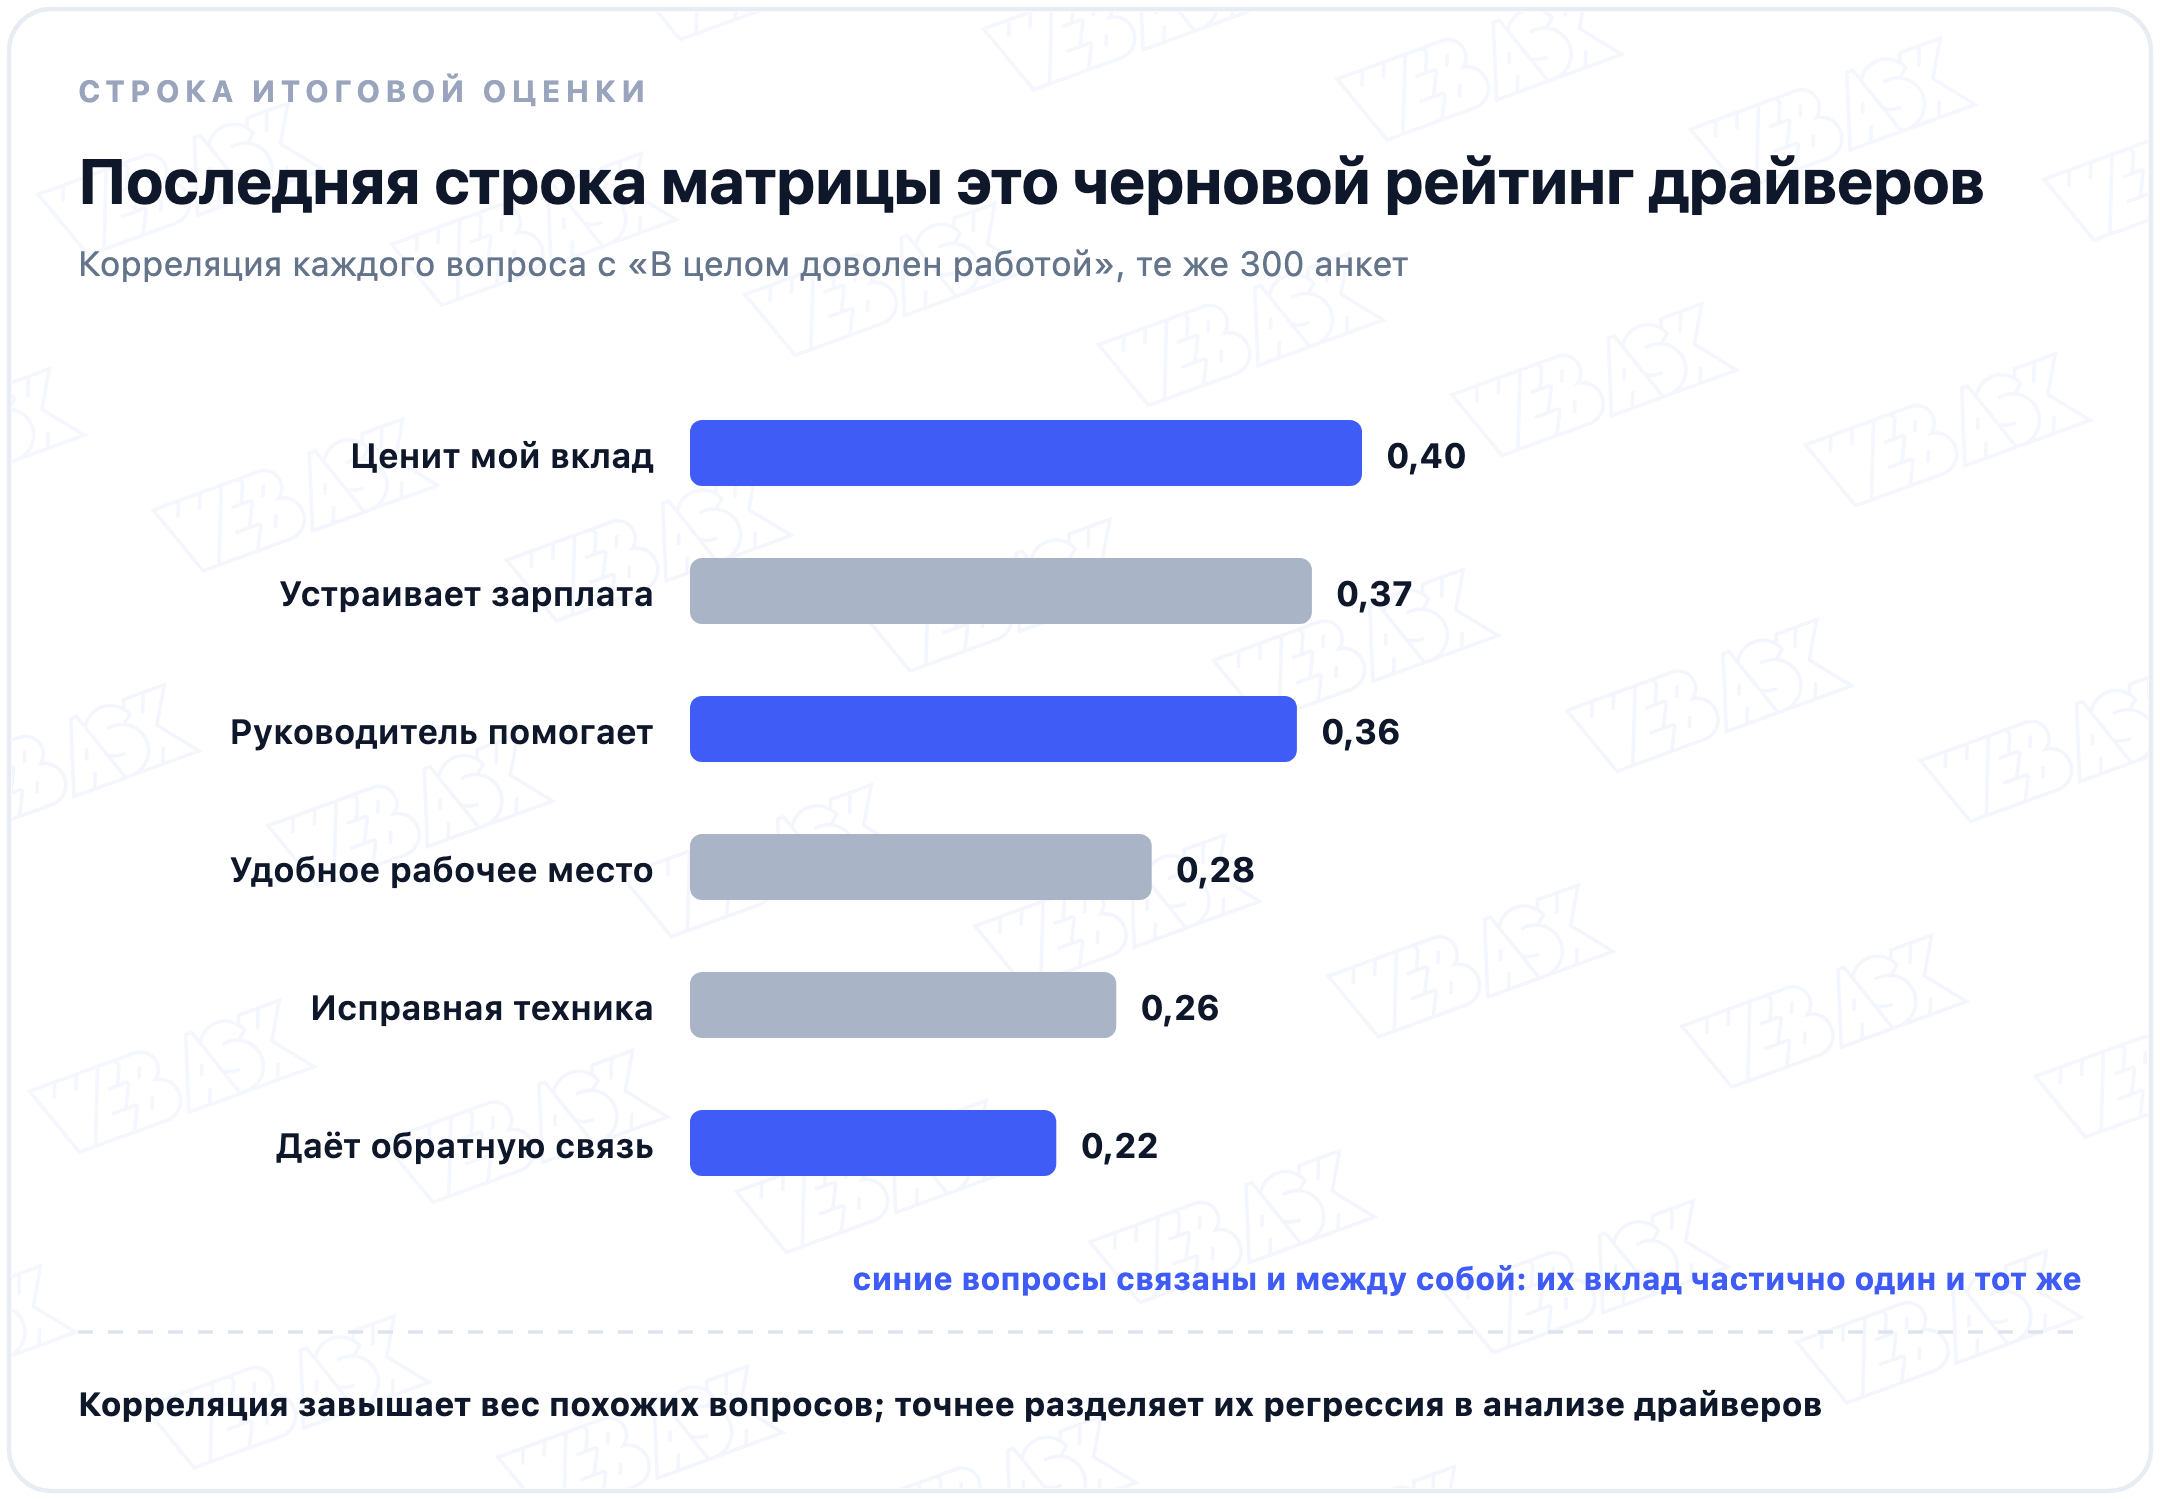
Ловушка в том, что три вопроса о руководителе связаны и друг с другом. Их высокие корреляции с итогом во многом отражают одно и то же, и сумма их «важности» завышена. Разделить вклад помогает регрессия, где каждый вопрос оценивается за вычетом остальных; так устроен анализ драйверов вовлечённости.
Матрица заодно предупреждает о мультиколлинеарности. Если два предиктора связаны очень сильно, регрессия делит между ними вес почти случайно, и коэффициенты скачут от выборки к выборке. Один из таких вопросов лучше убрать или объединить с соседом.
Как построить корреляционную матрицу в Excel
Ответы лежат таблицей: анкета в строке, вопрос в столбце, в первой строке названия вопросов.
- Пакет анализа. «Файл» → «Параметры» → «Надстройки», в списке «Управление» выберите «Надстройки Excel», нажмите «Перейти» и отметьте «Пакет анализа».
- Корреляция. На вкладке «Данные» откройте «Анализ данных» и выберите «Корреляция». Укажите диапазон с заголовками и отметьте метки в первой строке.
- Цвет. Выделите получившуюся таблицу и включите условное форматирование с цветовой шкалой.
- Одна пара. Для двух столбцов хватит
=КОРРЕЛ(A2:A301;B2:B301).
Инструмент «Корреляция» считает только Пирсона и выдаёт нижний треугольник. Для Спирмена столбцы сначала переводят в ранги, а дальше строят ту же матрицу.
С пропусками нужна аккуратность. КОРРЕЛ пропускает пустые ячейки и текст, а ноль учитывает как ответ, поэтому «затрудняюсь ответить» в выгрузке должно остаться пустым, а не нулём. Если часть людей пропустила вопросы, программы считают пары либо только по полным анкетам, либо по всем, кто ответил на оба вопроса. Во втором случае у клеток разное число ответов, и это стоит указать под матрицей.
Как показать матрицу в отчёте
Для отчёта хватает одного треугольника без диагонали, а значения округляют до двух знаков: третий знак при сотнях анкет ничего не добавляет. Связанные вопросы ставят рядом, плюс красят одним оттенком, минус другим, без радуги. Под матрицей пишут, на скольких анкетах она посчитана.
Когда вопросов больше двадцати, числа в клетках уже не читаются. Тогда оставляют только цвет, а значимые клетки отмечают звёздочкой или рамкой. Если отчёт читает руководитель, а не аналитик, полезнее показать две-три сильные связи диаграммами рассеяния и строку итоговой оценки, чем всю таблицу.
Частые ошибки
- Вывод по одной яркой клетке. На тридцати анкетах она может оказаться шумом.
- Порядок вопросов как в анкете. Блоки разбросаны, и их не видно.
- Корреляция как важность. Похожие вопросы делят одну и ту же связь с итогом.
- Пирсон на перекошенной шкале. При сильном потолке ответов надёжнее Спирмен.
- Связь как причина. Матрица не говорит, что из чего следует.
Как это сделано в WebAsk
Ответы опроса выгружаются в Excel и CSV, и матрица строится по шагам выше. Для строки итоговой оценки есть анализ драйверов: в него загружают CSV, а он считает корреляцию каждого вопроса с целевой метрикой, стандартизованные коэффициенты регрессии и матрицу «важность × оценка». Для одной пары подойдёт калькулятор Пирсона.
Коротко
- Корреляционная матрица собирает коэффициенты для всех пар вопросов, обычно в виде треугольника.
- Читают её по блокам, переставив связанные вопросы рядом и раскрасив по силе связи.
- На 30 анкетах коэффициенты сдвигаются на десятые доли, значимы только |r| больше 0,36.
- Строка общего вопроса даёт черновой рейтинг драйверов, но завышает вес похожих вопросов.
- В Excel матрицу строит «Пакет анализа», а связь вопросов с итогом в WebAsk считает анализ драйверов.
Вопросы и ответы
Что такое корреляционная матрица простыми словами?
Это таблица связей: строки и столбцы это вопросы или показатели, а в клетке коэффициент корреляции между ними. По ней сразу видно, какие показатели меняются вместе.
Как построить корреляционную матрицу в Excel?
Подключите «Пакет анализа», затем на вкладке «Данные» выберите «Анализ данных» и «Корреляция», укажите диапазон с заголовками. Excel выдаст нижний треугольник коэффициентов Пирсона.
Почему в корреляционной матрице на диагонали единицы?
На диагонали каждый показатель сравнивается сам с собой, а такая корреляция всегда равна 1. Поэтому диагональ ничего не сообщает.
Чем корреляционная матрица Пирсона отличается от матрицы Спирмена?
Пирсон меряет линейную связь самих значений, Спирмен связь их рангов. Для порядковых шкал и ответов с сильным перекосом Спирмен надёжнее.
Какой коэффициент брать для матрицы по шкале Лайкерта?
Для шкал 1–5 с заметным перекосом ответов надёжнее Спирмен. Если ответы распределены ровно, Пирсон обычно даёт близкие числа и проще считается в Excel.
Что значит отрицательное число в корреляционной матрице?
Что показатели меняются в разные стороны: один растёт, другой падает. В анкетах это часто след обратной формулировки вопроса, её перекодируют перед подсчётом индекса.
Сколько анкет нужно для корреляционной матрицы?
Чем больше, тем лучше. На 30 анкетах значимой считается корреляция больше 0,36 по модулю, и коэффициенты могут уйти от настоящих на десятые доли. С 300 анкет порог около 0,11.
Можно ли по корреляционной матрице найти главные драйверы?
Как черновой рейтинг да: строка общей оценки показывает, с чем она связана сильнее. Но похожие вопросы делят одну и ту же связь, и точнее их вклад разделяет регрессия в анализе драйверов.
Опубликовано 30 октября 2026